Final Exam 2024/2025
Pembahasan UAS IF3270 Pembelajaran Mesin Semester II 2024/2025. Ujian dilaksanakan pada 17 Juni 2025 dengan sifat individu, tutup buku, boleh membuka satu lembar A4 catatan tulisan tangan, dan boleh menggunakan kalkulator selain perangkat seluler.
#Link to this headingBagian I
Beri tanda lingkaran (O) pada setiap pilihan jawaban yang tepat, dan beri tanda silang (X) pada setiap pilihan jawaban yang salah! Pilihan yang tidak diberi tanda tidak mendapatkan nilai. (Nilai 30 @2.5)
#Link to this headingSoal 1
Terdapat spesifikasi arsitektur neural network “many-to-one” yang menerima input terdiri atas 3 fitur, sebuah hidden layer berupa RNN yang terdiri atas 4 neuron dengan 5 time-step, dan sebuah output layer yang terdiri atas dua neuron. Jika digambarkan dalam ‘unfolded network’ tanpa mengilustrasikan bias, maka arsitekturnya adalah sebagai berikut.
#Link to this headingSoal 2
Terdapat arsitektur neural network “many-to-many (equal input-output)”yang menerima dataset pasangan input-output sebagai berikut; sebuah hidden layer berupa RNN dengan 2 neuron dan 3 time-steps dengan fungsi aktivasi tanh, dan sebuah output layer dengan 1 neuron dan fungsi aktivasi sigmoid. Timestep dimulai dari t=1. Tabel pasangan input-output:
| Timestep | Input 1 | Input 2 | Input 3 | Output |
|---|---|---|---|---|
| 0.1 | 0.2 | 0.3 | 0.4 | |
| 0.4 | 0.5 | 0.6 | 0.5 | |
| 0.7 | 0.8 | 0.9 | 0.6 |
a. Untuk t=1, maka data inputnya adalah: <0.1, 0.2, 0.3>.
b. Untuk t=2, maka data inputnya adalah: <0.2, 0.5, 0.8>.
c. Jika bobot semua fitur input adalah 0.1, bobot semua bias dari input layer ke hidden layer adalah 0.1, semua bobot dari hidden neuron timestep t-1 ke timestep t adalah 0.2; dan nilai hidden neuron di t=1 adalah x; maka nilai neuron pertama di hidden layer t=2 adalah: tanh(0.40.1 + 0.50.1 + 0.6*0.1 + 0.2 * x + 0.1),
d. Jika bobot semua fitur input adalah 0.1, bobot semua bias dari input layer ke hidden layer adalah 0.1, semua bobot dari hidden neuron timestep t-1 ke timestep t adalah 0.2; dan nilai hidden neuron di t=1 adalah x; maka nilai neuron pertama di hidden layer t=2 adalah: tanh(0.20.1 + 0.50.1 + 0.8*0.1 + 0.2 * x + 0.1).
e. Jika semua bobot dari hidden neuron ke output layer adalah 0.3 dan semua bobot bias dari hidden layer ke output layer adalah 0.3; dan nilai hidden neuron di t=2 adalah z; maka nilai output di t=2 adalah: sigmoid(0.3z + 0.3z + 0.3).
#Link to this headingSoal 3
Terdapat spesifikasi arsitektur neural network sebagai berikut. Input terdiri atas 10 fitur. Hidden layer pertama adalah Simple RNN dengan enam neuron, hidden layer kedua adalah Simple RNN dengan lima neuron, hidden layer ketiga adalah Simple RNN dengan empat neuron, hidden layer keempat adalah dense layer dengan tiga neuron, dan sebuah output layer dengan dua neuron. Banyaknya parameter yang perlu dipelajari adalah:
a. 234
b. 225
c. 831
d. 148
e. 200
#Link to this headingSoal 4
Tentukan pernyataan yang benar dari pernyataan-pernyataan berikut ini.
a. Context Vector berusaha menangkap informasi dari hidden unit timestep terakhir pada Encoder, jadi kita tidak bisa memanfaatkannya pada arsitektur “one-to-many”.
b. Contect Vector hasil dari tahap encoder hanya digunakan oleh bagian Decoder timestep pertama saja.
c. Dalam arsitektur Encoder-Decoder, tidak ada input dari dataset pelatihan yang menjadi masukan untuk tahap Decoder.
d. Dalam arsitektur Encoder-Decoder “many-to-many” di mana panjang input mungkin berbeda dengan panjang output, output dari timestep sebelumnya menjadi masukan untuk Decoder.
e. Salah satu contoh pemanfaatan Encoder-Decoder dengan arsitektur “many-to-one” adalah menerima masukan berupa video dan menghasilkan teks kalimat penjelasannya (video captioning).
#Link to this headingSoal 5
Model estimasi jumlah penumpang satu bulan berikutnya dari suatu perusahaan transportasi dikembangkan berdasarkan time series data 10 tahun terakhir. Model dapat dikembangkan dengan model RNN berdasarkan data 3 bulan sebelumnya, tentukan kebenaran pernyataan berikut ini.
a. Arsitektur one-to-many tidak dapat digunakan.
b. Output layer dari model RNN ini memiliki satu neuron, sesuai untuk task regresi.
c. Jumlah timestep dari model RNN ini adalah 10.
d. Output akhir model berupa sequence 3 nilai.
#Link to this headingSoal 6
Mesin penerjemah mampu menerima teks bahasa sumber dan menghasilkan teks bahasa target. Jika mesin penerjemah dikembangkan dengan model RNN, tentukan kebenaran pernyataan berikut ini.
a. Arsitektur one-to-many atau many-to-one tidak dapat digunakan.
b. Output layer dari model RNN memiliki jumlah neuron sebanyak jumlah vocabulary unik bahasa sumber dari data latih.
c. Karena panjang input tidak sama dengan panjang output, model RNN tersebut dirancang untuk melakukan task sequence labeling.
d. Karena panjang input tidak sama dengan panjang output, diperlukan arsitektur many-to-many dengan output akhir berupa sequence vocabulary sesuai indeks nilai dari output layer setiap timestep.
#Link to this headingSoal 7
Model analisis sentimen teks dikembangkan berdasarkan kumpulan review teks yang telah berlabel positif atau negatif. Model dapat dikembangkan dengan model RNN, tentukan kebenaran pernyataan berikut ini.
a. Arsitektur many-to-one tidak dapat digunakan.
b. Output layer dari model RNN memiliki dua neuron sigmoid
c. Model RNN ini termasuk melakukan task regresi.
d. Output akhir dari model diambil dari output layer timestep terakhir.
#Link to this headingSoal 8
Manakah dari pernyataan berikut yang benar mengenai perbedaan memori antara RNN dan FFNN?
a. FFNN dapat menyimpan konteks waktu jika jumlah layer cukup banyak
b. RNN mampu mempelajari hubungan temporal dalam data
c. FFNN hanya mampu memetakan input ke output tanpa mengingat input sebelumnya
d. RNN dapat menyimpan informasi jangka pendek atau panjang tergantung arsitekturnya
#Link to this headingSoal 9
Bidirectional RNN (Bi-RNN) dibandingkan dengan RNN untuk ukuran arsitektur yang setara.
a. Bi-RNN menghasilkan keluaran pada output layer sejumlah dua kali keluaran RNN.
b. Bi-RNN memerlukan jumlah timestep setengah kali lipat jumlah timestep RNN.
c. RNN dan Bi-RNN keduanya memproses data masukan dari masa lalu ke masa depan.
d. Bi-RNN memiliki jumlah parameter lebih banyak daripada RNN.
#Link to this headingSoal 10
Manakah pernyataan yang benar mengenai Bi-RNN
a. Bi-RNN hanya cocok untuk data teks.
b. Hasil dari dua arah forward state dan backward state pada Bi-RNN digabungkan dengan cara penjumlahan.
c. Bi-RNN banyak digunakan pada persoalan sequence tagging, seperti sentiment analysis
d. Bi-RNN mengabaikan urutan data masukan.
#Link to this headingSoal 11
Dalam sequence labeling dengan LSTM, bagaimana cara umum mengonversi output hidden state menjadi label kelas?
a. Dengan membandingkan hidden state dengan semua input
b. Dengan menggunakan softmax layer setelah hidden state
c. Dengan menghitung rata-rata semua hidden state
d. Dengan fungsi aktivasi sigmoid di input
#Link to this headingSoal 12
Diberikan input sequence yang merepresentasikan token: X = [0.5, 0.3], [0.2, 0.1], [0.6, 0.8], dan target label sequence: Y = [B, A, C]. Digunakan model prediksi LSTM yang menghasilkan output berupa probabilitas per kelas seperti tabel berikut:
| Timestep | |||
|---|---|---|---|
| 1 | 0.2 | 0.7 | 0.1 |
| 2 | 0.3 | 0.1 | 0.6 |
| 3 | 0.6 | 0.2 | 0.2 |
Pernyataan yang benar adalah:
a. Banyaknya token yang diprediksi benar adalah dua token.
b. Akurasi hasil prediksi adalah 100%.
c. Prediksi kelas akhir untuk input sequence tersebut adalah .
d. Semua jawaban salah.
#Link to this headingBagian II
Tuliskan jawaban di bagian bawah soal ini atau di balik halaman ini.
- Diketahui LSTM sederhana dengan arsitektur input dan hidden layer seperti gambar. Perhatikan input matriks X dengan 2 fitur, nilai matriks weight U, W, dan bias b. Untuk penyederhanaan, target yang tercantum pada input matriks adalah untuk target pada hidden unit. Fungsi aktivasi yang digunakan sesuai default pada unit LSTM.
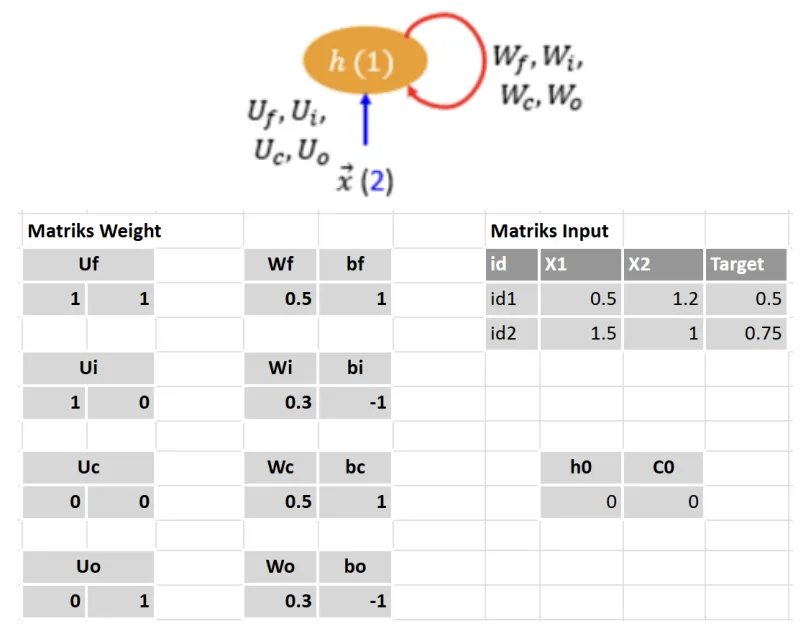
Data yang dipakai adalah sebagai berikut.
| Timestep | Target | ||
|---|---|---|---|
| 1 | 0.5 | 1.2 | 0.5 |
| 2 | 1.5 | 1.0 | 0.75 |
Nilai awal adalah dan . Bobot LSTM adalah sebagai berikut.
| Gate | |||
|---|---|---|---|
| Forget | 0.5 | 1 | |
| Input | 0.3 | 1 | |
| Candidate | 0.5 | 1 | |
| Output | 0.3 | 1 |
#Link to this headinga
Lakukan 1 kali forward pass, tuliskan nilai output pada hidden unit dari 2 time step. Hitung nilai error total dari tahap ini. Sertakan cara (formula) perhitungan lengkap untuk setiap gate dan neuron. (Nilai 10)
#Link to this headingb
Lakukan 1 kali backward pass (BPTT) dengan menggunakan hasil forward pass pada bagian a. Gunakan nilai learning rate 0.5. Tuliskan nilai matriks weight terbaru. Sertakan cara (formula) perhitungan lengkap untuk setiap gate dan neuron. (Nilai 10)
Catatan: untuk semua perhitungan, gunakan ketelitian tiga angka di belakang koma.
#Link to this headingBagian III
Diberikan arsitektur encoder decoder untuk prediksi sekuens 2 elemen deret, encoder menerima input berupa sekuens dengan panjang 3 timestep dari vektor 4 nilai fitur dan menghasilkan hidden vector e1, e2, dan e3. Decoder menerima input context vector untuk menghasilkan sequence 2 timestep yaitu y1 dan y2.
#Link to this headinga
[Nilai 5] Tentukanlah jumlah parameter dari model tersebut jika encoder berupa satu layer RNN dengan 2 neuron dan decoder berupa satu layer RNN dengan 2 neuron dan satu layer output Fully Connected 1 neuron.
#Link to this headingb
[Nilai 5] Tentukanlah jumlah parameter dari model tersebut jika encoder berupa satu layer LSTM dengan 2 neuron dan decoder berupa satu layer LSTM dengan 2 neuron dan satu layer output Fully Connected 1 neuron.
#Link to this headingc
[Nilai 5] Berikanlah formula untuk tahapan inferensi pada decoder dari model soal a. Gunakanlah f sebagai fungsi aktivasi untuk neuron pada hidden layer dan g sebagai fungsi aktivasi untuk neuron pada output layer.
#Link to this headingd
[Nilai 5] Tentukanlah jumlah parameter dari model tersebut jika encoder berupa satu layer RNN dengan 2 neuron dan decoder berupa satu layer RNN dengan 2 neuron dan satu layer output Fully Connected 1 neuron, dan dilengkapi dengan satu attention unit.
#Link to this headinge
[Nilai 5] Berikanlah formula untuk tahapan inferensi pada decoder dengan satu attention unit dari model soal d; ⍺t menyatakan attention weights pada timestep t. Gunakanlah f sebagai fungsi aktivasi untuk neuron pada hidden layer dan g sebagai fungsi aktivasi untuk neuron pada output layer.
#Link to this headingBagian IV
#Link to this headingSoal 1
Lengkapi tabel berikut ini, yang membandingkan antara supervised learning dan reinforcement learning. Jawaban yang dituliskan di luar tabel tidak dinilai. (Nilai 6)
| Aspek | Supervised Learning | Reinforcement Learning |
|---|---|---|
| Informasi yang diperlukan oleh agen pembelajar (pilih: pasangan aksi yang harus dilakukan dan kondisi tertentu/ informasi reward) | ||
| Hasil observasi yang dipelajari berupa data sekuensial (pilih: Ya/ Tidak/ Belum Tentu) | ||
| Apakah yang dipelajari oleh agen? Jawab dengan singkat. |
#Link to this headingSoal 2
Terdapat persoalan “Wumpus World” sebagai berikut. Setiap ruang memiliki koordinat posisi; misal dalam gambar agen di ruang (1,1); wumpus di ruang (3,1), gold berada di ruang (3,2); salah satu ruang berisi pit adalah ruang (1,3).
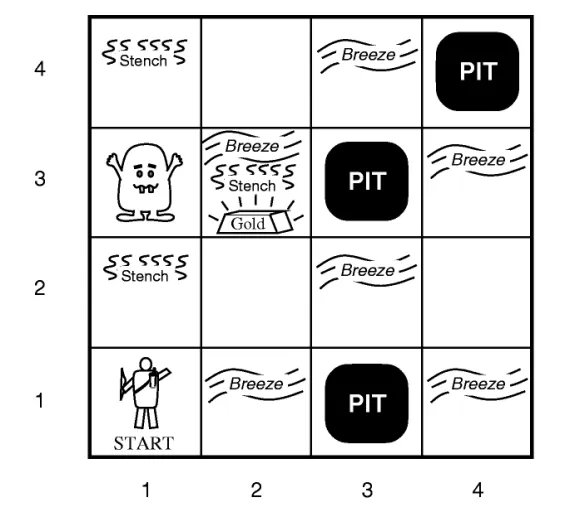
Agen diharapkan dapat mencapai ruang berisi gold dan tidak masuk ke dalam ruang berisi pit ataupun wumpus, dengan Reinforcement Learning (RL). Aksi agen hanyalah N (North), E (East), S (South), atau W (West). Informasi yang bisa diterima agen dari lingkungan hanyalah reward dan posisi ruang. Reward melakukan aksi pada suatu state untuk mencapai state lain adalah 0 (nol), kecuali aksi yang membuat agen berada di terminal-state. Ruang berisi wumpus, pit, dan gold adalah terminal-state. Reward menuju ruang berisi gold dari ruang yang bertetangga (selain terminal-state) adalah +10. Reward menuju ruang berisi wumpus atau pit dari ruang yang bertetangga (selain terminal-state) adalah -10. Setelah agen melakukan percobaan pemilihan aksi tiga episode sebagai berikut, tentukan aksi terbaik yang bisa dilakukan pada suatu ruang (selain terminal-state) berdasarkan nilai Q(s,a) hasil update terakhir dengan Temporal Difference Q-Learning. Inisialisasi semua nilai Q(s,a) dengan nilai nol (0). Nilai step (learning rate) 0.4 dan discount factor adalah 0.6.
Episode yang diberikan adalah sebagai berikut.
| Episode | Lintasan |
|---|---|
| I | |
| II | |
| III |
#Link to this headingi
Tuliskan ‘update’ nilai Q(s,a) dengan rinci sesuai episode yang dituliskan. (Nilai 12)
#Link to this headingii
Gambarkan grid dengan nilai update Q(s,a) untuk setiap satu episode. (Nilai 3)
#Link to this headingiii
Gambarkan aksi terbaik di setiap ruang selain terminal-state berdasarkan nilai Q(s,a) terakhir. (Nilai 4)