Midterm Exam 2025/2026
UTS IF3270 Pembelajaran Mesin, Semester II 2025-2026. Tanggal 6 April 2026, 11.00-12.40 WIB.
#Link to this headingBagian I: Perceptron
Bobot: 30
#Link to this headingSoal 1: Perceptron SGD
Diberikan data training yang mengandung 3 atribut masukan dan 1 atribut keluaran .
| 0 | 0.5 | 1 | 1 |
| 1 | 0.5 | 1 | 1 |
| 0.5 | 0 | 0.5 | 1 |
| 1 | 0 | 0.5 | 1 |
| 1 | 0.5 | 0 | 1 |
Dengan bobot awal s.d , learning rate , threshold , max iter , tuliskan proses pembelajaran untuk setiap iterasi untuk Perceptron dengan Stochastic Gradient Descent pada tabel. Gunakan 3 angka di belakang koma (maksimum).
Fungsi aktivasi: linear ()
Update rule , Error (kumulatif per iterasi)
#Link to this headingSoal 2: Pseudocode Batch Gradient Descent
Lengkapi algoritma pembelajaran Perceptron dengan Batch Gradient Descent menggunakan variabel .
#Link to this headingBagian II: Feed Forward Neural Network
Bobot: 40
#Link to this headingSoal A: Benar atau Salah
Tentukan pernyataan berikut BENAR atau SALAH, dan tuliskan alasannya. (Nilai 2 per soal)
| No | Pernyataan |
|---|---|
| 1 | Fungsi aktivasi pada FFNN adalah fungsi non-linear. |
| 2 | Konektivitas antar neuron pada FFNN bersifat lokal. |
| 3 | Nilai total cost pada FFNN dihitung pada fase backward propagation. |
| 4 | FFNN dapat menangkap fitur spasial dari data input. |
| 5 | Tujuan pelatihan pada FFNN adalah menghilangkan error. |
| 6 | Prinsip pelatihan dengan gradient descent adalah strategi pencarian hipotesis dengan menggunakan turunan error. |
| 7 | Salah satu kondisi berhenti pada algoritma Backpropagation adalah nilai error pada data validasi lebih kecil pada threshold. |
#Link to this headingSoal B: Essay
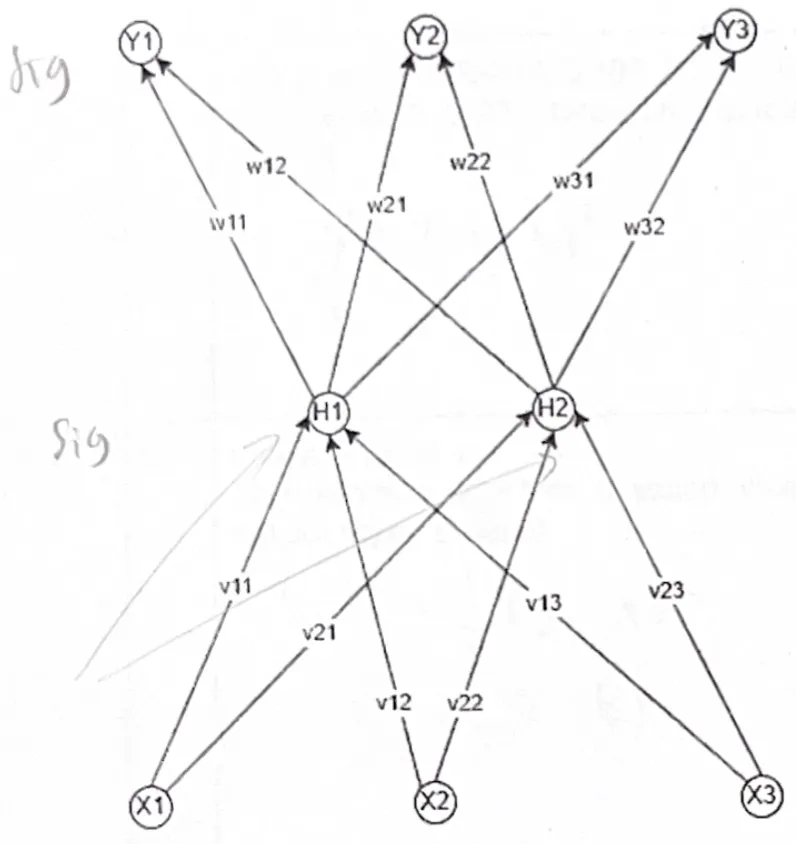
Diberikan vektor input dan target . Pelatihan menggunakan FFNN dengan arsitektur sesuai gambar. Fungsi aktivasi untuk neuron di hidden dan output layer adalah Sigmoid. Fungsi error adalah squared error. Learning rate .
Penamaan bobot menggunakan format , contoh artinya bobot ke output 1 dari hidden 2.
Bobot awal:
- (input ke H1)
- (input ke H2)
- (H1,H2 ke Y1: )
- (H1,H2 ke Y2: )
- (H1,H2 ke Y3: )
- Semua bias
Pertanyaan 1 (Nilai 3): Tentukan berapa banyak parameter yang perlu dipelajari berdasarkan arsitektur FFNN pada gambar.
Pertanyaan 2 (Nilai 3): Jika vektor input adalah , tentukan nilai output pada hidden neuron H2.
Pertanyaan 3 (Nilai 3): Lanjutkan soal 2 dengan menghitung nilai output pada output neuron Y2.
Pertanyaan 4 (Nilai 3): Jika output dan target , tentukan nilai total cost.
Pertanyaan 5 (Nilai 6): Lanjutkan soal 4. Tentukan nilai error term di setiap neuron pada output layer.
Pertanyaan 6 (Nilai 3): Jika output pada H2 , tentukan nilai error term di neuron H2 di hidden layer.
Pertanyaan 7 (Nilai 3): Lakukan update bobot untuk .
#Link to this headingBagian III: Convolutional Neural Network
Bobot: 30
Suatu model CNN dirancang untuk klasifikasi biner dengan arsitektur sebagai berikut.
- L0: input layer berukuran
- L1: hidden layer konvolusi dengan 2 kernel A dan B berukuran , stride , padding , detektor ReLU, pooling maksimum tanpa padding (stride ).
- L2: hidden layer konvolusi dengan 1 kernel C berukuran . Stride , padding . Detektor: ReLU. Pooling: maksimum , tanpa padding, stride .
Kernel C (bias 0.5) dengan Channel 1 dan Channel 2
- L3: satu neuron sigmoid pada output layer (bernama out). Bobot dari elemen ke- flatten vector ke output bernilai jika ukuran flatten vector ganjil, jika genap.
#Link to this headingSoal 1 (Bobot 5): Ukuran Feature Map L1 dan L2
#Link to this headingSoal 2 (Bobot 10): Jumlah Parameter (shared parameter = True)
#Link to this headingSoal 3 (Bobot 15): Forward Propagation
Data input :