Reinforcement Learning Exercises
Latihan Reinforcement Learning dari dokumen latihan IF3270 Pembelajaran Mesin. Fokus utama latihan ini adalah pembaruan nilai dengan SARSA dan TD Q-Learning pada Grid World.
#Link to this headingSoal 1
Diberikan Grid World dengan state terminal dan . Nilai-nilai pada suatu waktu ditunjukkan pada gambar berikut.
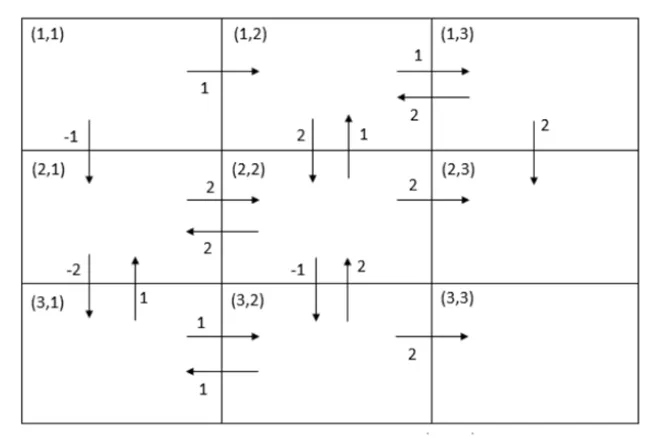
Episode berikutnya adalah sebagai berikut.
Dengan demikian, aksi yang dilakukan adalah sebagai berikut.
| State | Aksi | State berikutnya |
|---|---|---|
| R | ||
| D | ||
| R |
Reward bernilai 0 untuk semua aksi, kecuali nilai berikut.
Diberikan learning rate dan discount factor .
Hitung nilai untuk episode tersebut menggunakan SARSA.
#Link to this headingSoal 2
Berdasarkan state table terbaru hasil SARSA pada Soal 1, tuliskan optimal policy untuk setiap state.
#Link to this headingSoal 3
Hitung nilai untuk episode yang sama menggunakan TD Q-Learning.
#Link to this headingSoal 4
Berdasarkan state table terbaru hasil TD Q-Learning pada Soal 3, tuliskan optimal policy untuk setiap state.
#Link to this headingSoal 5
Jelaskan perbedaan hasil update SARSA dan TD Q-Learning pada langkah pertama episode.
#Link to this headingSoal 6
Tentukan apakah pernyataan berikut benar atau salah.
- SARSA memakai dari aksi berikutnya yang benar-benar dipilih.
- TD Q-Learning memakai pada state berikutnya.
- Jika state berikutnya adalah terminal, nilai masa depan dianggap 0.
- Pada contoh ini, update SARSA dan Q-Learning selalu menghasilkan nilai yang sama untuk semua langkah.
- Nilai discount factor menentukan seberapa besar kontribusi estimasi masa depan dalam update.