RNN Exercises
Latihan Recurrent Neural Network (RNN) dari kuis IF3270 Pembelajaran Mesin, April 2026.
#Link to this headingSoal 1
Perhatikan beberapa pernyataan berikut.
- Memiliki forward link
- Menggunakan sharing parameter
- Sharing parameter dilakukan melalui sequence
- Menangani aspek urutan pada data
Pernyataan yang benar tentang RNN adalah:
a. 1, 2, 3, 4
b. 1, 2, 3
c. 1, 2
d. 1
#Link to this headingSoal 2
Perhatikan beberapa pernyataan berikut.
- Data teks kalimat
- Data ucapan (speech)
- Sekuens data pada interval waktu yang seragam
- Sekuens kejadian pada interval waktu yang seragam
Contoh data yang dapat ditangani oleh RNN adalah:
a. 1, 2, 3, 4
b. 1, 2, 3
c. 1, 2
d. 1
#Link to this headingSoal 3
RNN bersifat neuron dependent, artinya:
a. sangat tepat digunakan untuk data sekuensial
b. hasil untuk setiap time step bergantung pada nilai hidden state timestep sebelumnya
c. memungkinkan penyaluran informasi antar neuron pada lapisan yang berdekatan
d. menggunakan forward dan backward link
#Link to this headingSoal 4
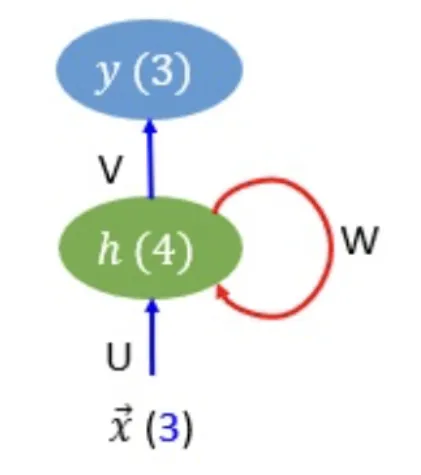
Pada RNN tersebut, ukuran matriks adalah:
a.
b.
c.
d.
#Link to this headingSoal 5
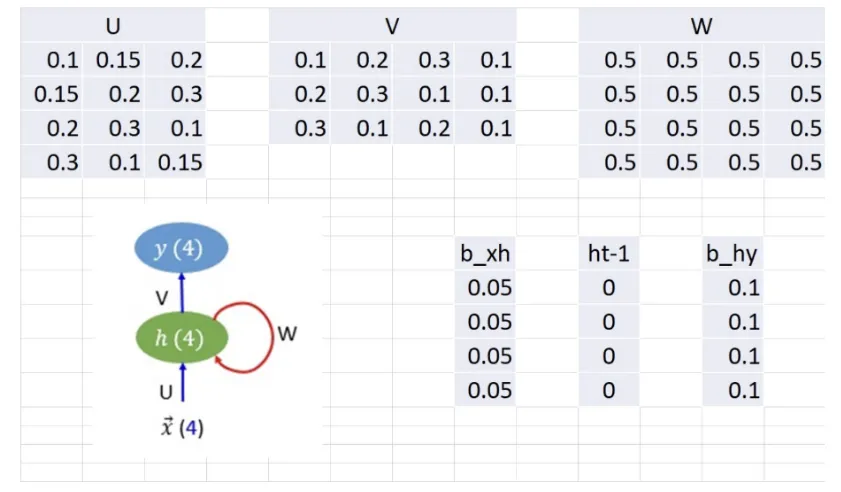
Berikut ini yang merupakan bagian dari matriks parameter untuk RNN di atas adalah:
a.
b.
c.
d.
e.
f.
#Link to this headingSoal 6
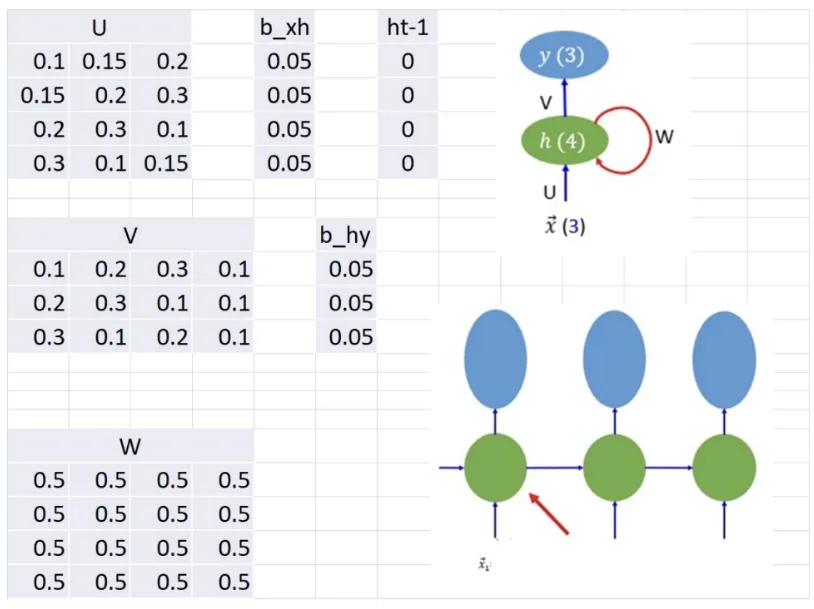
Pada RNN tersebut, jika , fungsi aktivasi hidden layer adalah tanh, dan output layer adalah softmax, maka nilai yang dihasilkan pada neuron yang ditunjuk tanda panah merah adalah:
a.
b.
c.
d.
#Link to this headingSoal 7
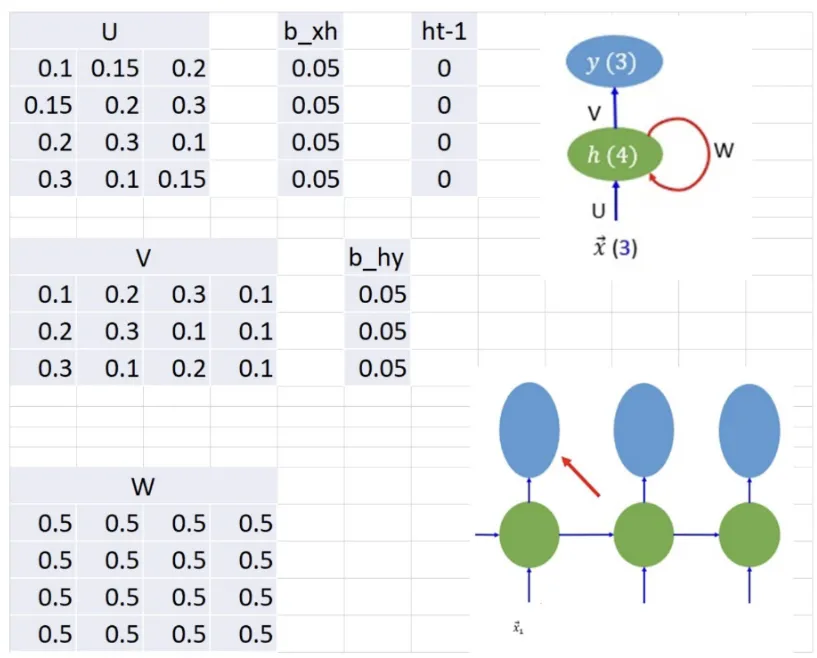
Pada RNN tersebut, jika , fungsi aktivasi hidden layer adalah tanh, dan output layer adalah softmax, maka nilai yang dihasilkan pada neuron yang ditunjuk tanda panah merah adalah:
a.
b.
c.
d.
#Link to this headingSoal 8
Pada task language model of character, alfabet yang digunakan adalah 'a', 'i', 'u', 'e', 'o'. Vektor output yang dihasilkan dari suatu vektor input adalah sebagai berikut.
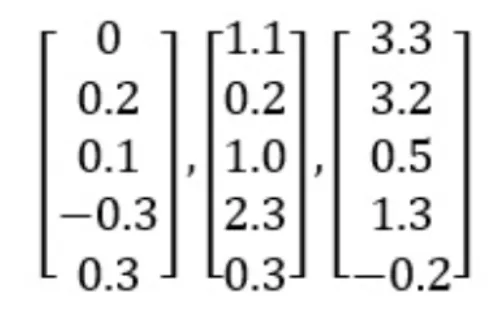
Karakter outputnya adalah:
a. 'a', 'i', 'u'
b. 'o', 'e', 'e'
c. 'e', 'i', 'o'
d. 'o', 'e', 'a'
#Link to this headingSoal 9
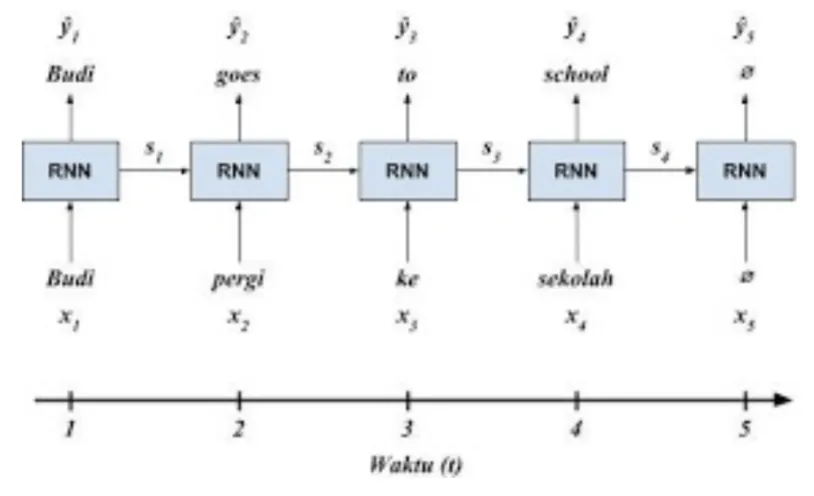
Jika s.d. adalah input kata dan adalah output kelas, maka arsitektur RNN tersebut adalah:
a. one-to-many
b. many-to-one
c. one-to-one
d. many-to-many
#Link to this headingSoal 10
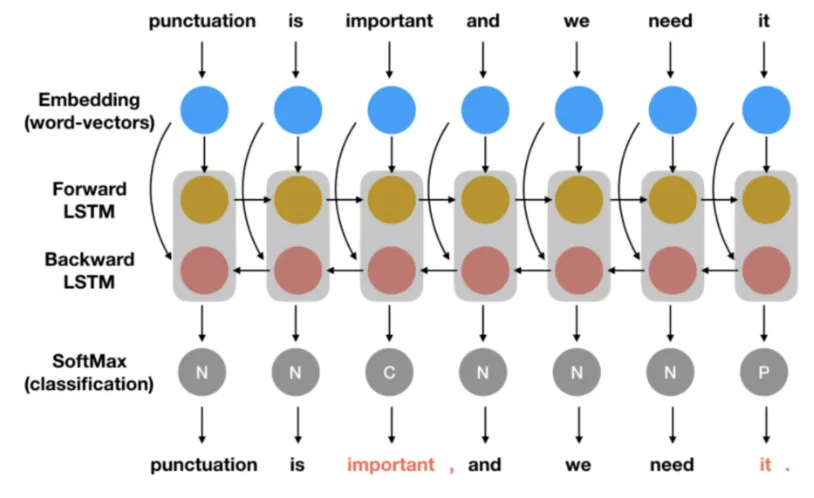
RNN untuk pembangkitan tanda baca tersebut menggunakan arsitektur:
a. one-to-many
b. many-to-one
c. one-to-one
d. many-to-many
#Link to this headingSoal 11
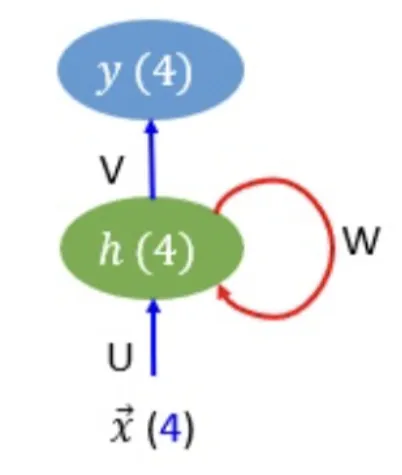
Jumlah parameter pada RNN tersebut adalah (1 buah bias pada layer hidden dan output):
a. 29
b. 44
c. 56
d. 80
#Link to this headingSoal 12
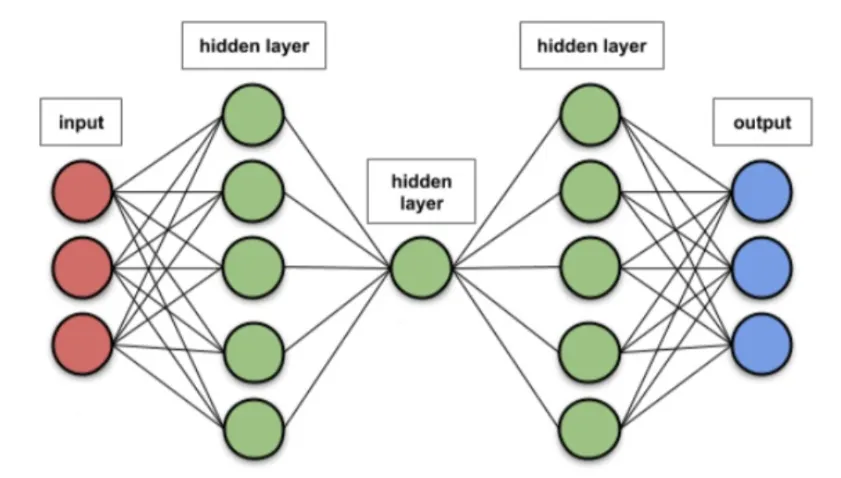
NN berikut menggunakan Simple RNN pada ketiga hidden layer-nya dengan jumlah neuron pada setiap layer dari input s.d. output sebesar 3, 5, 1, 5, 3. Jumlah parameternya adalah (1 buah bias pada layer hidden dan output):
a. 15
b. 54
c. 75
d. 105
#Link to this headingSoal 13
Perhatikan beberapa pernyataan berikut.
- Bidirectional RNN pasti menggunakan 2 hidden layer
- Bidirectional RNN digunakan untuk task yang bergantung pada informasi dari bagian akhir data saja
- Bidirectional RNN melakukan forward link dan juga backward link
- Bidirectional RNN cocok untuk task yang menggunakan konteks urutan data secara utuh
Pernyataan yang benar tentang Bidirectional RNN adalah:
a. 1, 2
b. 3, 4
c. 1, 2, 3
d. 1, 2, 3, 4