Attention and Transformer
Attention adalah mekanisme yang membuat model dapat memilih bagian input yang paling relevan ketika menghasilkan output. Dalam model sekuens, attention muncul sebagai jawaban atas kelemahan encoder-decoder RNN yang memadatkan seluruh input ke satu context vector tetap.
#Link to this headingIntuisi Attention
Pada encoder-decoder tanpa attention, seluruh informasi input disimpan dalam satu vektor konteks. Untuk sekuens panjang, satu vektor ini menjadi bottleneck. Decoder harus menghasilkan seluruh output hanya dari ringkasan tunggal tersebut.
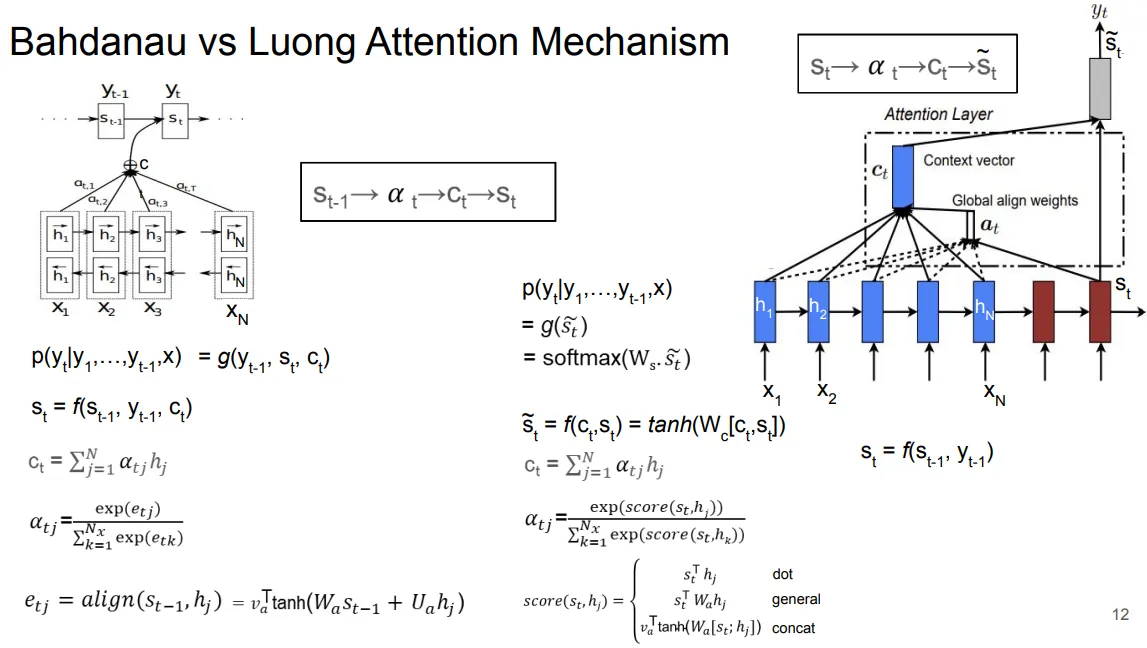
Bahdanau, Cho, dan Bengio mengusulkan agar decoder tidak membuang semua hidden state encoder. Semua hidden state digunakan kembali, lalu decoder belajar memberi bobot lebih besar pada state yang relevan untuk output saat ini. Figure 1 pada paper Bahdanau menggambarkan decoder yang menghasilkan target word dengan memperhatikan semua anotasi encoder .
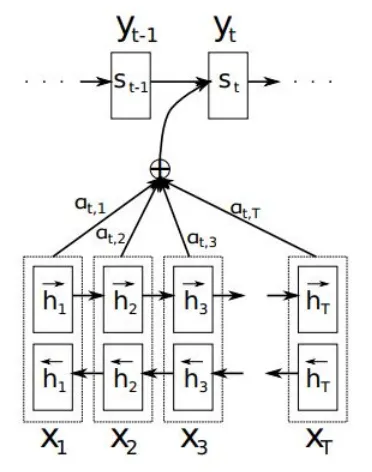
Secara intuitif, attention melakukan tiga hal.
- Menilai relevansi setiap hidden state encoder terhadap kebutuhan decoder.
- Mengubah skor relevansi menjadi bobot attention.
- Membentuk context vector sebagai kombinasi berbobot dari semua hidden state encoder.
Jika sebuah kata target bergantung kuat pada kata input tertentu, bobot attention pada posisi input tersebut akan lebih besar.
#Link to this headingMany-to-One dengan Attention
Pada RNN many-to-one biasa, output sering hanya bergantung pada hidden state terakhir. Attention mengubah hal ini dengan memberi akses ke semua hidden state masa lalu. Model tidak hanya memakai , tetapi membentuk konteks dari .
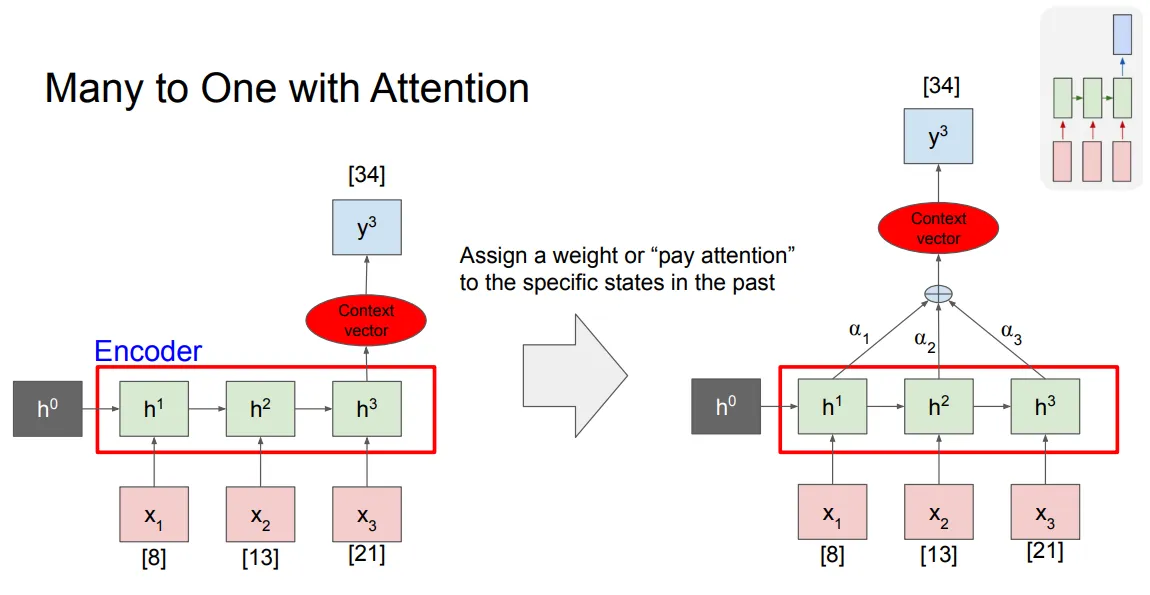
Misalkan terdapat timestep. Nilai attention untuk timestep dilambangkan dengan . Context vector dibentuk sebagai berikut.
Bobot attention biasanya dinormalisasi sehingga jumlahnya sama dengan 1.
Dengan begitu, dapat dibaca sebagai ringkasan adaptif dari seluruh sekuens. Kata adaptif penting karena ringkasan ini dipelajari dari data, bukan ditentukan manual.
#Link to this headingJumlah Parameter
Contoh pada slide menggunakan RNN many-to-one dengan 2 hidden unit, 1 unit dense, dan 20 timestep.
Tanpa attention, jumlah parameternya adalah sebagai berikut.
Dengan , , dan , diperoleh nilai berikut.
Dengan attention sederhana pada implementasi tertentu, terdapat parameter tambahan berupa bobot attention untuk setiap timestep dan bias attention. Pada contoh slide, tambahan parameternya adalah 20 bobot attention dan 2 bias.
#Link to this headingForward Propagation dengan Attention
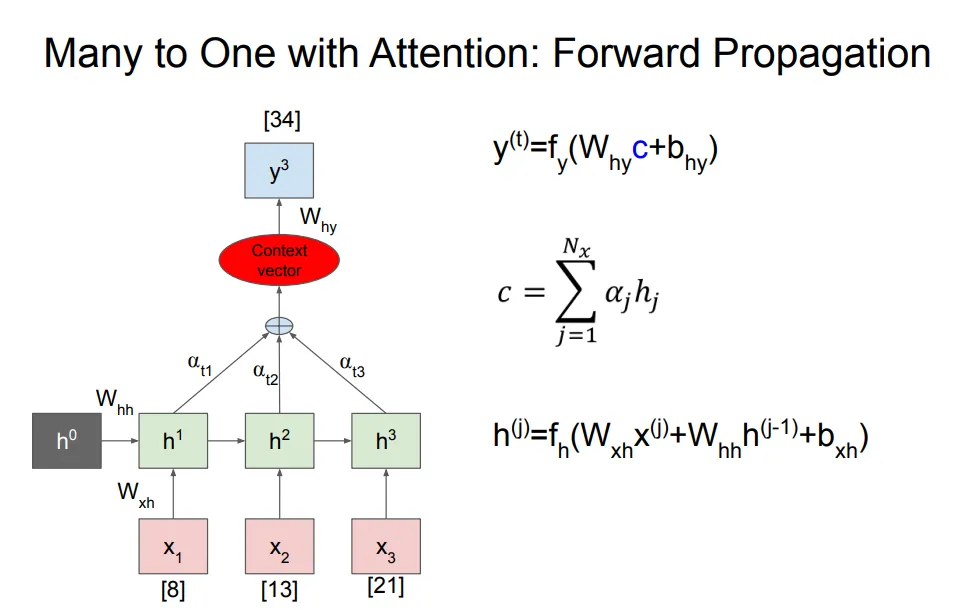
RNN tetap menghitung hidden state seperti biasa.
Perbedaannya muncul pada output. Tanpa attention, model many-to-one biasanya memakai hidden state terakhir.
Dengan attention, model memakai context vector.
Karena adalah kombinasi dari semua hidden state, output dapat memanfaatkan informasi yang muncul jauh sebelum timestep terakhir.
#Link to this headingMany-to-Many dengan Attention
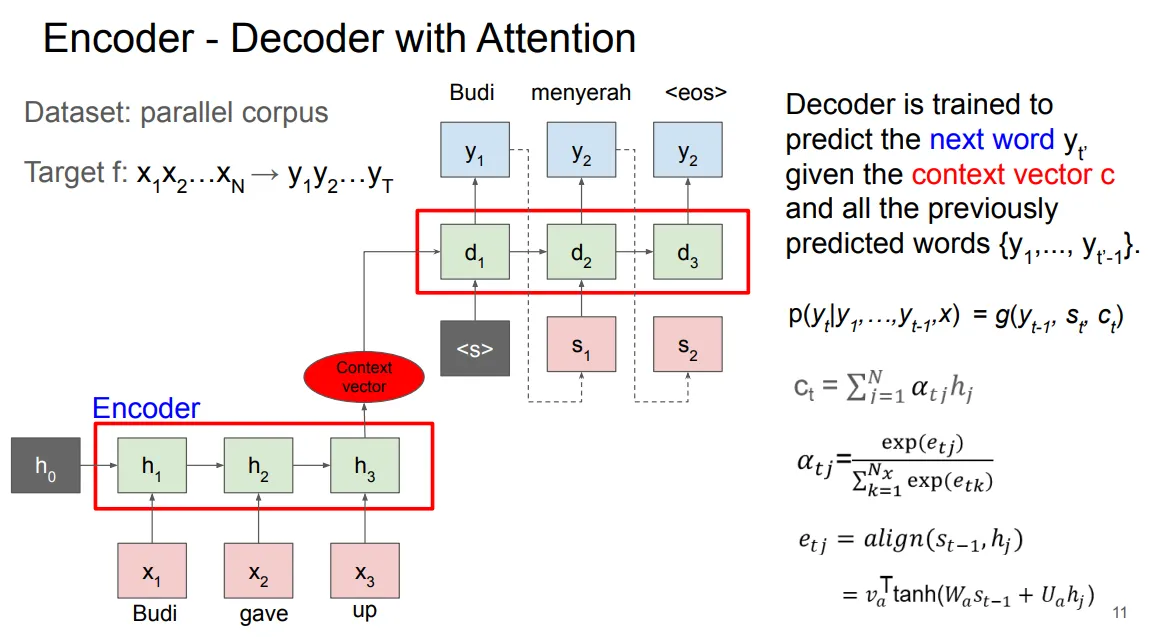
Pada encoder-decoder many-to-many, attention biasanya dihitung ulang pada setiap timestep decoder. Artinya, decoder dapat melihat bagian input yang berbeda ketika menghasilkan token output yang berbeda.
Jika encoder menghasilkan hidden state dan decoder menghasilkan token, bobot attention dapat ditulis sebagai , yaitu bobot attention dari decoder pada waktu terhadap encoder pada posisi .
Subskrip pada menunjukkan bahwa konteks berubah untuk setiap langkah decoder. Ini menjadi perbedaan penting dengan encoder-decoder lama yang hanya memiliki satu konteks tetap.
#Link to this headingBahdanau dan Luong Attention
Attention pada RNN umumnya memiliki tiga tahap. Pertama, model menghitung skor kecocokan antara decoder dan setiap hidden state encoder. Kedua, skor tersebut dinormalisasi menjadi bobot attention. Ketiga, bobot tersebut dipakai untuk membentuk context vector.
#Link to this headingNotasi
Catatan ini memakai konvensi yang sesuai dengan gambar kuliah sebagai berikut.
| Simbol | Arti | Dipakai untuk |
|---|---|---|
| Hidden state encoder pada posisi input ke- | Sumber informasi yang akan diperhatikan decoder | |
| Hidden state decoder pada timestep ke- | Memori internal decoder | |
| Attentional decoder state pada Luong | Gabungan antara dan sebelum output | |
| Token output sebelumnya, dipakai sebagai input decoder | Biasanya sebagai start token | |
| Output yang diprediksi pada timestep ke- | Token atau kelas yang keluar dari decoder | |
| Skor attention antara decoder timestep dan encoder posisi | Nilai mentah sebelum softmax | |
| Bobot attention terhadap encoder posisi pada timestep | Menentukan seberapa besar dipakai | |
| Context vector pada timestep decoder | Ringkasan encoder yang berubah untuk setiap output | |
| Fungsi aktivasi atau update state decoder | Menghasilkan state decoder berikutnya | |
| Fungsi output, misalnya softmax atau linear | Menghasilkan prediksi | |
| Probabilitas output saat ini | Dipakai untuk memprediksi token berikutnya |
Simbol bobot seperti , , dan adalah parameter yang dipelajari model.
| Parameter | Arti | Bentuk peran |
|---|---|---|
| Bobot attention untuk sisi decoder | Mengubah informasi decoder ke ruang skor attention | |
| Bobot attention untuk sisi encoder | Mengubah hidden state encoder ke ruang skor attention | |
| Vektor proyeksi attention | Mengubah hasil menjadi satu skor skalar | |
| Bobot dari token input decoder | Menghubungkan token input decoder ke state decoder | |
| Bobot recurrent decoder | Menghubungkan hidden state decoder sebelumnya ke state berikutnya | |
| Bobot context | Menghubungkan context vector ke state atau output decoder | |
| Bobot output | Mengubah state decoder menjadi prediksi output |
Perlu dibedakan antara memprediksi output dan melangkah ke timestep berikutnya. Prediksi output berarti menghitung dari state decoder saat ini. Melangkah ke timestep berikutnya berarti output sebelumnya, misalnya , menjadi masukan untuk menghitung state berikutnya.
Secara umum, alur satu timestep decoder adalah sebagai berikut.
- Pakai informasi decoder saat ini atau sebelumnya untuk menghitung skor attention terhadap setiap .
- Ubah skor menjadi bobot dengan softmax.
- Bentuk context vector .
- Hitung state decoder dan output.
- Gunakan output tersebut sebagai masukan timestep berikutnya.
#Link to this headingBahdanau Attention
Bahdanau attention disebut additive attention karena skor attention dihitung dengan menjumlahkan transformasi decoder dan encoder sebelum dilewatkan ke .
Skor dihitung dengan fungsi align.
Salah satu bentuk yang umum dipakai adalah sebagai berikut.
Bagian yang membuatnya disebut additive adalah penjumlahan berikut.
Bobot attention diperoleh dengan softmax terhadap semua skor encoder.
Kemudian konteks dibentuk dari semua hidden state encoder.
Setelah context vector tersedia, state decoder diperbarui dengan memasukkan secara langsung ke dalam pembaruan state. Ini menjadi ciri khas Bahdanau karena skor attention dihitung menggunakan state sebelumnya , sehingga konteks dapat ikut membentuk state terbaru.
Output diprediksi dari state decoder yang sudah mengandung konteks.
Jadi pada Bahdanau, urutannya adalah: hitung skor memakai , bentuk , update , lalu prediksi . Setelah itu, dipakai sebagai input decoder pada timestep berikutnya.
#Link to this headingLuong Attention
Luong attention memakai ide yang mirip, tetapi state decoder biasanya dihitung terlebih dahulu tanpa context vector. Setelah itu, attention dihitung menggunakan .
Fungsi skornya sering ditulis sebagai .
Beberapa varian skor Luong yang umum adalah dot, general, dan concat.
Varian dot dan general disebut multiplicative karena skor dihitung lewat perkalian vektor atau matriks.
Setelah terbentuk, Luong menggabungkan context vector dan state decoder menjadi attentional state .
Output diprediksi dari attentional state.
Jadi pada Luong, urutannya adalah: update dahulu, hitung skor memakai , bentuk , gabungkan dan , lalu prediksi . Setelah itu, dipakai sebagai input decoder pada timestep berikutnya.
#Link to this headingPerbandingan Alur
Tabel berikut merangkum alur satu timestep secara end-to-end. Perhatikan bahwa adalah token input decoder, sedangkan adalah hidden state decoder.
| Urutan | Bahdanau | Luong |
|---|---|---|
| 1. Input decoder | Menerima dan state lama | Menerima dan state lama |
| 2. State untuk skor | Skor attention memakai state lama | State baru dihitung dulu dengan |
| 3. Bentuk skor | atau | |
| 4. Jenis skor | Additive karena ada sebelum | Multiplicative untuk dot dan general karena memakai perkalian dengan |
| 5. Bobot attention | ||
| 6. Context vector | ||
| 7. State yang dipakai output | Context masuk saat update state, yaitu | Context digabung setelah terbentuk, yaitu |
| 8. Prediksi output | ||
| 9. Lanjut timestep | dipakai sebagai input pada timestep berikutnya | dipakai sebagai input pada timestep berikutnya |
Jika sudah tersedia, bagian skor sudah tidak perlu dihitung. Namun perbedaan cara memasukkan context ke decoder dan penentuan masih berlaku: Bahdanau menghitung dari , sedangkan Luong menghitung dari .
#Link to this headingOutput dan Timestep
Prediksi output dan perpindahan timestep sering tertukar, padahal keduanya berbeda.
| Proses | Makna | Contoh |
|---|---|---|
| Prediksi output | Menghasilkan token pada timestep sekarang | |
| Menaikkan timestep | Memakai output sekarang sebagai input langkah berikutnya | dipakai sebagai pada timestep berikutnya |
| Attention | Memilih bagian encoder yang relevan untuk output saat ini |
Contoh pada bentuk seperti soal Bagian 3 adalah sebagai berikut.
| Timestep | Input decoder | Context attention | State decoder | Output |
|---|---|---|---|---|
| Awal | Belum ada output sebelumnya | Context tetap dari encoder dapat menjadi | Belum ada | |
| Jika ada attention, | ||||
| Jika ada attention, |
Dengan kata lain, attention membantu decoder menentukan informasi input mana yang penting untuk memprediksi . Setelah diprediksi, decoder bergerak ke timestep berikutnya dan memakai output sebelumnya sebagai salah satu masukan.
#Link to this headingDari Attention ke Transformer
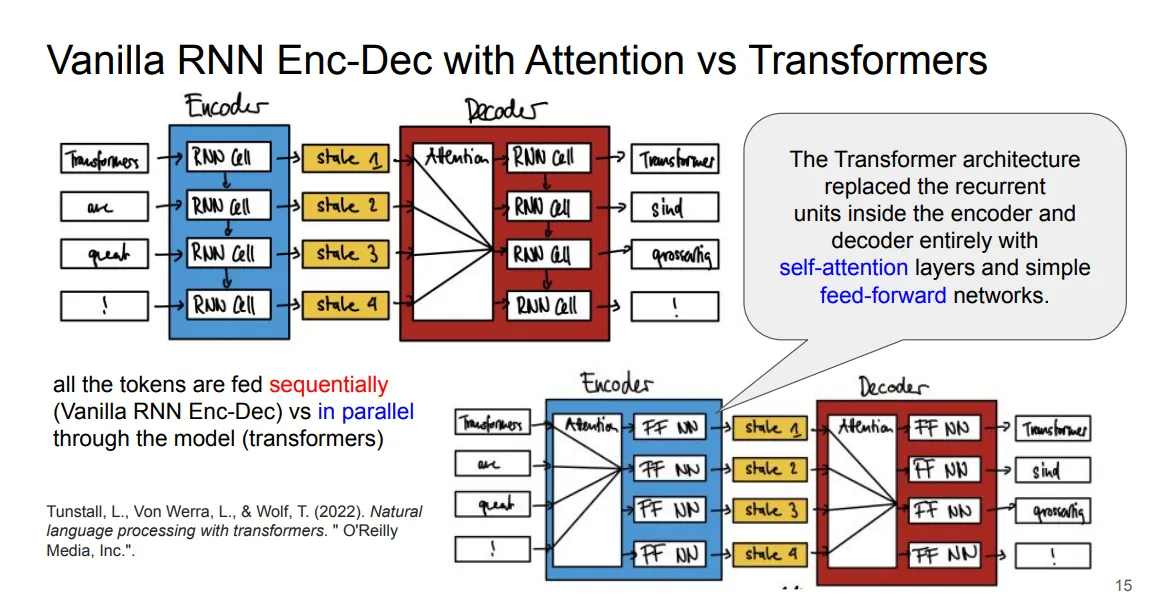
Attention awalnya dipakai sebagai komponen tambahan pada RNN encoder-decoder. Transformer mengambil langkah yang lebih radikal. Arsitektur ini menghapus unit rekuren dan konvolusi, lalu menggantinya dengan self-attention dan jaringan feed-forward sederhana.
Perubahan ini penting karena pemrosesan paralel membuat pelatihan pada korpus yang sangat besar menjadi jauh lebih efisien. Selain itu, self-attention memberi jalur langsung antarposisi token sehingga dependensi panjang lebih mudah dimodelkan dibandingkan RNN biasa.
#Link to this headingDot Product Self-Attention
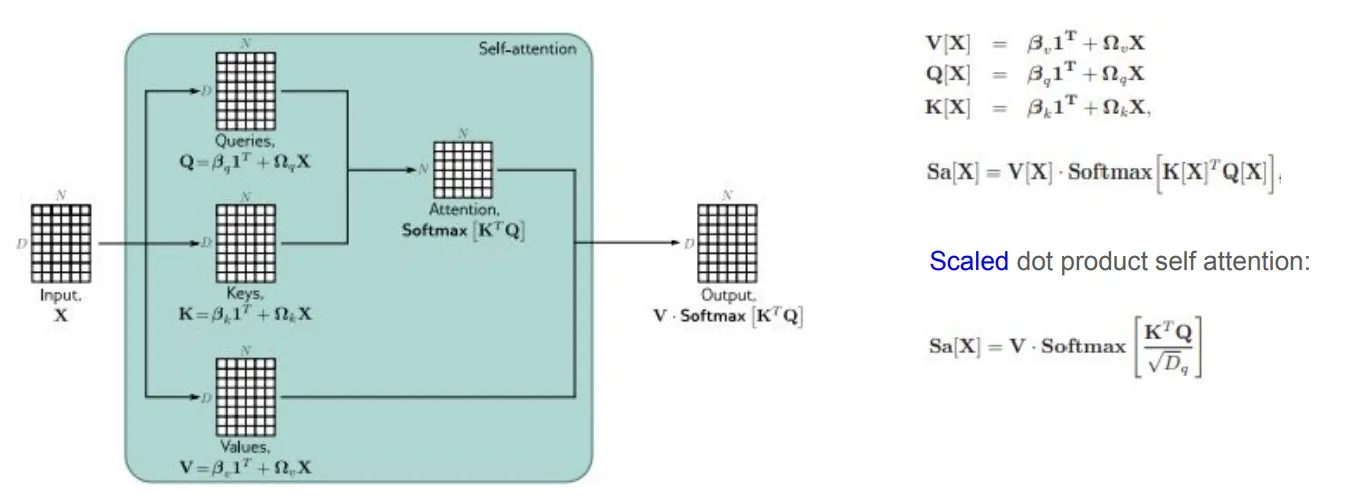
Pada attention RNN, query biasanya berasal dari decoder dan key serta value berasal dari encoder. Pada self-attention, query, key, dan value berasal dari input yang sama, tetapi melalui transformasi linear yang berbeda.
Untuk setiap token input , model membentuk tiga vektor berikut.
Query digunakan untuk bertanya, key digunakan untuk mengukur kecocokan, dan value adalah informasi yang akan digabungkan.
Skor attention antara token dan token dihitung dengan dot product.
Skor tersebut dinormalisasi dengan softmax.
Output self-attention untuk posisi adalah kombinasi berbobot dari semua value.
#Link to this headingScaled Dot Product Attention
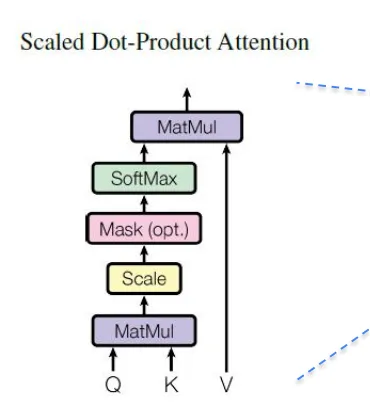
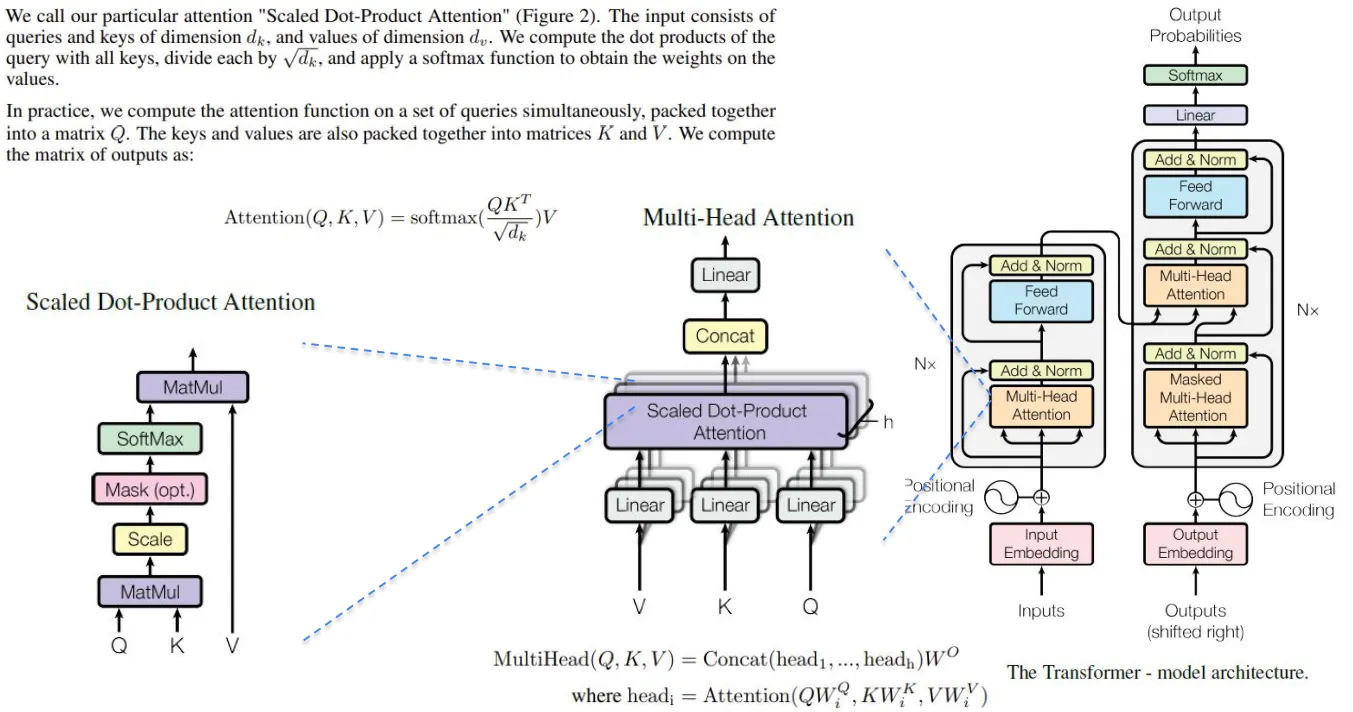
Transformer memakai scaled dot product attention. Jika query, key, dan value dikemas dalam matriks , , dan , attention dihitung dengan rumus berikut.
Faktor digunakan agar nilai dot product tidak tumbuh terlalu besar ketika dimensi key besar. Tanpa skala ini, softmax dapat menjadi terlalu tajam sehingga gradien lebih sulit mengalir.
Pada beberapa konvensi slide, formula ditulis dengan susunan matriks karena token disimpan sebagai kolom. Intinya tetap sama. Query dibandingkan dengan key, hasilnya dinormalisasi, lalu bobot tersebut dipakai untuk menggabungkan value.
#Link to this headingMulti-Head Attention
Satu attention head hanya belajar satu cara memandang hubungan antartoken. Transformer memakai beberapa head agar model dapat mempelajari beberapa pola relasi sekaligus.
Setiap head menghitung attention dengan proyeksi linear yang berbeda.
Hasil semua head digabungkan, lalu diproyeksikan kembali.
Dalam kalimat "the animal did not cross the street because it was tired", satu head dapat fokus pada "the animal" ketika memaknai "it", sedangkan head lain dapat fokus pada "tired". Representasi akhir token memadukan informasi dari beberapa pola perhatian.
#Link to this headingPositional Encoding
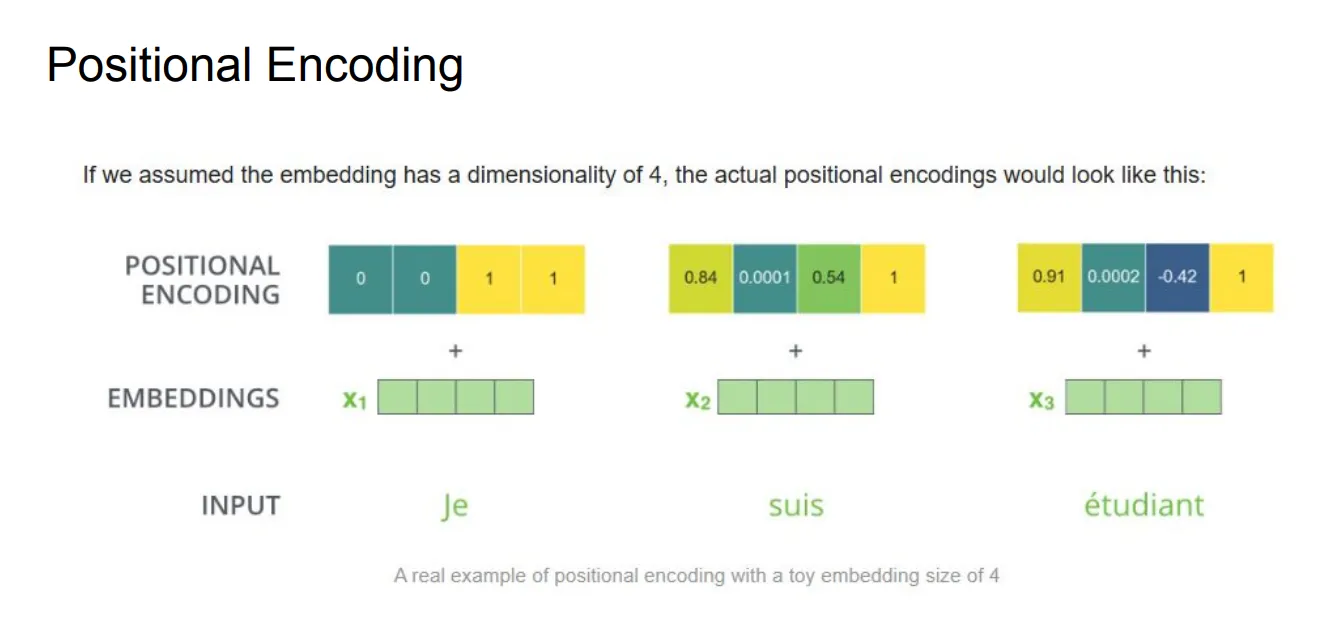
Karena Transformer tidak memproses token secara rekuren, urutan token tidak otomatis masuk ke model. Posisi token harus ditambahkan melalui positional encoding.
Representasi input Transformer biasanya berupa penjumlahan antara token embedding dan positional encoding.
Di sini adalah embedding token ke-, sedangkan adalah representasi posisi token ke-. Dengan cara ini, self-attention tetap mengetahui urutan token meskipun semua token diproses paralel.
#Link to this headingArsitektur Transformer
Arsitektur Transformer asli terdiri atas encoder stack dan decoder stack. Encoder menerima token input, sedangkan decoder menghasilkan token output secara autoregresif.
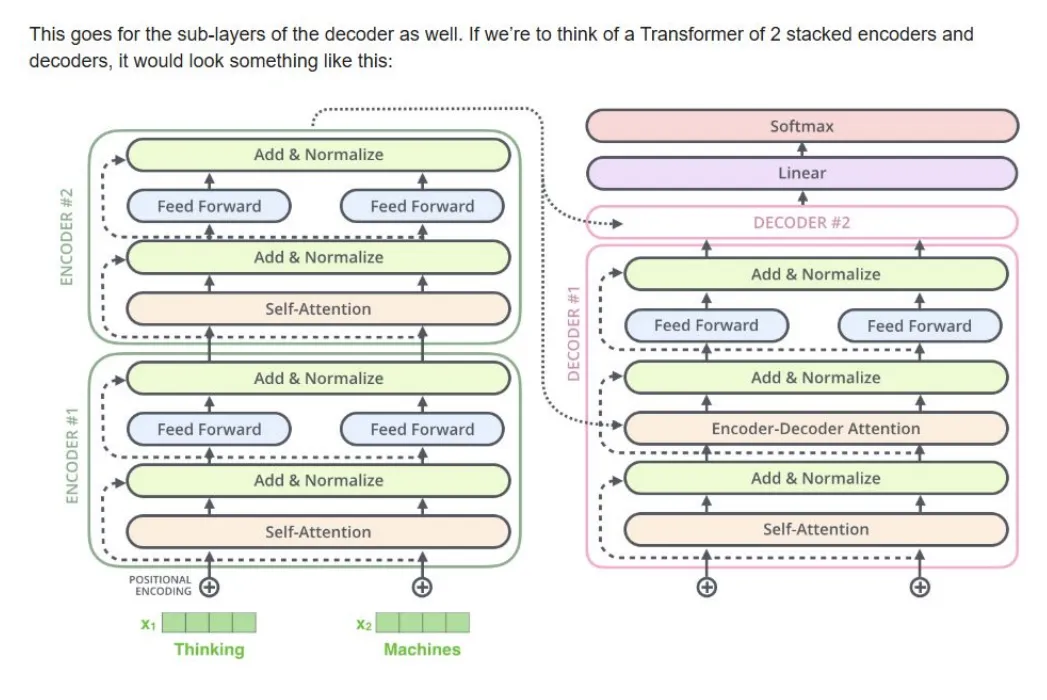
Encoder layer memiliki dua sublapisan utama.
- Multi-head self-attention.
- Feed-forward network posisi demi posisi.
Decoder layer memiliki tiga sublapisan utama.
- Masked multi-head self-attention agar decoder tidak melihat token masa depan.
- Multi-head attention terhadap output encoder.
- Feed-forward network posisi demi posisi.
Setiap sublapisan dilengkapi koneksi residual dan normalisasi, yang sering ditulis sebagai Add and Norm. Koneksi residual membantu gradien mengalir, sedangkan normalisasi membuat pelatihan lebih stabil.
#Link to this headingOutput Transformer
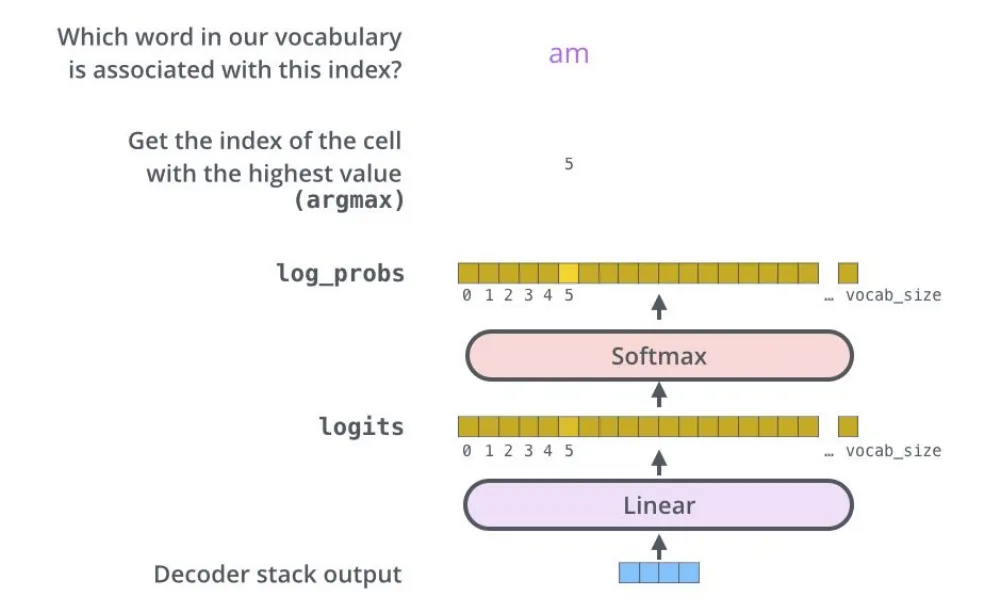
Output decoder stack masih berupa vektor representasi. Agar dapat menjadi kata, vektor ini diproyeksikan oleh linear layer ke ukuran kosakata. Hasil proyeksi disebut logits.
Jika kosakata berisi 10.000 kata, maka vektor logits memiliki 10.000 komponen. Softmax mengubah logits menjadi distribusi probabilitas. Kata dengan probabilitas tertinggi dipilih sebagai output pada timestep tersebut.
#Link to this headingRingkasan
Attention menyelesaikan masalah bottleneck pada encoder-decoder dengan membuat konteks yang bergantung pada kebutuhan output. Bahdanau dan Luong attention masih berada dalam keluarga RNN encoder-decoder. Transformer mengembangkan ide attention lebih jauh dengan self-attention penuh, pemrosesan paralel, multi-head attention, dan positional encoding.
Perubahan besar dari RNN ke Transformer adalah sumber memorinya. RNN membawa informasi melalui state berurutan, sedangkan Transformer menghubungkan semua token melalui attention. Karena itu, Transformer menjadi dasar banyak model modern untuk bahasa, visi, dan data multimodal.