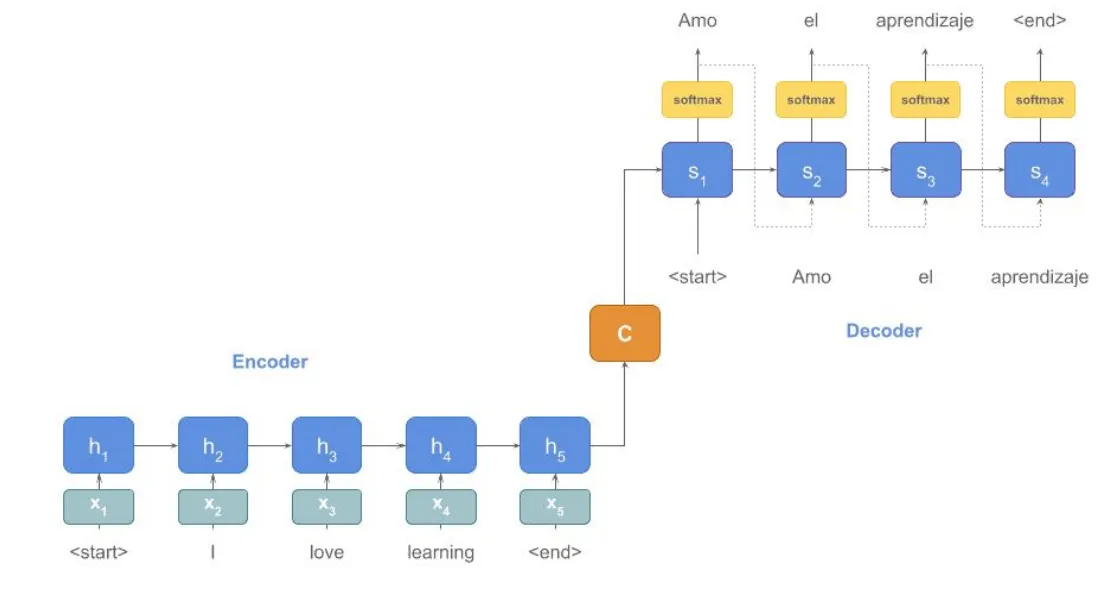
Recurrent Neural Network
Recurrent Neural Network (RNN) adalah arsitektur neural network yang dirancang untuk memproses data sekuensial dengan mempertahankan informasi dari timestep sebelumnya melalui koneksi rekuren.
#Link to this headingData Sekuensial
Pembelajaran mesin konvensional mengasumsikan data bersifat independent and identically distributed (IID), yaitu bahwa setiap contoh pelatihan bersifat saling independen dan urutan penyajiannya tidak relevan bagi model. Asumsi ini tidak berlaku ketika data membentuk suatu sekuens, karena urutan antardata menjadi bagian penting dari informasinya.
Data sekuensial (sequential data atau sequences) adalah data yang memiliki keterurutan, baik berdasarkan dimensi waktu maupun keterurutan logis lainnya. Data deret waktu (time series) merupakan jenis khusus data sekuensial di mana setiap contoh dikaitkan dengan dimensi waktu, misalnya harga saham dan rekaman suara. Tidak semua data sekuensial bersifat deret waktu. Teks dan sekuens DNA, misalnya, memiliki keterurutan yang jelas namun tidak dikaitkan dengan dimensi waktu.
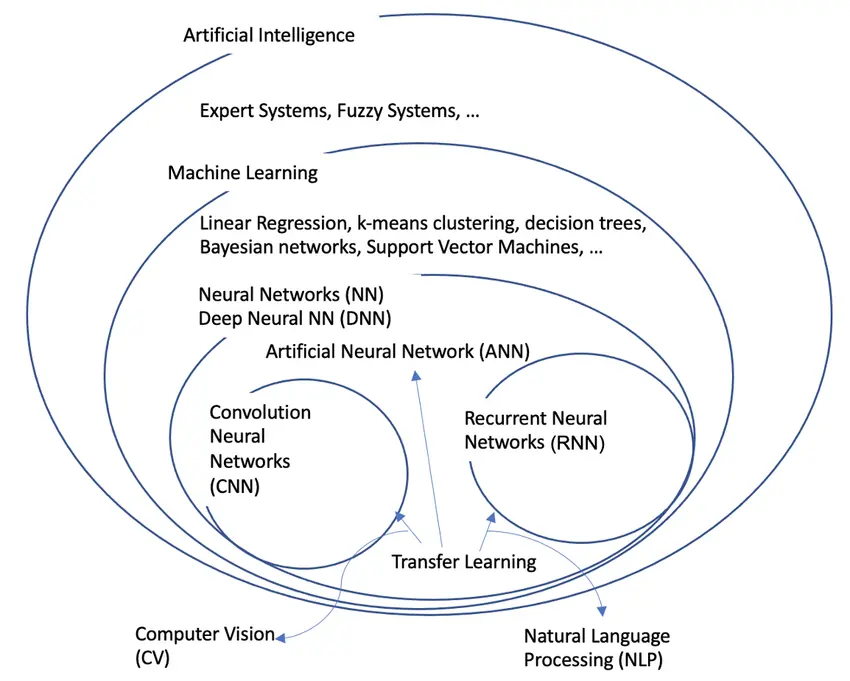
#Link to this headingKeterbatasan FFNN untuk Sekuens
Feed Forward Neural Network (FFNN) atau Vanilla Neural Network memiliki keterbatasan mendasar ketika berhadapan dengan data sekuensial.
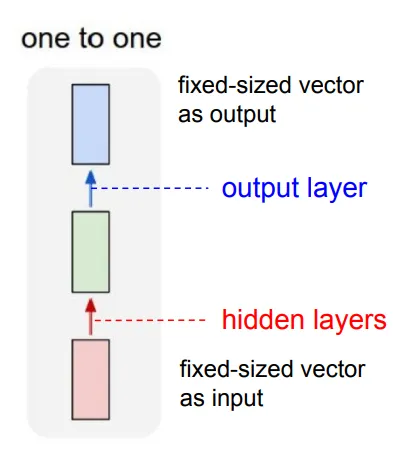
FFNN hanya menerima vektor berukuran tetap sebagai input dan menghasilkan vektor berukuran tetap sebagai output, menggunakan jumlah langkah komputasi yang tetap pula sesuai jumlah layer-nya. Model ini tidak memiliki memori terhadap contoh pelatihan sebelumnya sehingga tidak mampu menangkap ketergantungan antarposisi dalam suatu sekuens. Selain itu, panjang sekuens yang bervariasi sulit diakomodasi tanpa rekayasa fitur tambahan.
#Link to this headingJenis Pemodelan Sekuens
Bergantung pada sifat input dan output, pemodelan sekuens dibagi menjadi tiga kategori utama.
#Link to this headingMany-to-One
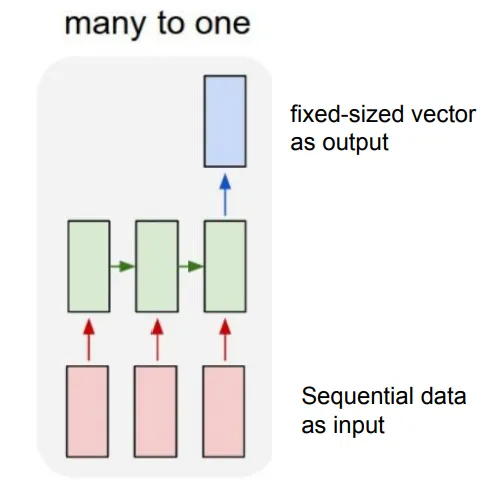
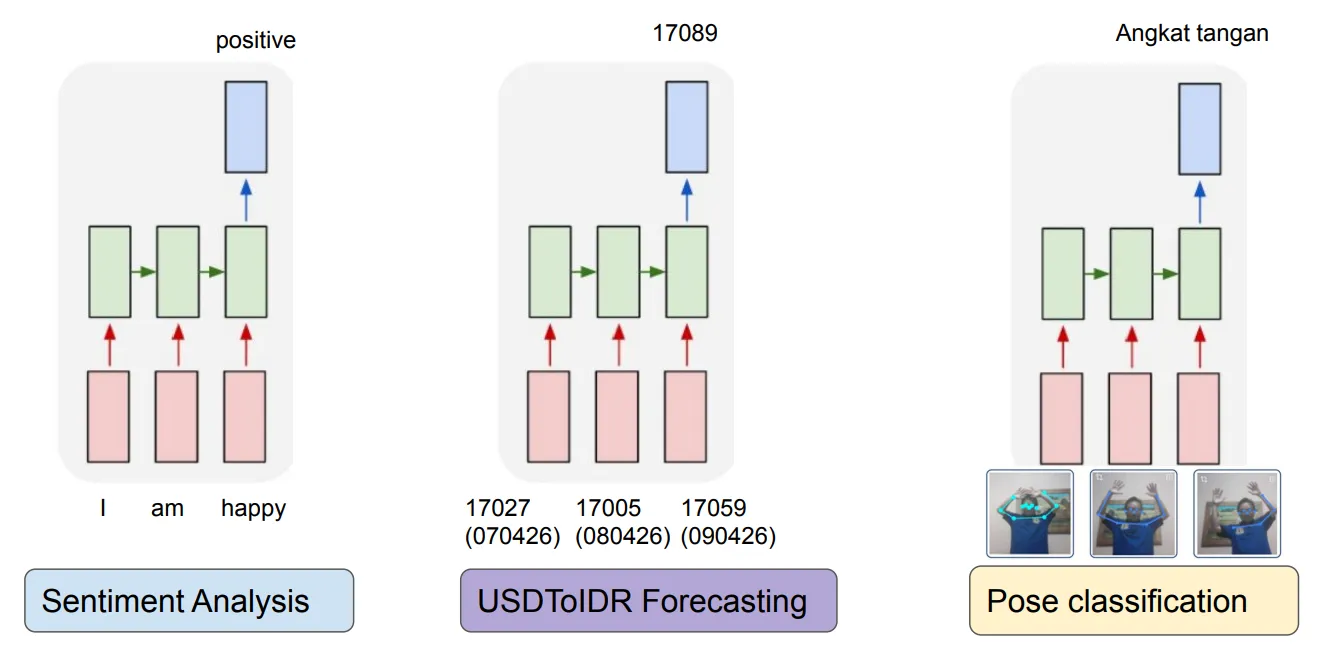
Input berupa sekuens, sedangkan output berupa vektor atau skalar berukuran tetap. Contoh penerapannya meliputi analisis sentimen (teks ulasan sebagai input dan label sentimen sebagai output), klasifikasi teks, penilaian esai otomatis, churn detection, klasifikasi video, dan peramalan permintaan.
#Link to this headingOne-to-Many
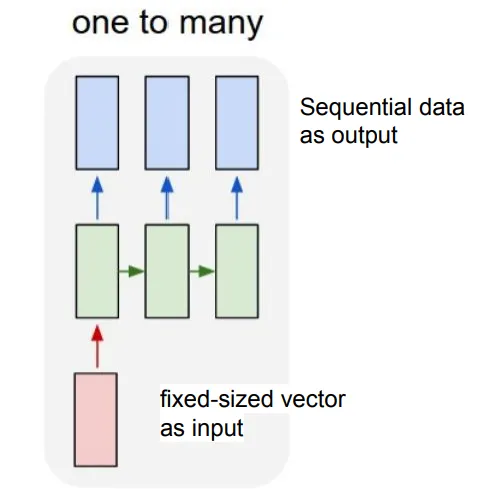
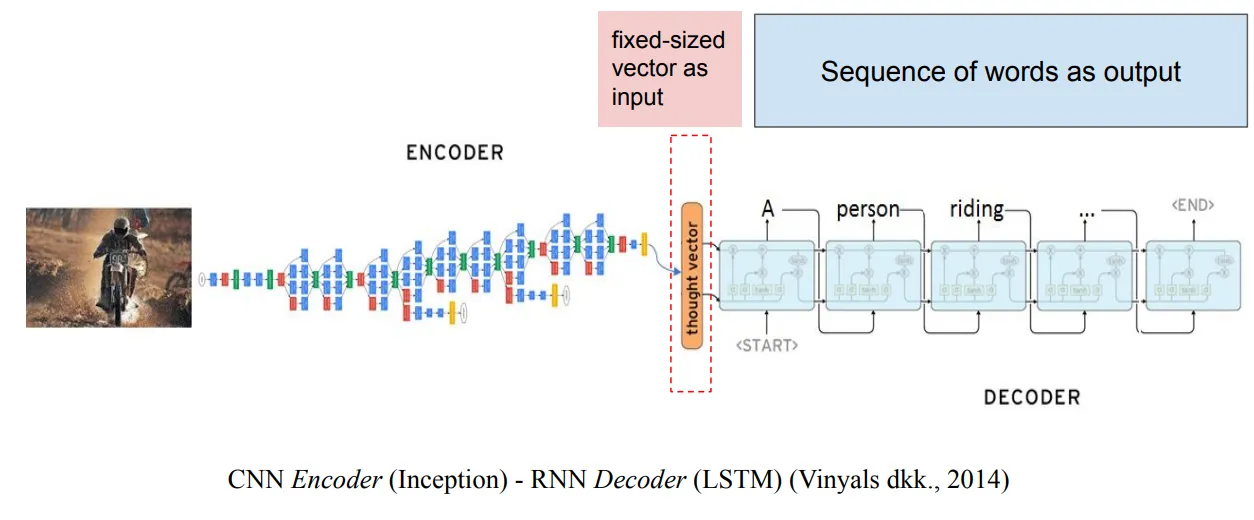
Input berupa data dalam format standar yang bukan sekuens, sedangkan output berupa sekuens. Contoh penerapannya adalah image captioning, yaitu gambar sebagai input dan frasa deskriptif sebagai output.
#Link to this headingMany-to-Many
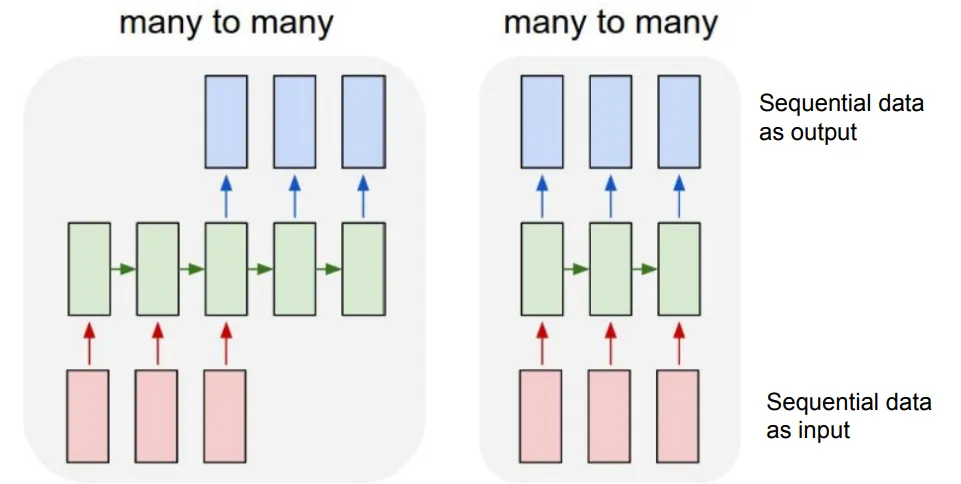
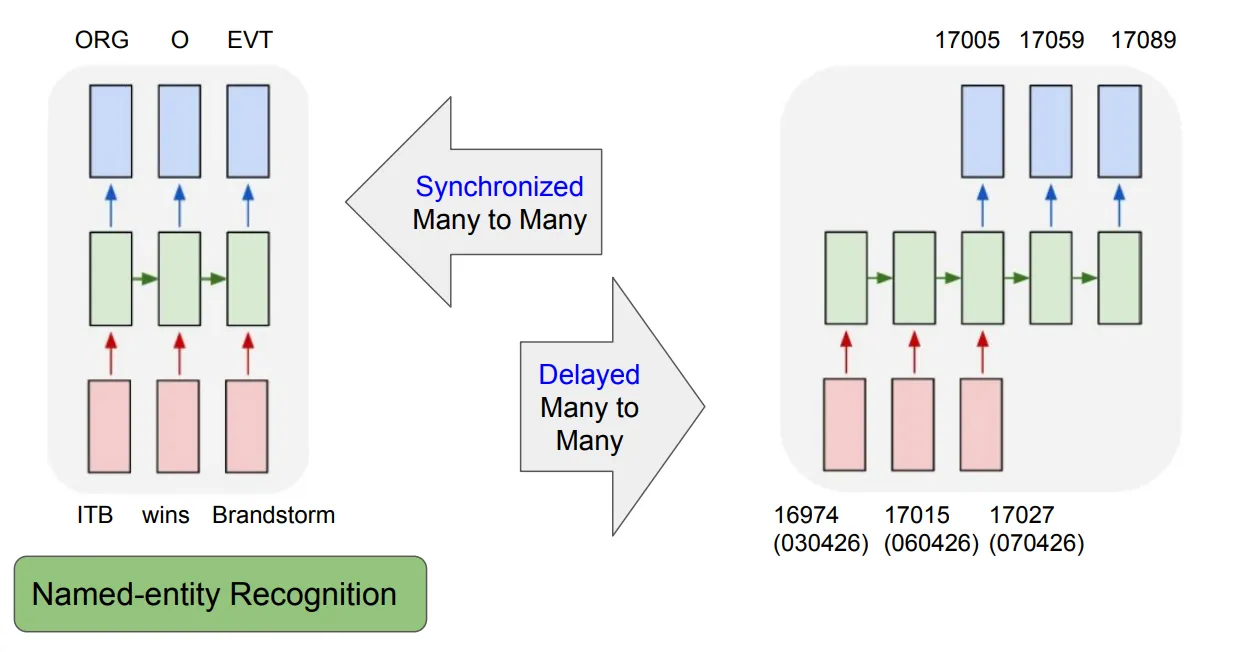
Baik input maupun output keduanya merupakan sekuens. Kategori ini dibagi lebih lanjut berdasarkan sinkronisasi input dan output. Pada varian tersinkronisasi (synchronized), contohnya adalah named-entity recognition di mana setiap token diberi label secara langsung. Pada varian tertunda (delayed), contohnya adalah mesin penerjemah di mana output baru dihasilkan setelah seluruh input dibaca.
#Link to this headingRecurrent Neural Network (RNN)
#Link to this headingArsitektur
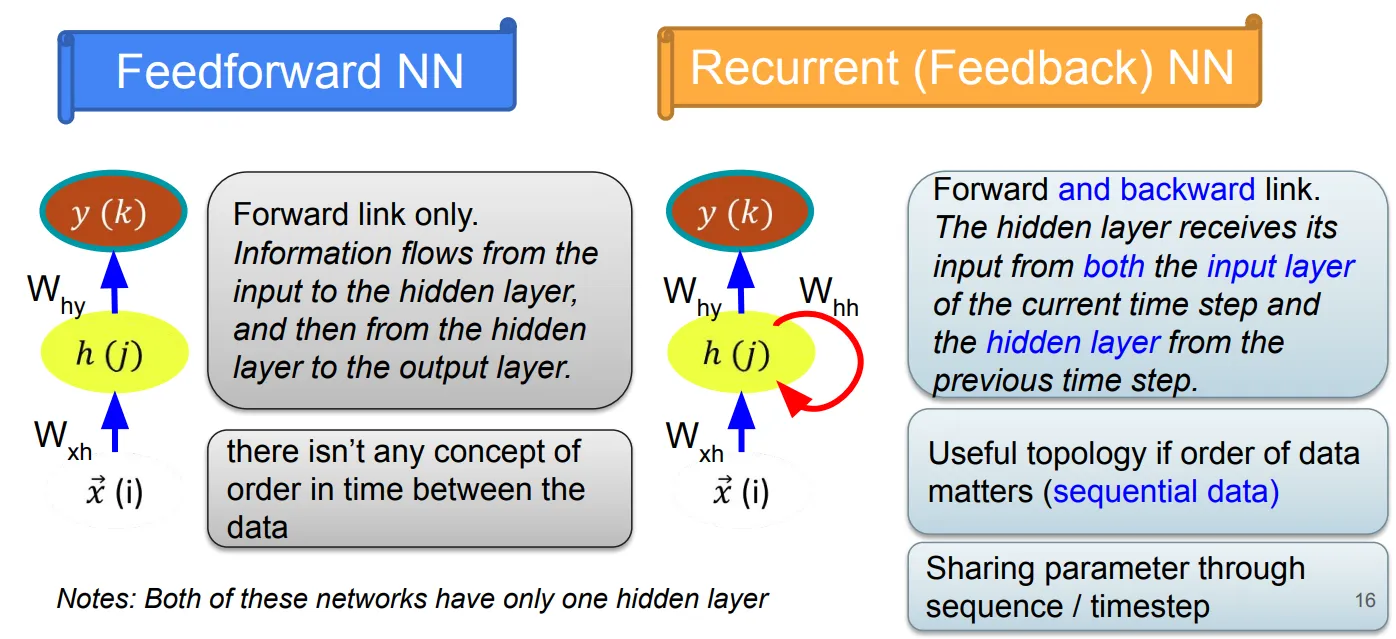
Berbeda dengan FFNN yang hanya memiliki koneksi maju (forward link), RNN memiliki koneksi maju sekaligus koneksi mundur (backward link). Hidden layer pada RNN menerima input dari dua sumber, yaitu layer input pada timestep saat ini dan hidden layer yang sama pada timestep sebelumnya. Bobot dibagi (shared) di sepanjang sumbu waktu sehingga parameter lebih efisien (parameter sharing).
#Link to this headingSingle-Layer RNN
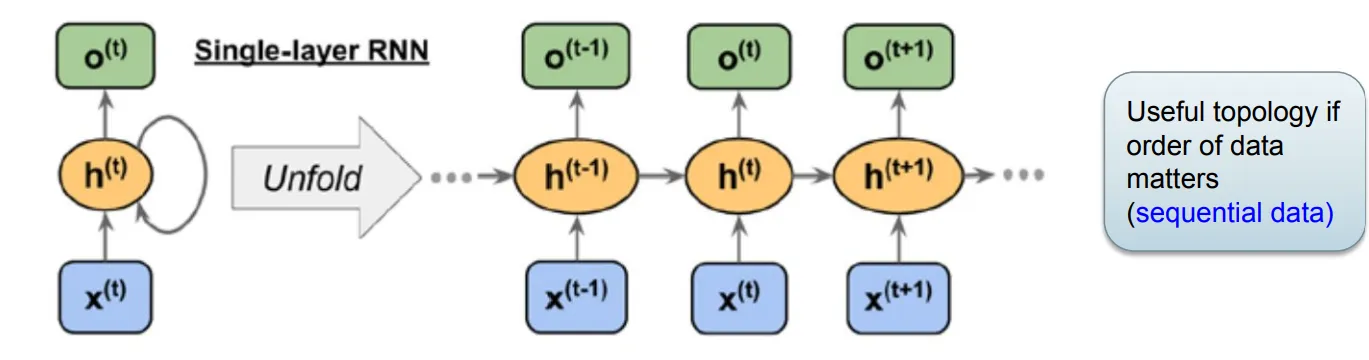
Representasi kompak RNN dengan recurrent edge dapat dibuka (unfolded) sehingga tampak sebagai rangkaian hidden unit yang terhubung lintas waktu. Setiap hidden unit menerima dua input berbeda, yaitu praaktivasi (preactivation) dari layer input dan aktivasi hidden layer yang sama pada timestep sebelumnya . Pada timestep pertama (), hidden unit diinisialisasi dengan nol atau nilai acak kecil. Pada , hidden unit menerima dan .
#Link to this headingMulti-Layer RNN
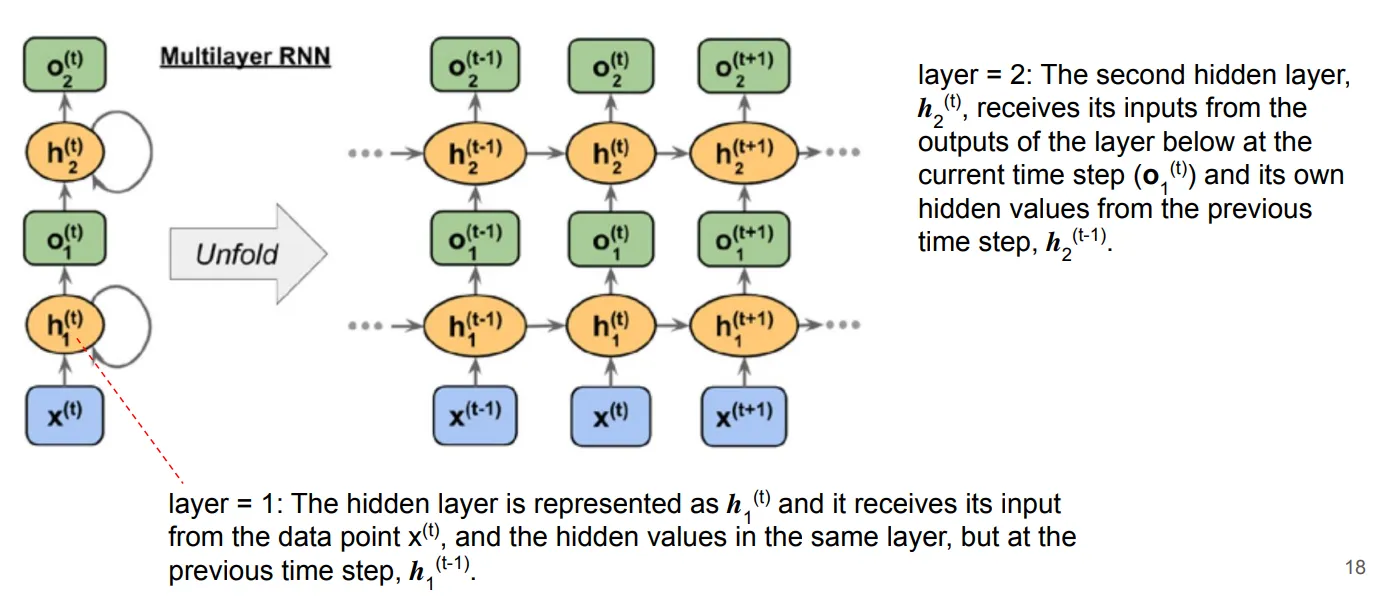
Pada RNN berlapis ganda, hidden layer pertama menerima input dan , sedangkan hidden layer kedua menerima output layer di bawahnya dan .
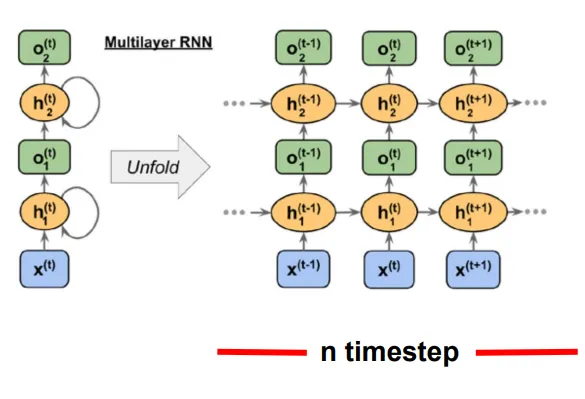
Setiap unit rekuren memiliki loop yang memungkinkan informasi terbawa melintasi neuron ketika membaca input. Setiap layer rekuren harus menerima sekuens sebagai input dan semua layer rekuren kecuali yang terakhir harus mengembalikan sekuens sebagai output (dengan return_sequences=True).
#Link to this headingParameter RNN
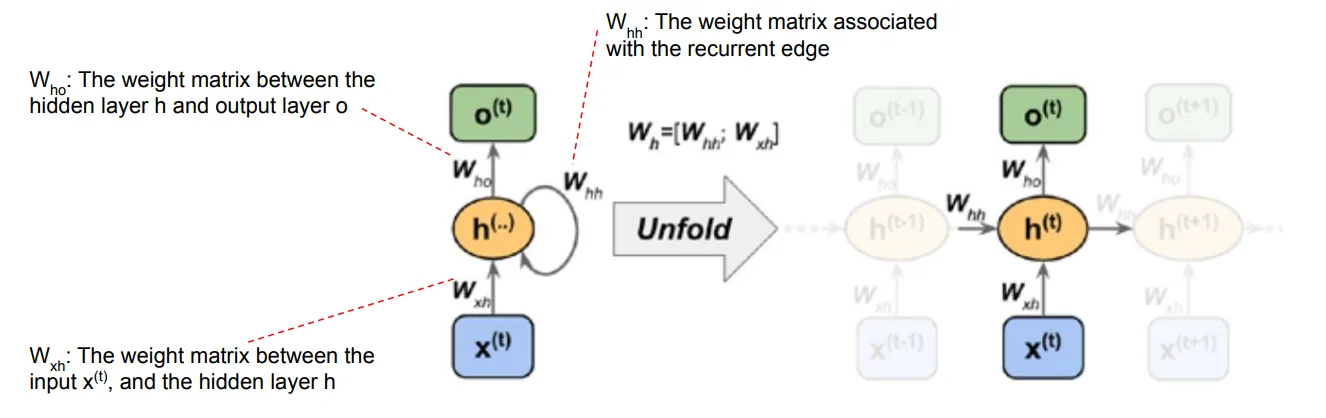
Setiap koneksi terarah dalam representasi RNN dikaitkan dengan sebuah matriks bobot yang tidak bergantung pada waktu sehingga dibagi di sepanjang sumbu waktu.
Tiga matriks bobot utama dalam RNN adalah sebagai berikut.
- adalah matriks bobot dari input ke hidden layer
- adalah matriks bobot rekuren dari ke antar-timestep
- adalah matriks bobot dari hidden layer ke output layer
#Link to this headingDimensi Matriks Bobot
| Matriks | Dimensi |
|---|---|
| hidden neurons input dimension | |
| hidden neurons hidden neurons | |
| output neurons hidden neurons | |
| hidden neurons 1 | |
| output neurons 1 |
#Link to this headingJumlah Parameter Simple RNN
Dengan dimensi input, hidden neurons, dan output neurons:
Contoh: 1 input, 10 hidden neurons, 1 output regresi:
#Link to this headingForward Propagation RNN
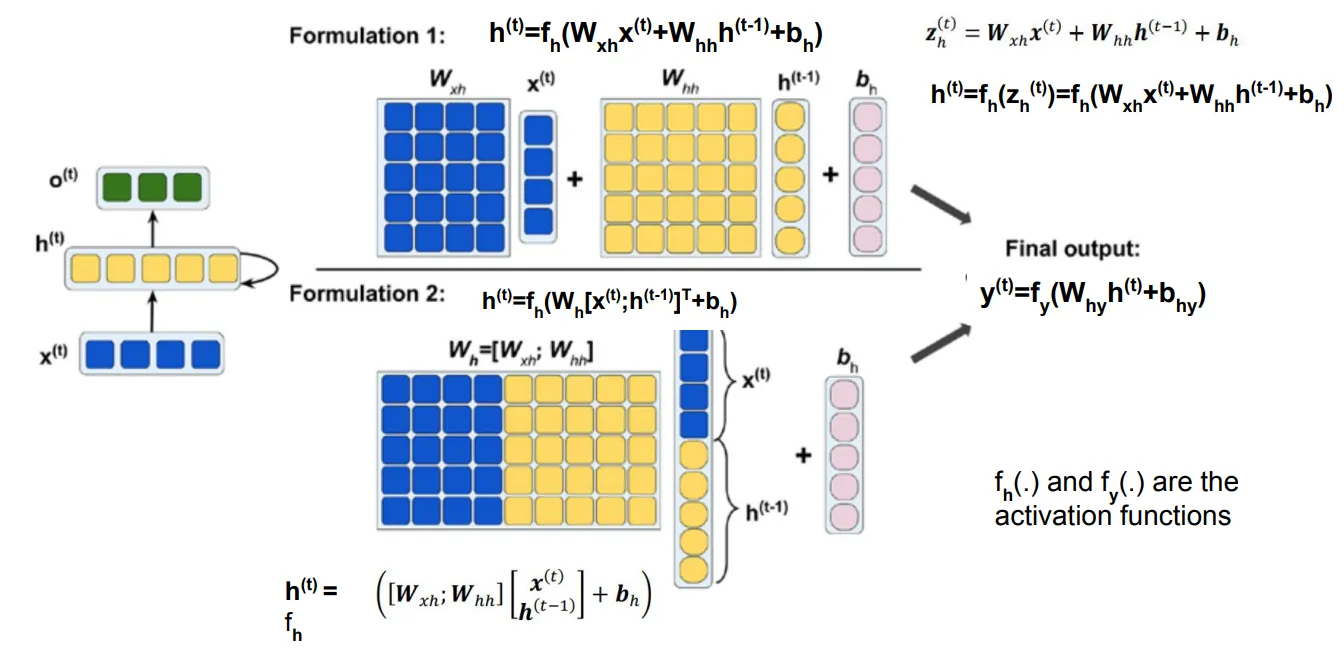
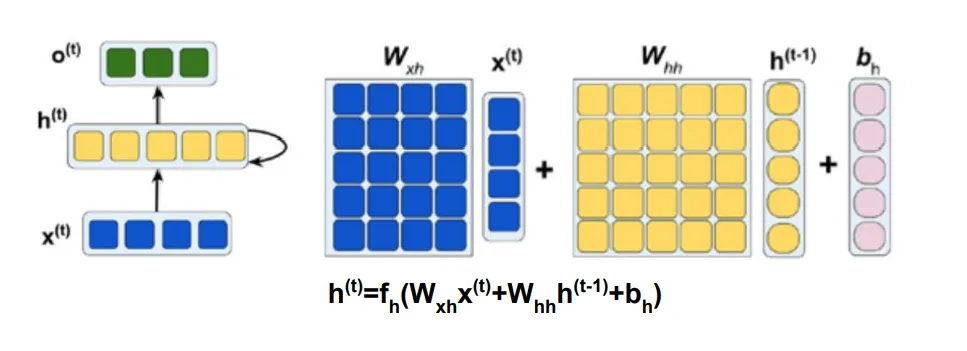
Forward propagation pada RNN dilakukan per timestep dengan formula berikut.
Fungsi aktivasi umumnya menggunakan tanh, sedangkan bergantung pada jenis persoalan (softmax untuk klasifikasi multikelas dan linear untuk regresi). Persamaan hidden state juga dapat ditulis dalam bentuk gabungan (concatenated).
#Link to this headingPersiapan Dataset Deret Waktu
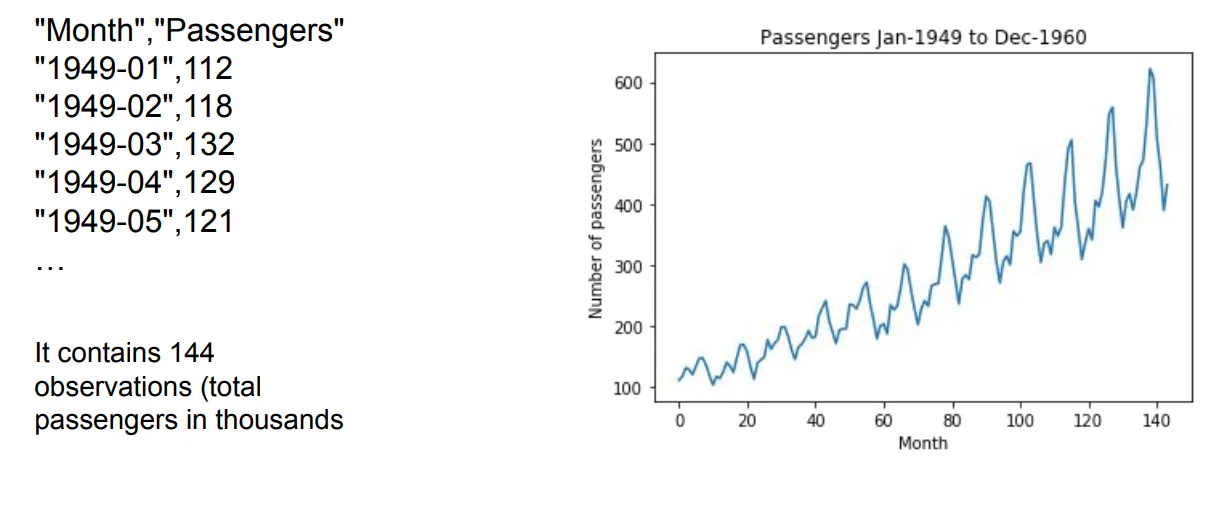
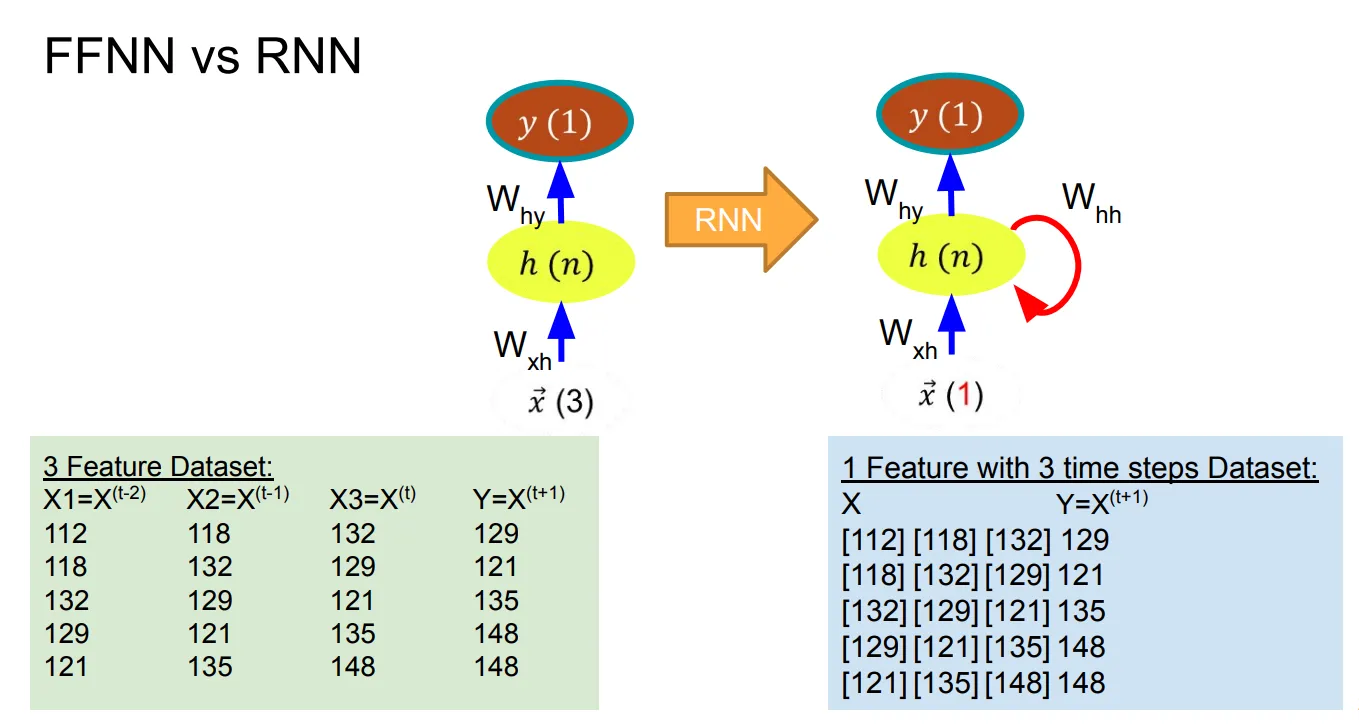
Data deret waktu harus ditransformasi menjadi matriks di mana setiap nilai dikaitkan dengan jendela waktu (lag) sebelumnya. Sebagai contoh, dataset Airline Passenger memiliki 144 observasi jumlah penumpang bulanan.
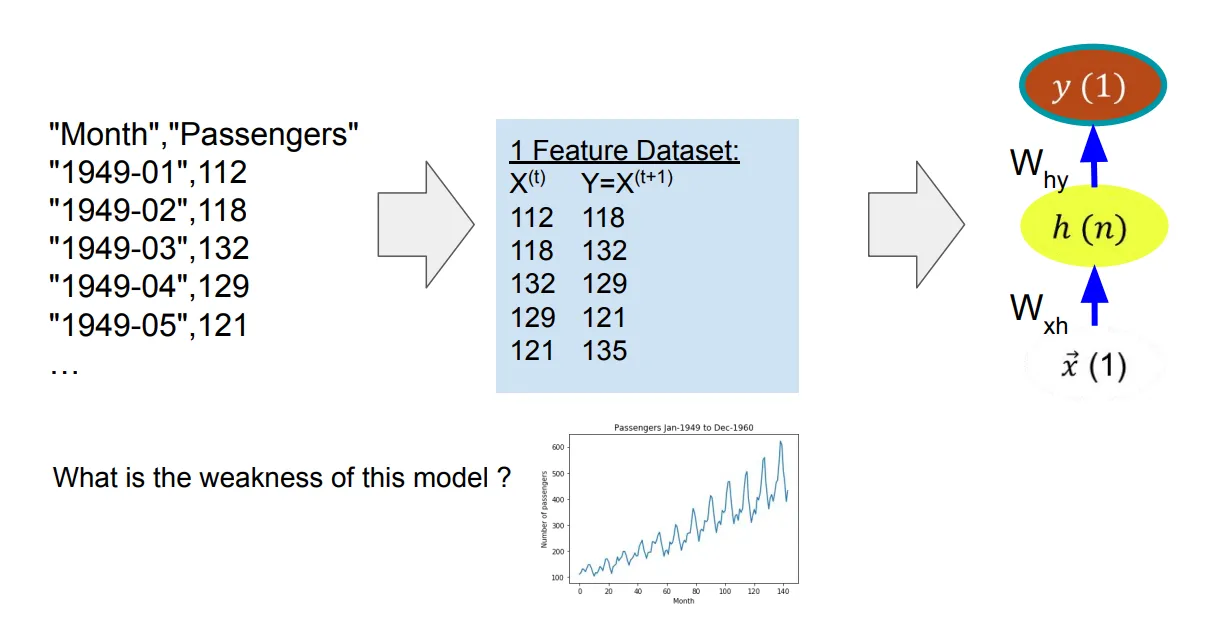
Pada FFNN dengan 1 fitur, model menerima satu nilai sebelumnya untuk memprediksi nilai berikutnya. Keterbatasannya adalah konteks historis yang sangat terbatas.
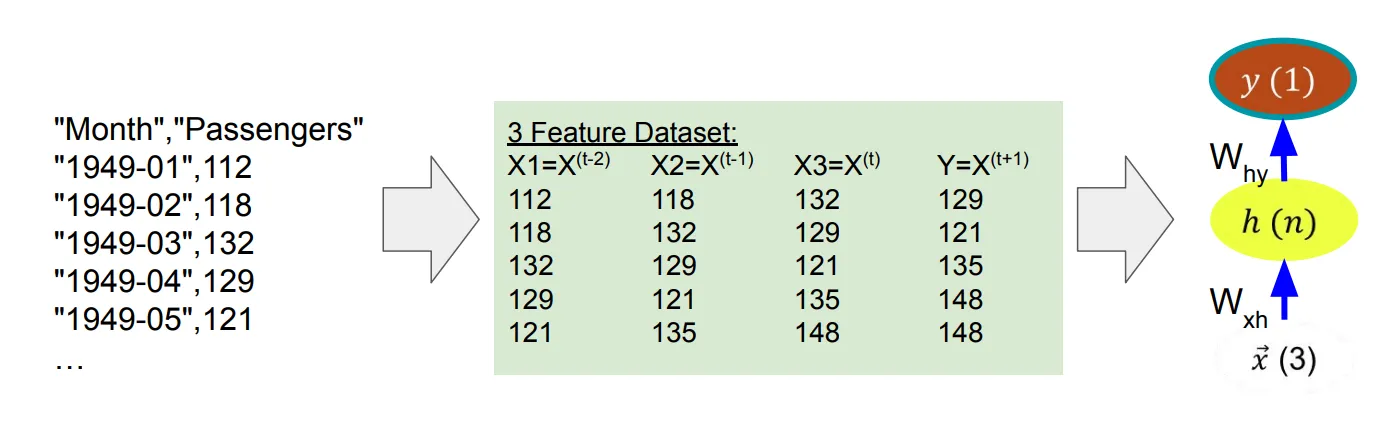
Dengan 3 fitur, model menerima tiga nilai historis sekaligus, tetapi panjang jendela harus ditentukan secara manual dan bobot tidak dibagi antar-posisi.
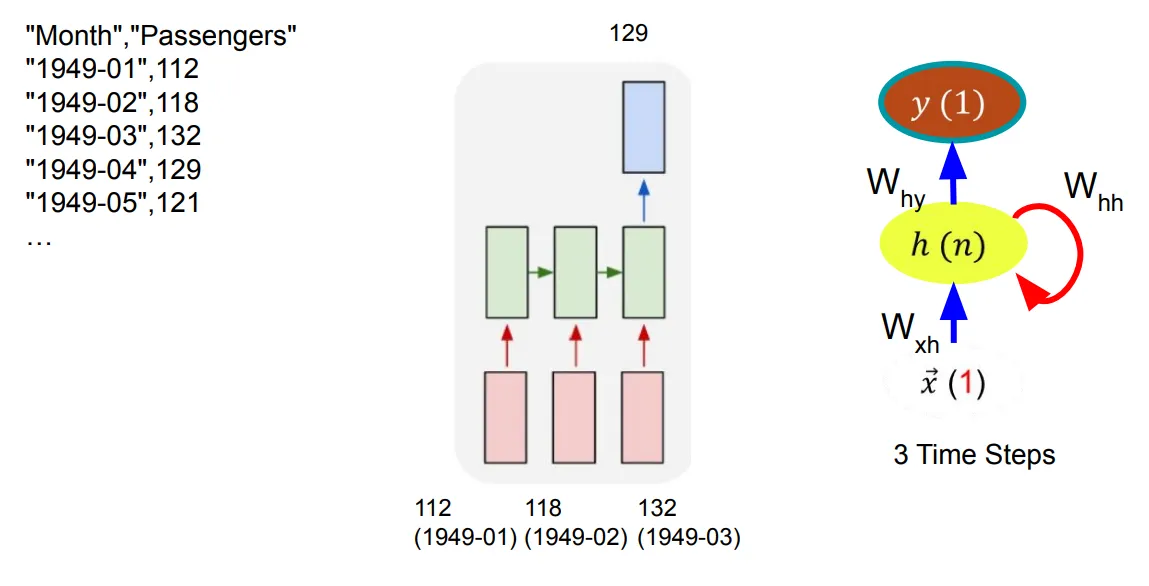
RNN memungkinkan penggunaan timestep berurutan secara alami dengan bobot dibagi (shared) di setiap timestep sehingga lebih efisien secara parameter.
#Link to this headingContoh Forward Propagation: Klasifikasi Sekuens
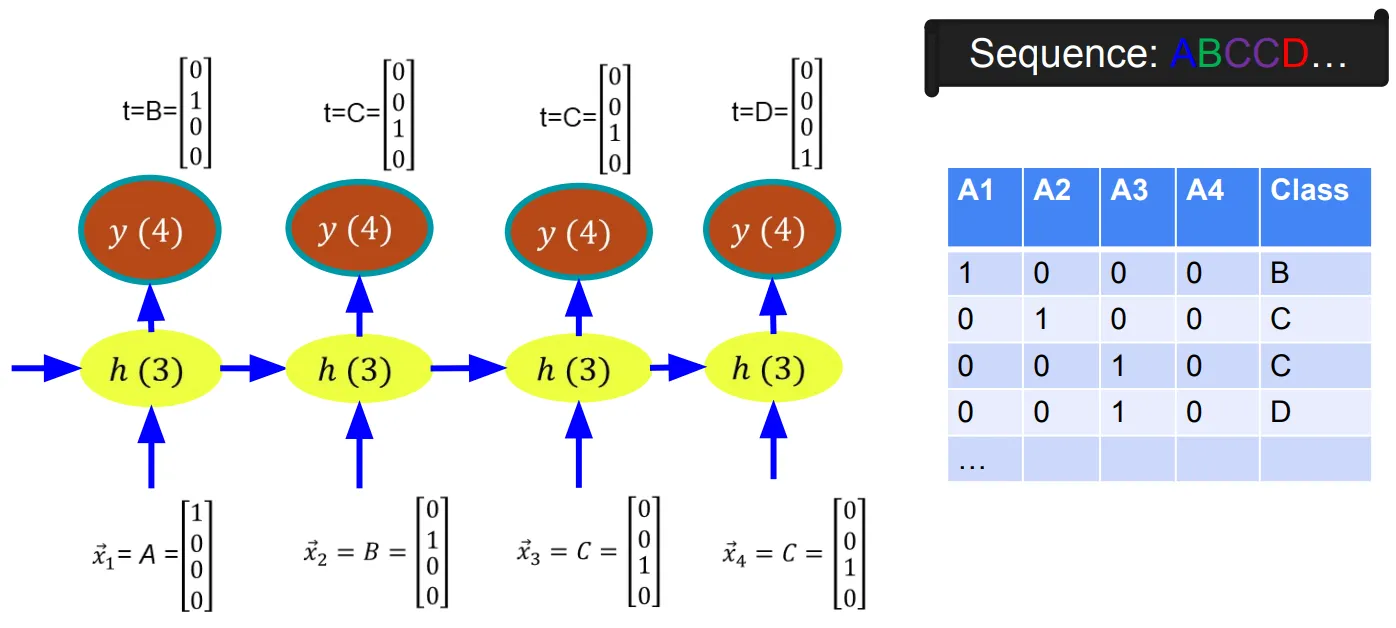
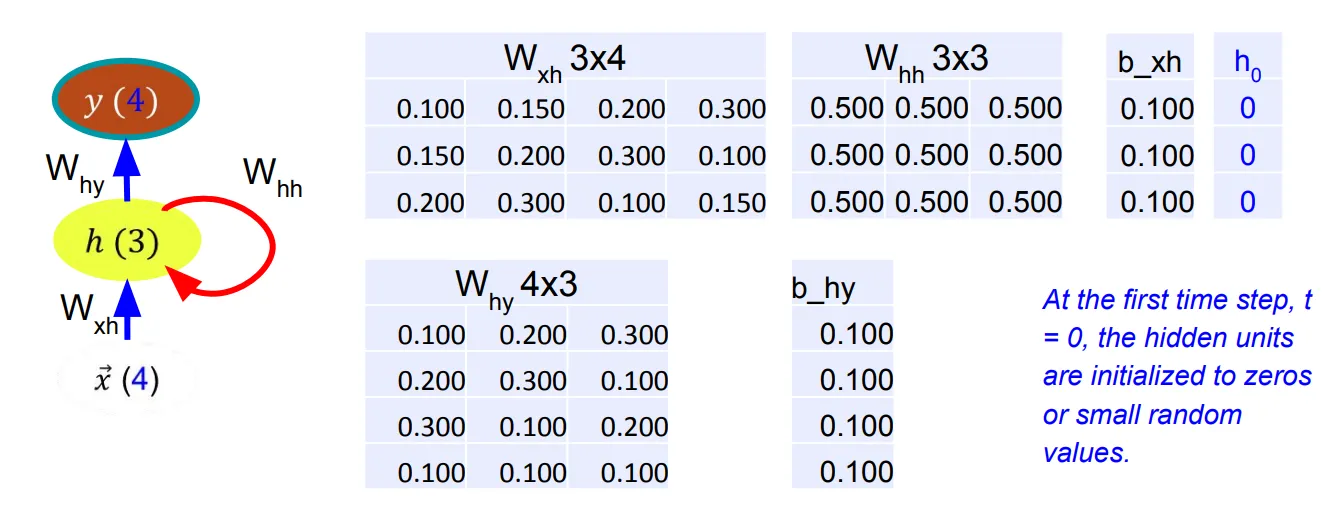
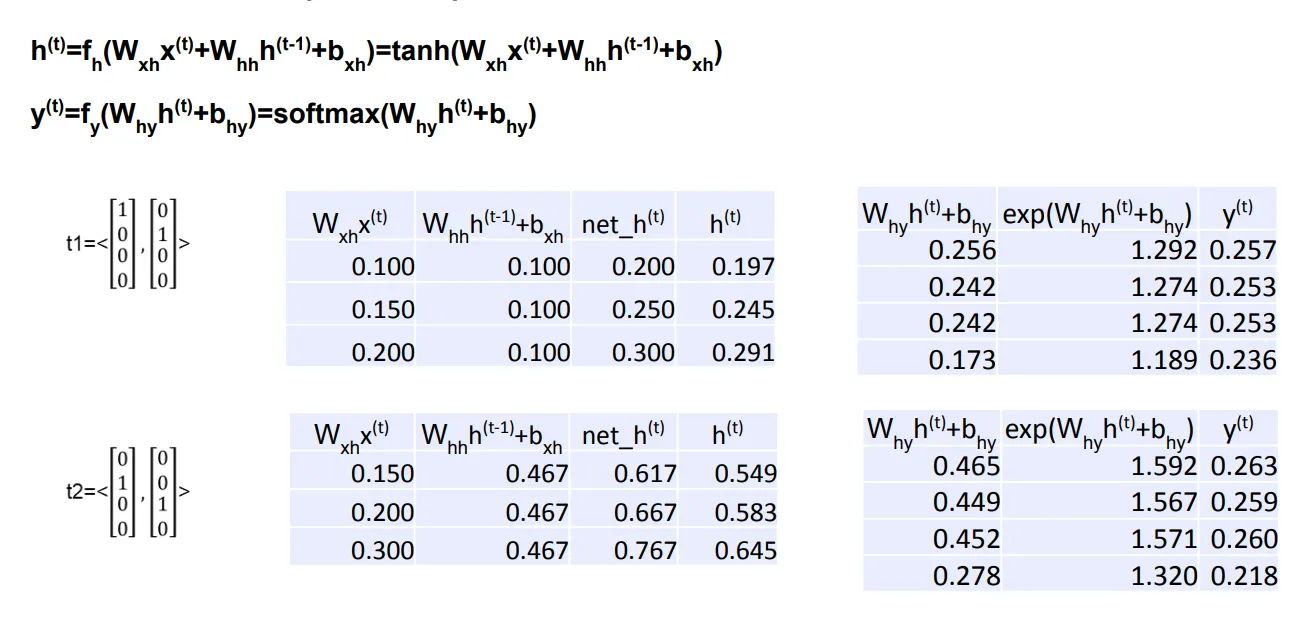
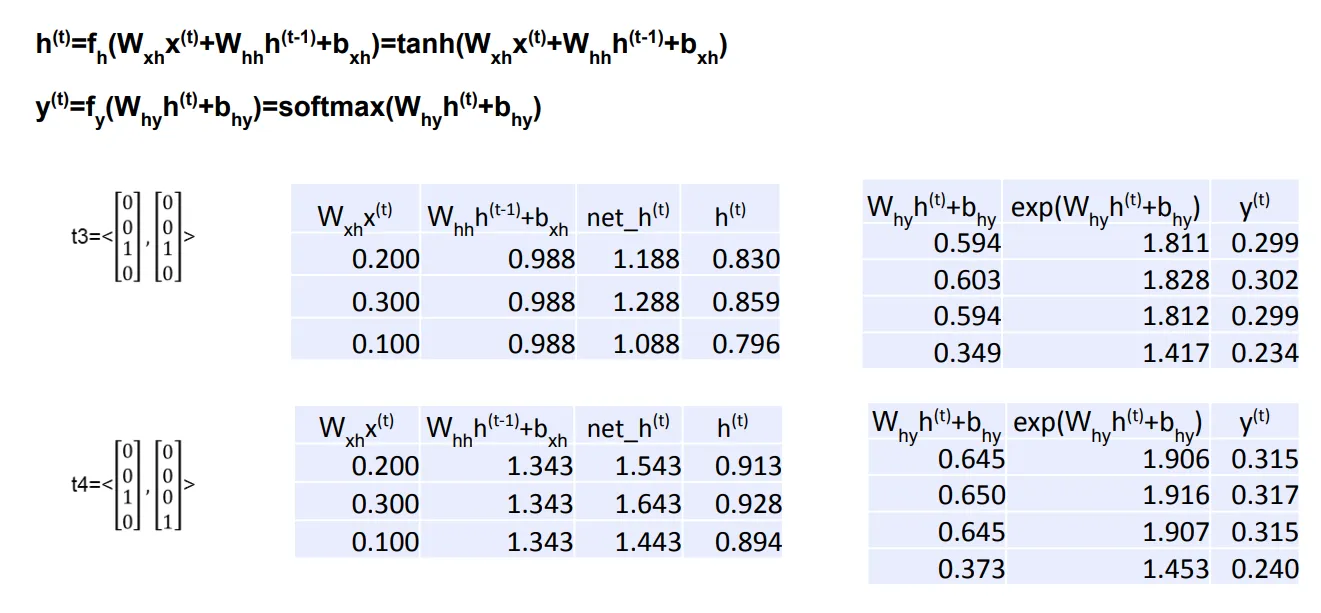
Sebagai contoh konkret, diberikan sekuens karakter "ABCCD" yang di-encode dengan one-hot encoding berukuran 4 (A, B, C, D). Arsitektur RNN menggunakan 3 hidden neurons dengan aktivasi tanh dan 4 output neurons dengan aktivasi softmax.
| Matriks | Dimensi | Keterangan |
|---|---|---|
| hidden neurons input dimension | ||
| hidden neurons hidden neurons | ||
| output neurons hidden neurons | ||
| bias hidden | ||
| bias output |
Formula yang digunakan:
Pada , hidden state diinisialisasi dengan nol. Setiap timestep menghasilkan distribusi probabilitas atas 4 kelas berikutnya.
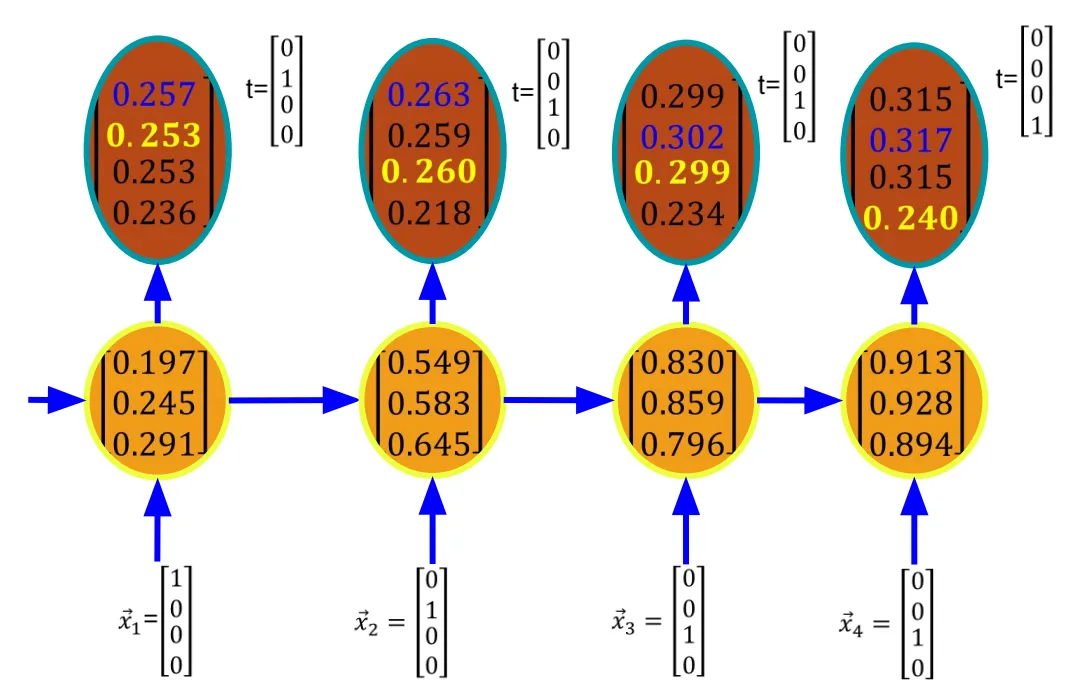
Tabel berikut menunjukkan hasil komputasi numerik pada timestep dan .
Dan untuk timestep dan :
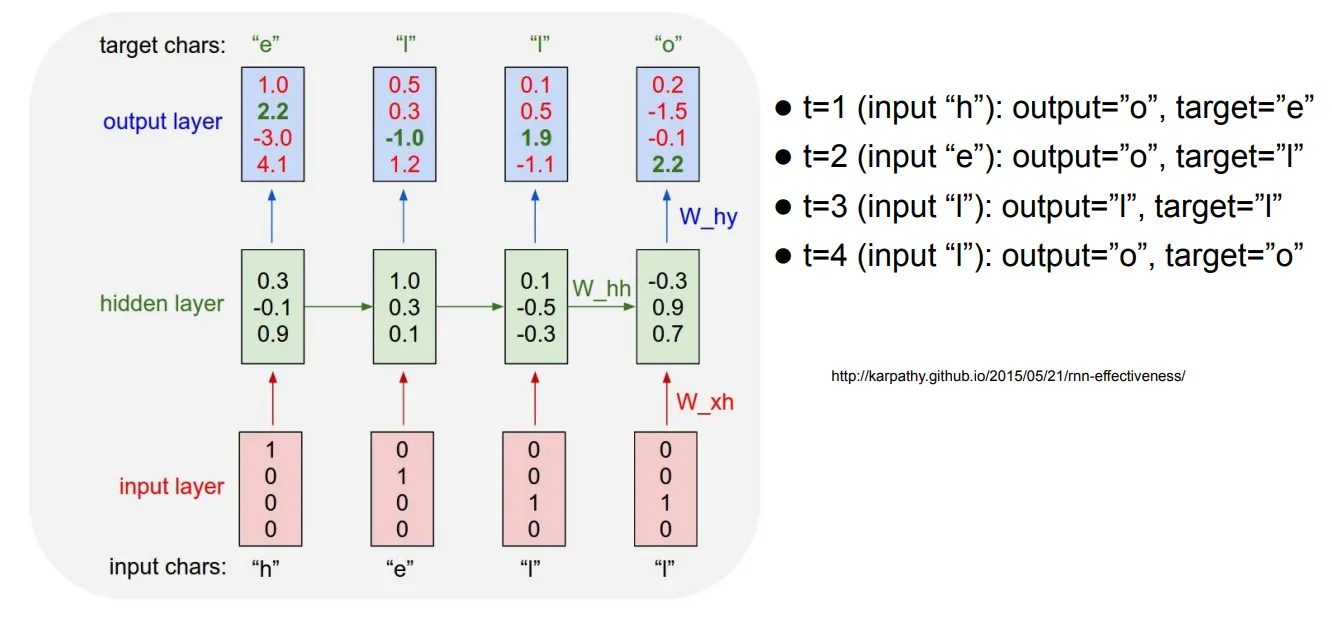
Pada contoh language model karakter "hello", prediksi yang dihasilkan pada tiap timestep dibandingkan terhadap karakter target berikutnya.
- (input "h"), prediksi "o", target "e"
- (input "e"), prediksi "o", target "l"
- (input "l"): output "l", target "l" ✓
- (input "l"): output "o", target "o" ✓
#Link to this headingImplementasi RNN
from keras import Sequential
from keras.layers import SimpleRNN, Dense

# Many-to-One: prediksi harga saham, 50 timestep, 10 hidden neurons
model = Sequential()
model.add(SimpleRNN(10, input_shape=(50, 1)))
model.add(Dense(1, activation='linear'))
# Total parameter = (1+10+1)*10 + (10+1)*1 = 131
Contoh arsitektur multi-layer:
model = Sequential()
model.add(SimpleRNN(64, input_shape=(50, 1), return_sequences=True))
model.add(SimpleRNN(32, return_sequences=True))
model.add(SimpleRNN(16))
model.add(Dense(8, activation='tanh'))
model.add(Dense(1, activation='linear'))
# (1+64+1)*64 + (64+32+1)*32 + (32+16+1)*16 + (16+1)*8 + (8+1)*1
# = 4224 + 3104 + 784 + 136 + 9 = 8257#Link to this headingBidirectional RNN
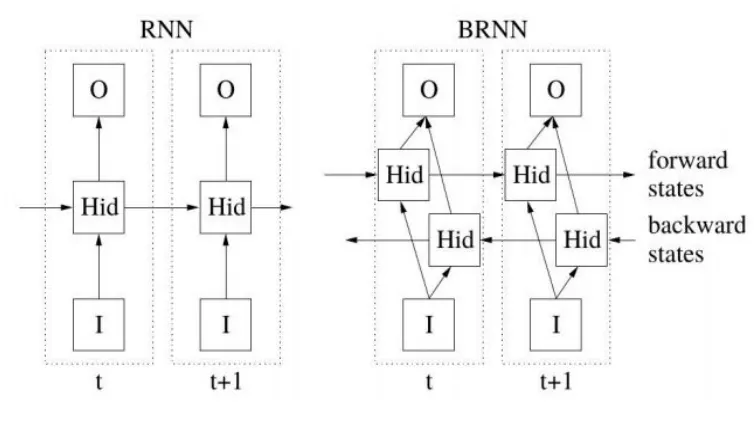
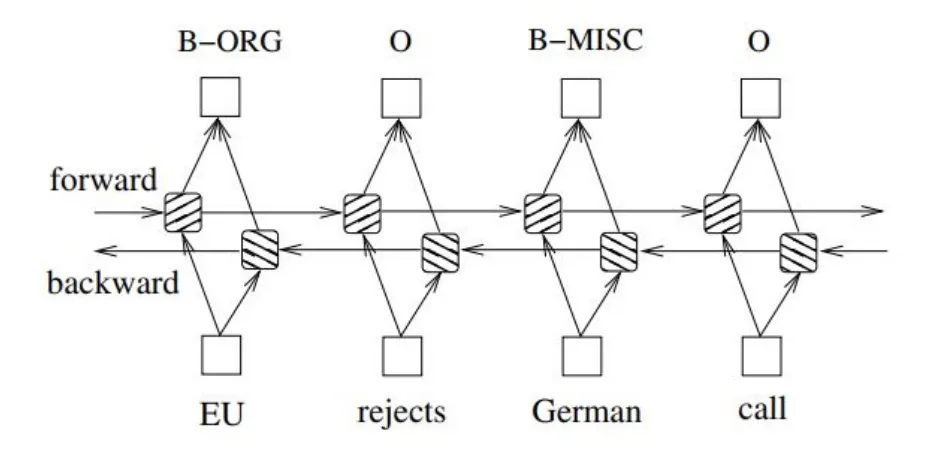
Pada banyak persoalan, prediksi bergantung pada keseluruhan sekuens input, bukan hanya konteks sebelumnya. Bidirectional RNN menggabungkan dua RNN, yaitu satu yang bergerak maju dari awal sekuens dan satu yang bergerak mundur dari akhir sekuens. Contoh penerapannya adalah pengenalan ucapan (co-articulation) dan part-of-speech tagging.
#Link to this headingLong Short-Term Memory (LSTM)
#Link to this headingMotivasi
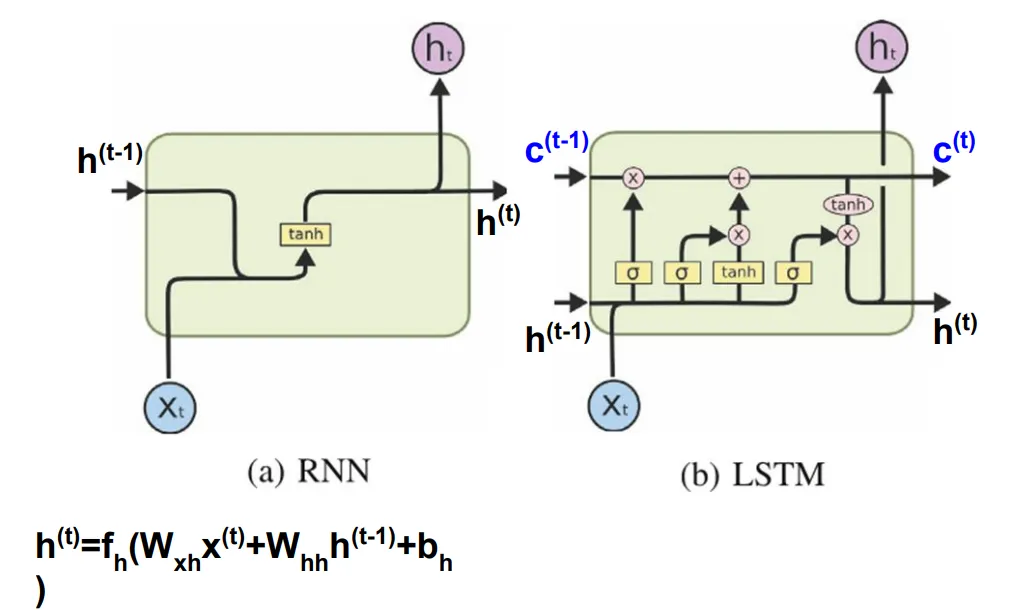
RNN standar menghadapi kesulitan menangkap ketergantungan jangka panjang (long-term dependency) karena hidden state yang terbatas. LSTM diperkenalkan oleh Hochreiter & Schmidhuber (1997) dan dirancang secara eksplisit untuk mengatasi masalah ini. Berbeda dengan RNN standar yang modul berulangnya hanya berisi satu layer tanh, modul berulang LSTM mengandung empat layer yang saling berinteraksi.
#Link to this headingCell State dan Gates
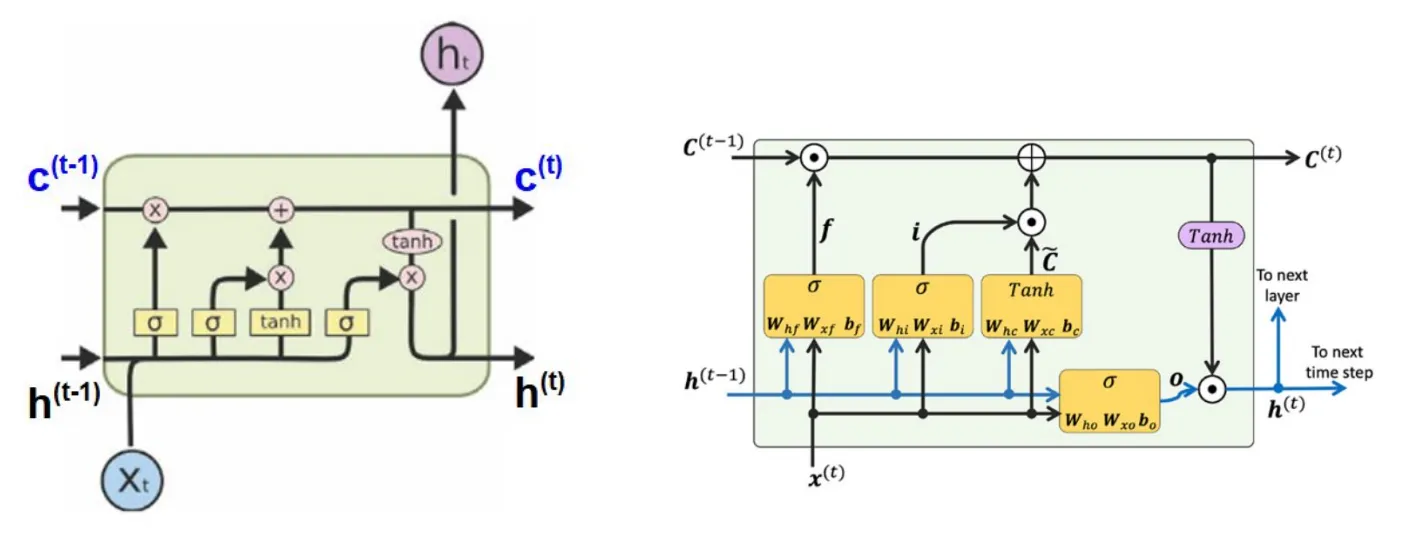
LSTM memiliki dua jalur informasi, yaitu hidden state dan cell state .
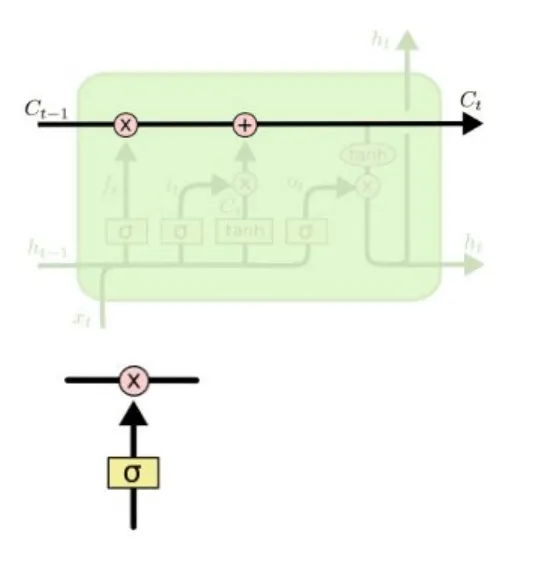
Cell state berfungsi sebagai "memori" jaringan, berperan sebagai jalur transportasi yang membawa informasi relevan sepanjang pemrosesan sekuens. Cell state bergerak lurus sepanjang rantai dengan hanya sedikit interaksi linear sehingga informasi dapat mengalir hampir tanpa perubahan.
Gates berfungsi sebagai pengatur aliran informasi secara opsional. Setiap gate menggunakan layer sigmoid yang menghasilkan nilai antara 0 dan 1, di mana 0 berarti "blokir sepenuhnya" dan 1 berarti "lewatkan sepenuhnya".
#Link to this headingForget Gate
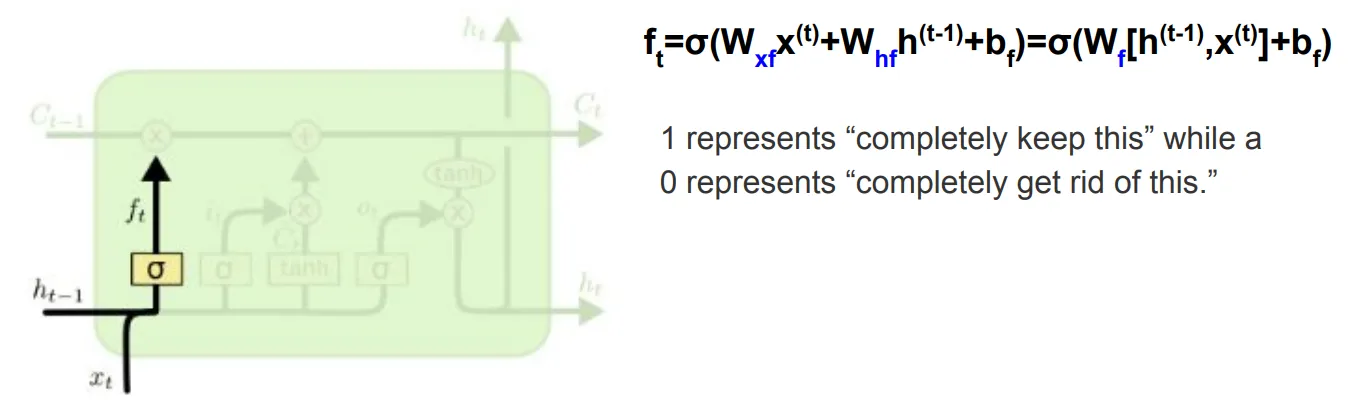
Forget gate memutuskan informasi mana yang akan dibuang dari cell state. Gate ini melihat dan , kemudian menghasilkan nilai antara 0 dan 1 untuk setiap elemen cell state .
Nilai mendekati 0 berarti "lupakan", sedangkan nilai mendekati 1 berarti "pertahankan".
#Link to this headingInput Gate dan Tanh Layer
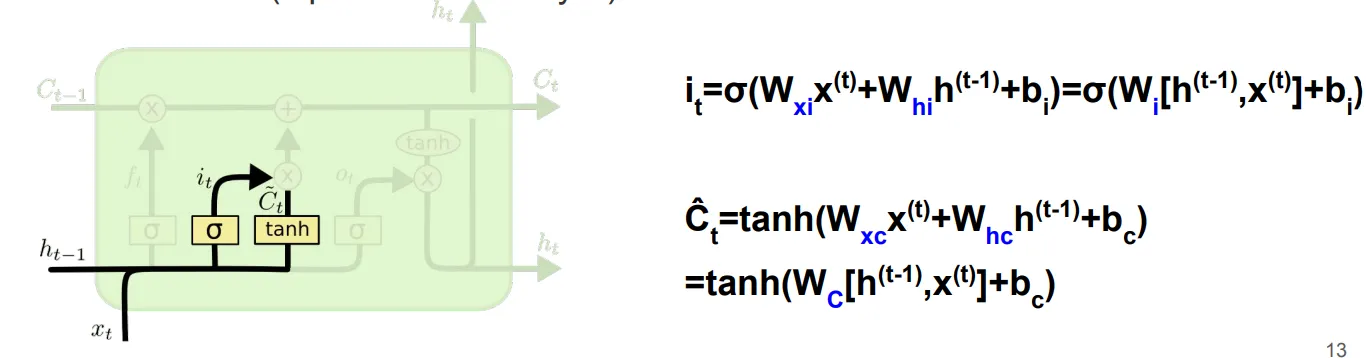
Tahap ini memutuskan informasi baru apa yang akan disimpan ke dalam cell state, terdiri dari dua komponen. Input gate memutuskan nilai mana yang akan diperbarui, sedangkan tanh layer membentuk vektor kandidat nilai baru yang dapat ditambahkan ke state.
#Link to this headingPembaruan Cell State
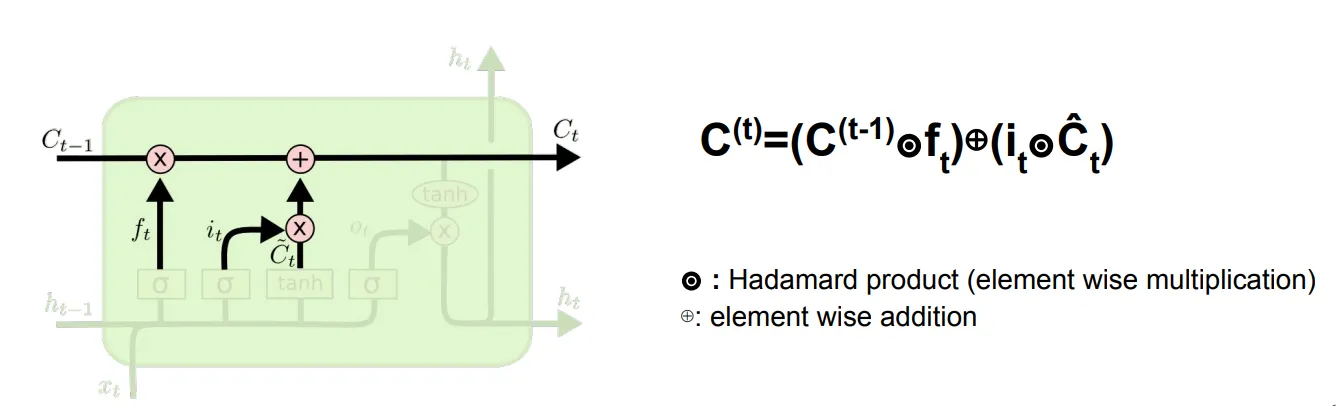
Cell state lama dikalikan dengan forget gate untuk melupakan informasi yang tidak relevan, kemudian ditambahkan dengan nilai kandidat baru yang diskalakan oleh input gate.
di mana menunjukkan perkalian elemen per elemen (Hadamard product) dan menunjukkan penjumlahan elemen per elemen.
#Link to this headingOutput Gate
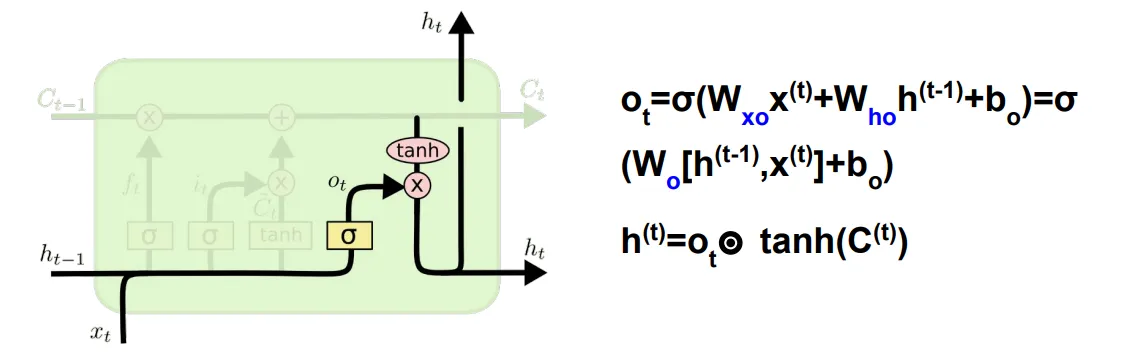
Output gate menentukan bagian mana dari cell state yang akan menjadi hidden state . Cell state dilewatkan melalui tanh untuk mendorong nilai ke rentang , kemudian dikalikan dengan output sigmoid gate.
#Link to this headingRingkasan Formula LSTM
| Gate | Formula |
|---|---|
| Forget gate | |
| Input gate | |
| Kandidat cell state | |
| Pembaruan cell state | |
| Output gate | |
| Hidden state |
#Link to this headingContoh Forward Propagation LSTM
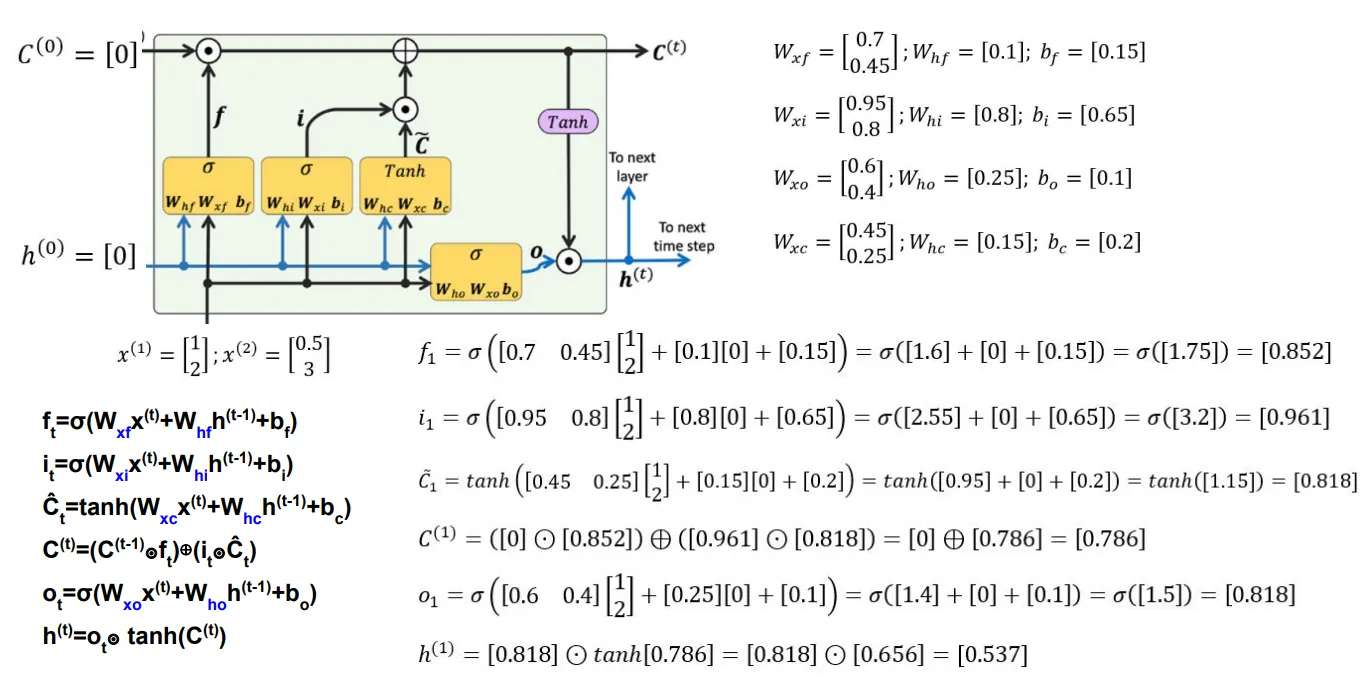
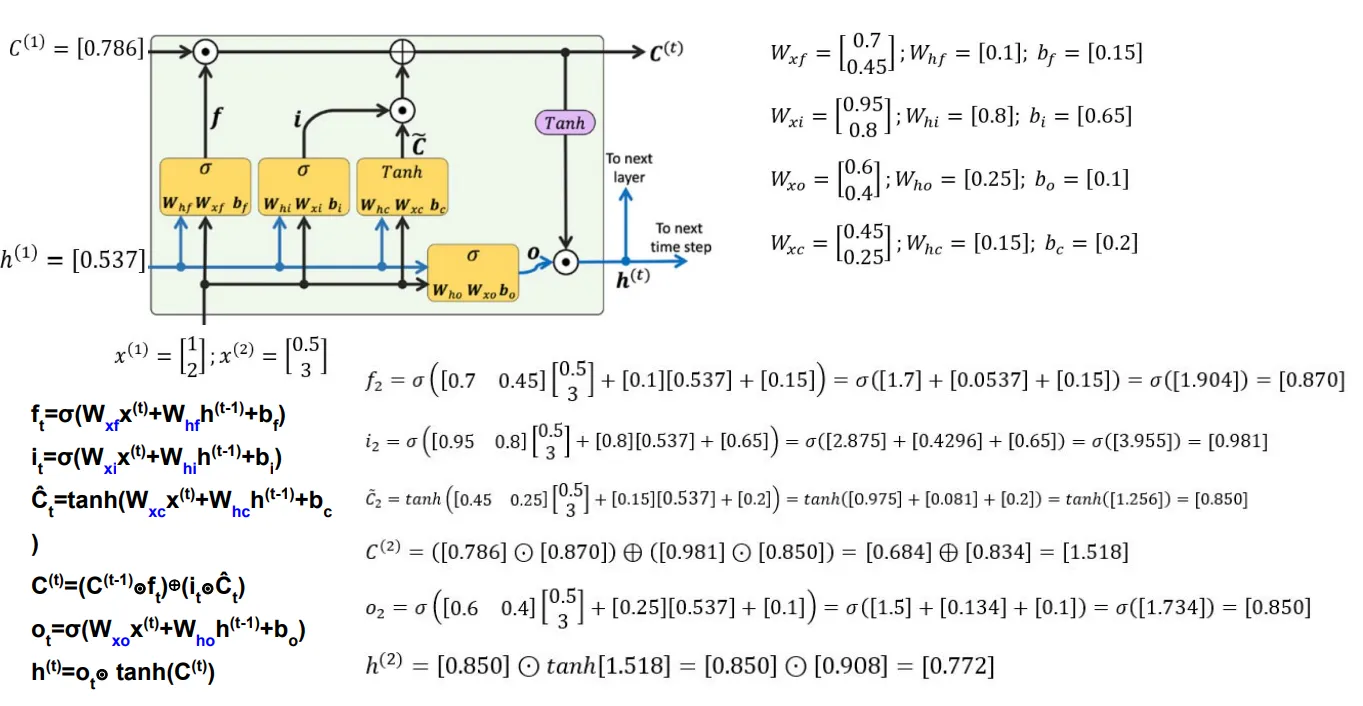
#Link to this headingImplementasi LSTM
from keras import Sequential
from keras.layers import LSTM, Dense

# Many-to-One: prediksi harga saham, LSTM 50 timestep, 10 hidden neurons
model = Sequential()
model.add(LSTM(10, input_shape=(50, 1)))
model.add(Dense(1, activation='linear'))
# Total parameter = (1+10+1)*4*10 + (10+1)*1 = 480 + 11 = 491#Link to this headingJumlah Parameter LSTM
Karena LSTM memiliki empat gate, jumlah parameternya empat kali lebih banyak dari Simple RNN dengan ukuran setara. Dengan dimensi input, hidden neurons, dan output neurons:
| Model | Formula | Total |
|---|---|---|
| Simple RNN | 131 | |
| LSTM | 491 |
#Link to this headingVarian: GRU dan ReGU
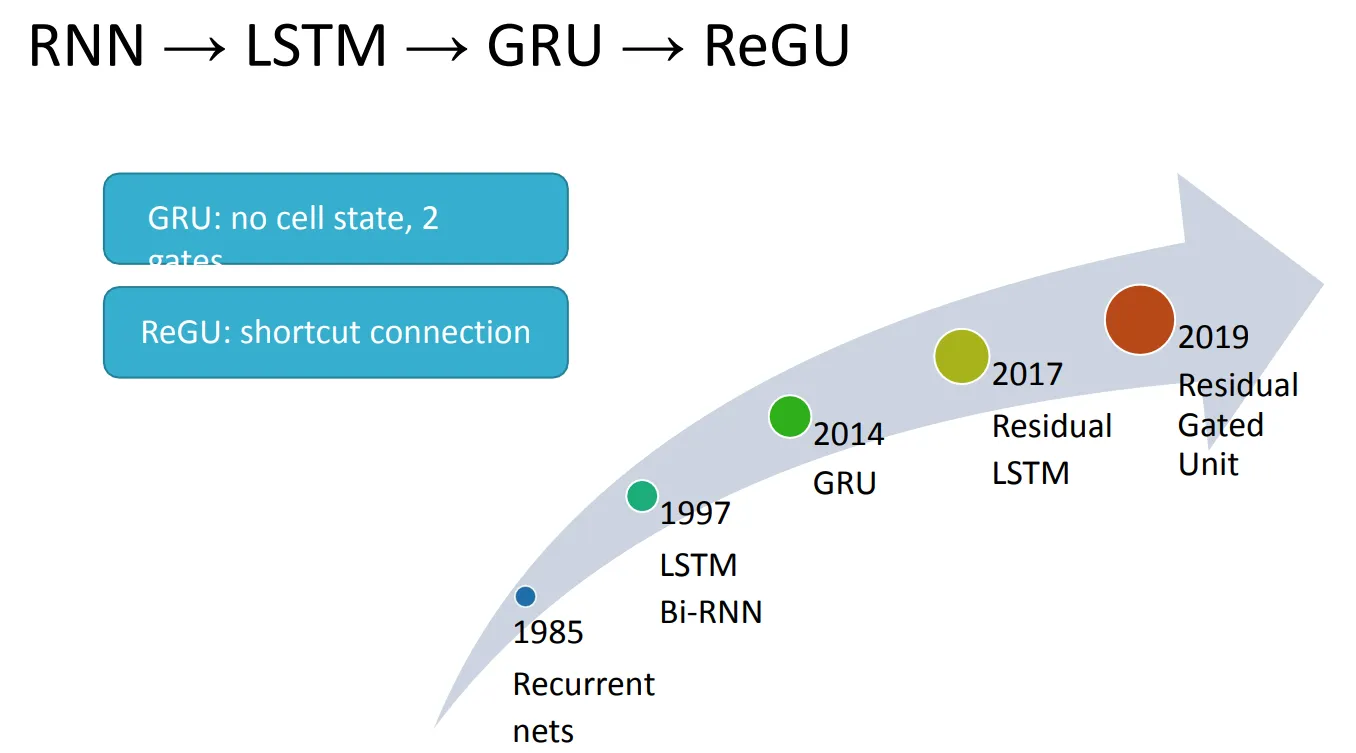
GRU (Gated Recurrent Unit, 2014) merupakan penyederhanaan LSTM tanpa cell state terpisah dan hanya menggunakan dua gate, yaitu reset gate dan update gate. ReGU (Residual Gated Unit, 2019) menambahkan koneksi shortcut untuk mengatasi degradasi performa pada jaringan yang sangat dalam.
#Link to this headingBackpropagation Through Time (BPTT)
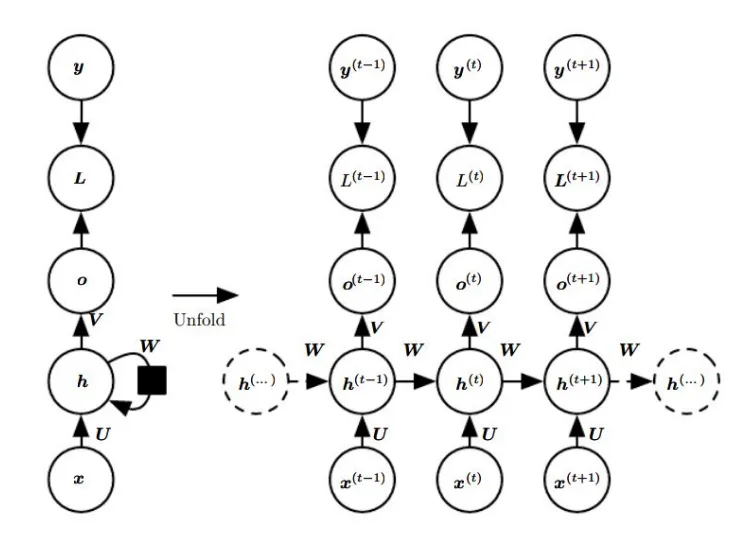
BPTT (Backpropagation Through Time) adalah ekstensi dari backpropagation standar yang diterapkan pada jaringan yang di-unfold sepanjang waktu. Total loss merupakan jumlah loss di setiap timestep dari hingga .
Notasi matriks yang sering digunakan dalam literatur adalah , , dan .
#Link to this headingCross Entropy Loss
Fungsi loss yang umum digunakan pada RNN untuk klasifikasi adalah cross entropy:
di mana merupakan target one-hot encoded dan merupakan prediksi softmax.
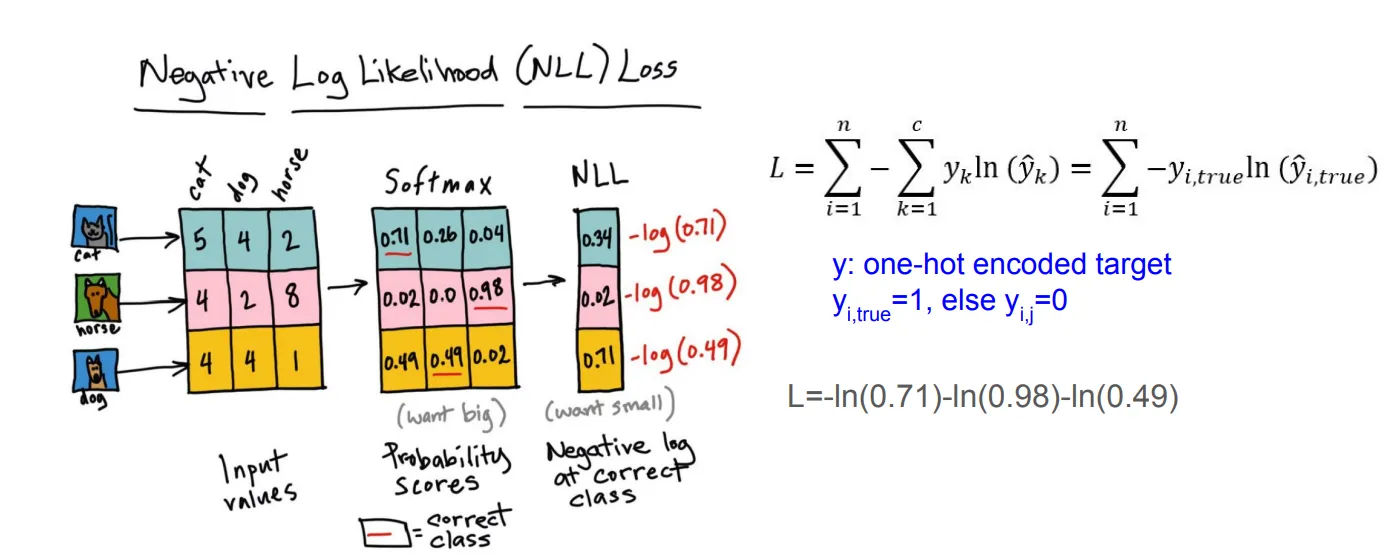
Contoh untuk satu instance:
| Target | Prediksi | Loss |
|---|---|---|
Untuk output sekuens, loss total dihitung sebagai penjumlahan cross entropy di setiap timestep.
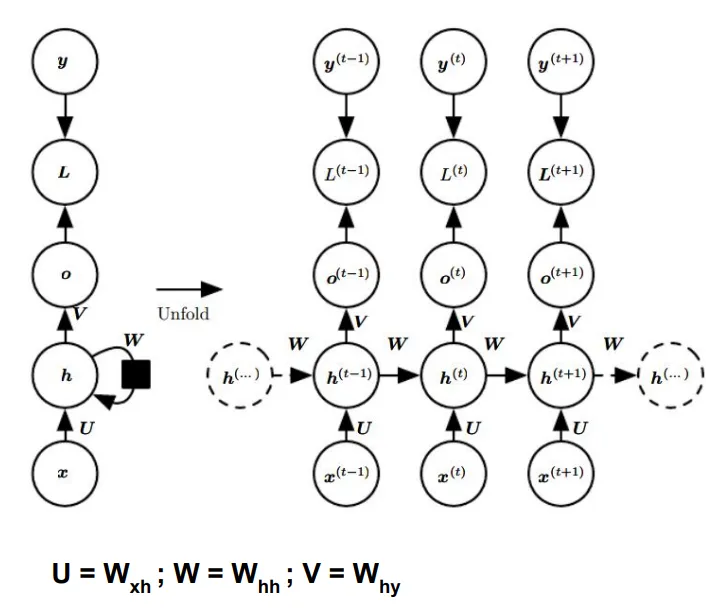
Sebagai contoh pada sekuens 4 timestep:
#Link to this headingAlgoritma BPTT
Prosedur BPTT terdiri dari tiga langkah. Pertama, forward pass menghitung output sekuens saat ini menggunakan formula forward propagation. Kedua, backward pass menghitung cross entropy error menggunakan output saat ini dan output aktual , kemudian menghitung gradien untuk setiap timestep pada jaringan yang di-unfold. Ketiga, karena bobot sama untuk semua timestep, gradien digabungkan sebelum bobot diperbarui.
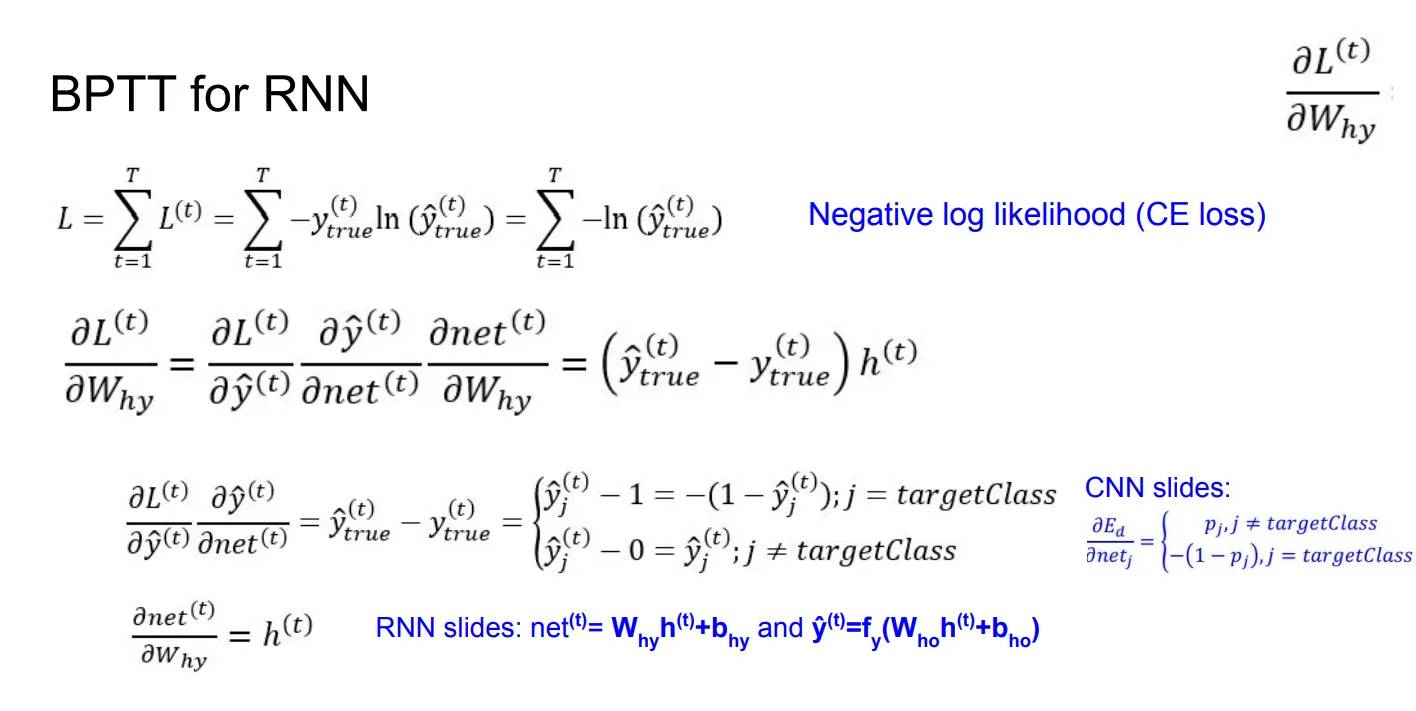
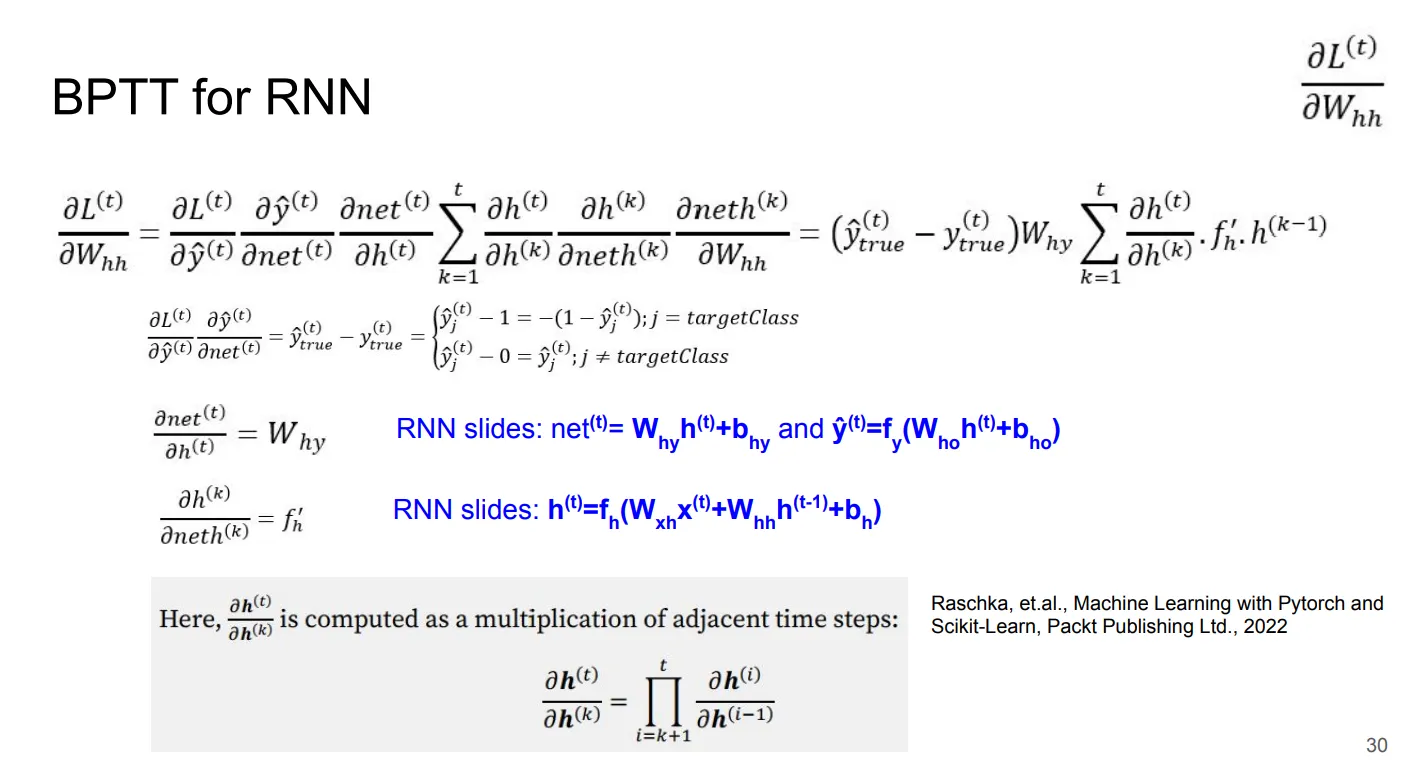
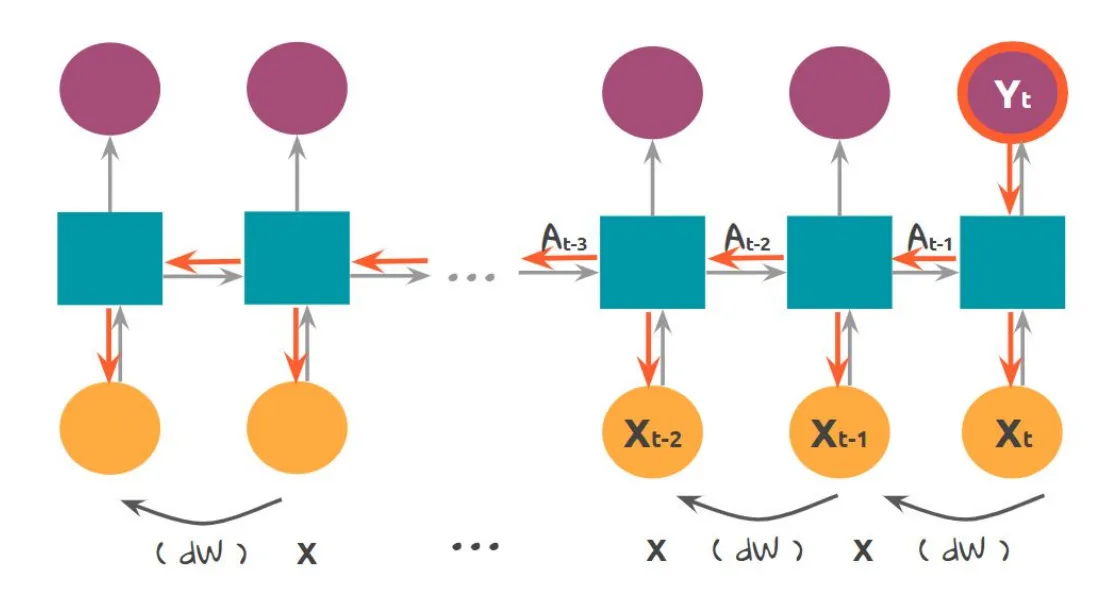
Contoh numerik backward pass pada :
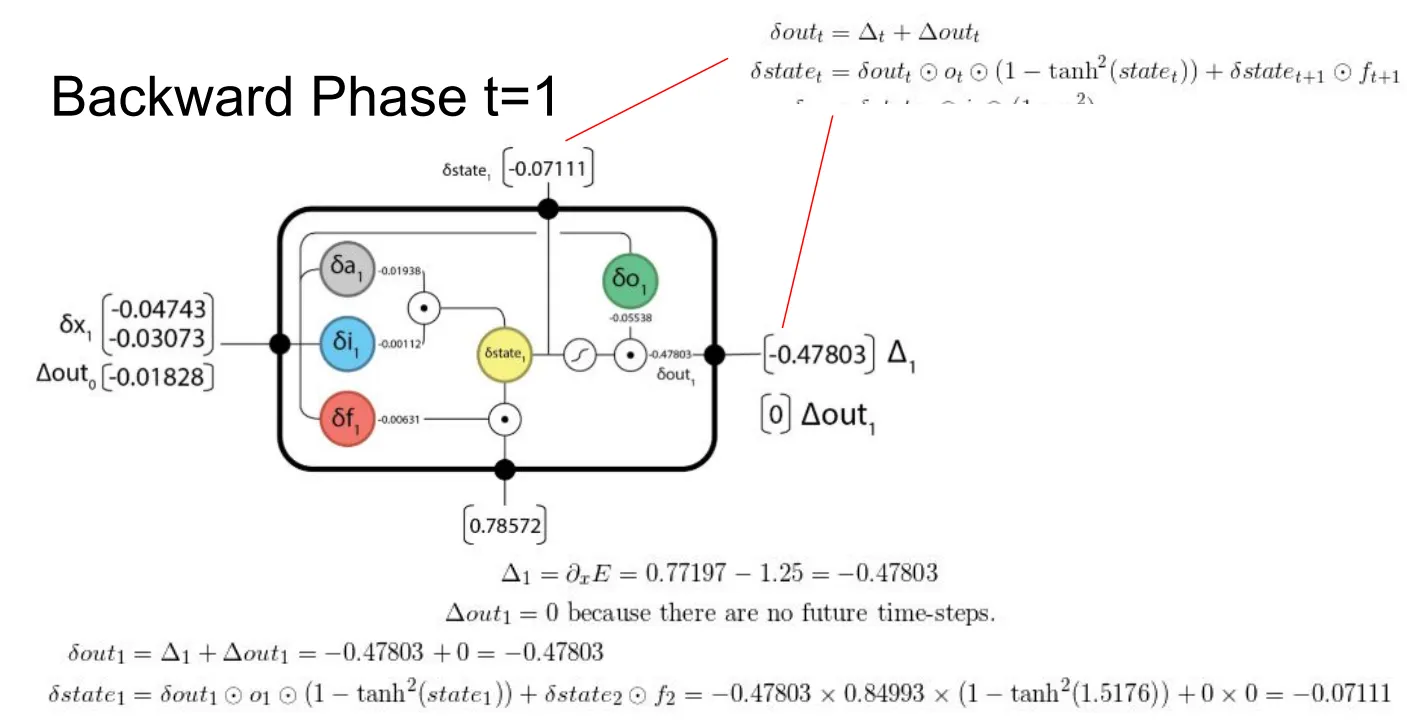
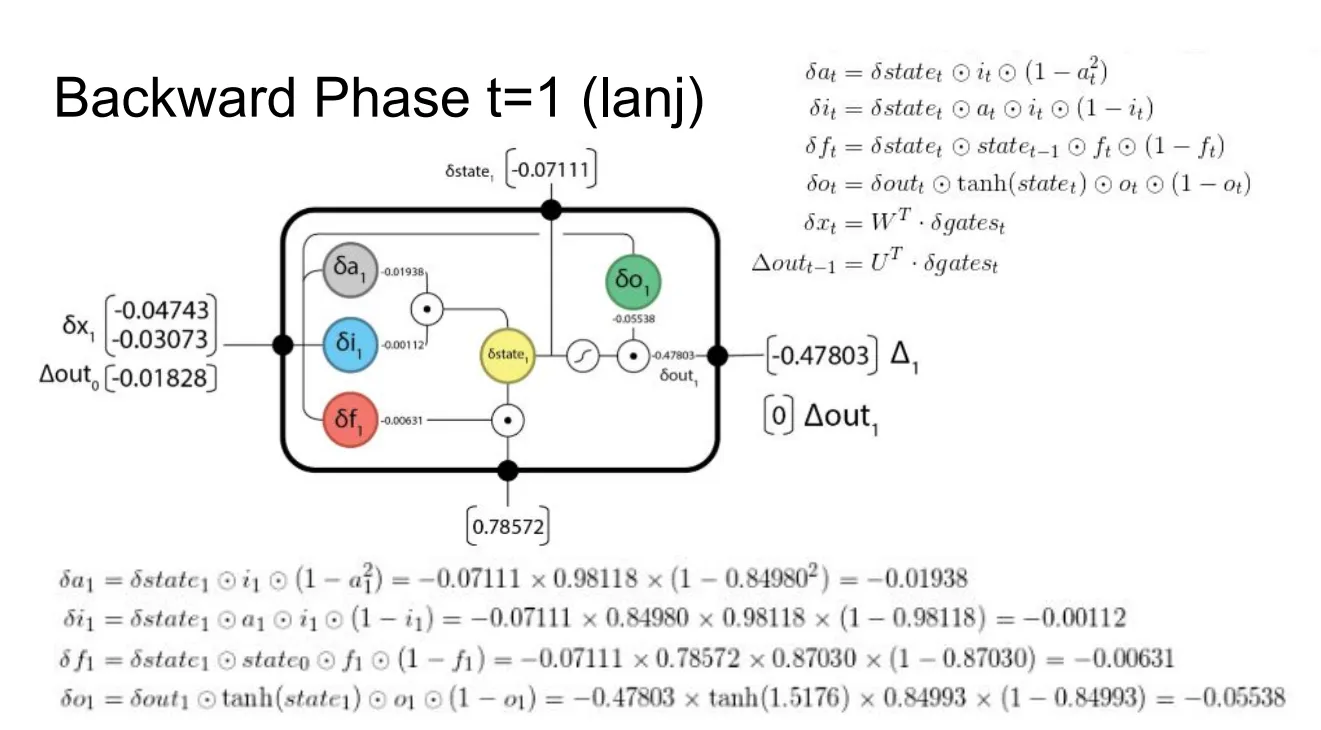
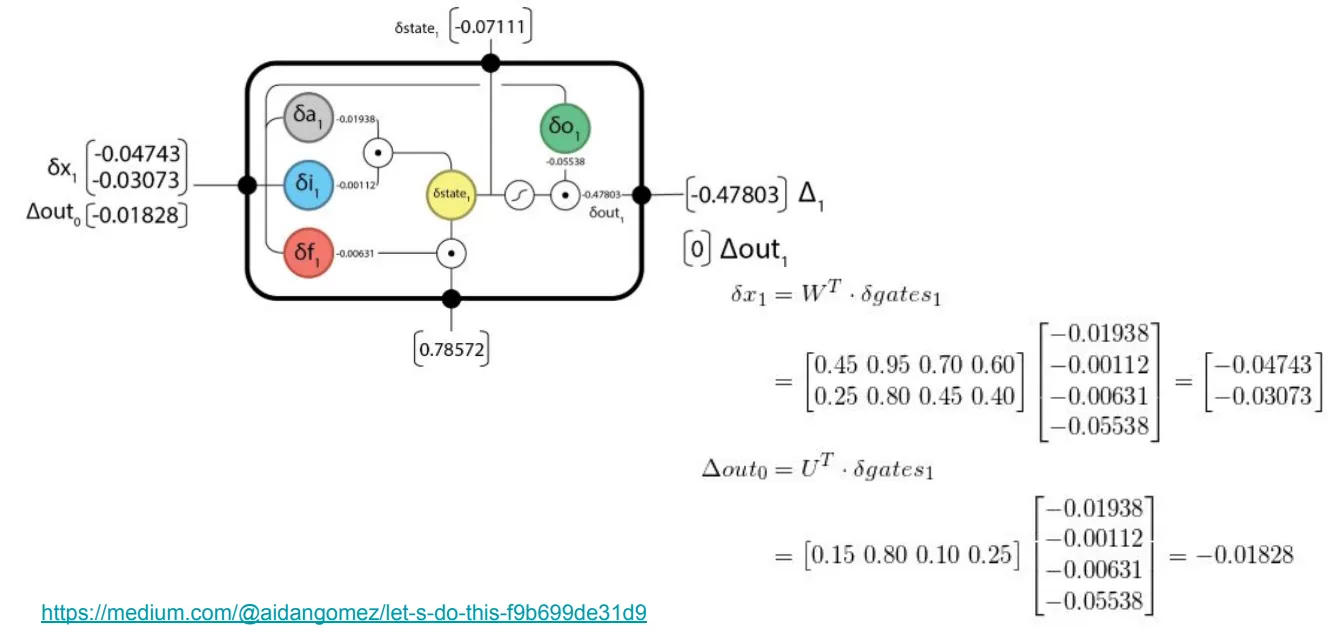
Contoh numerik backward pass pada :
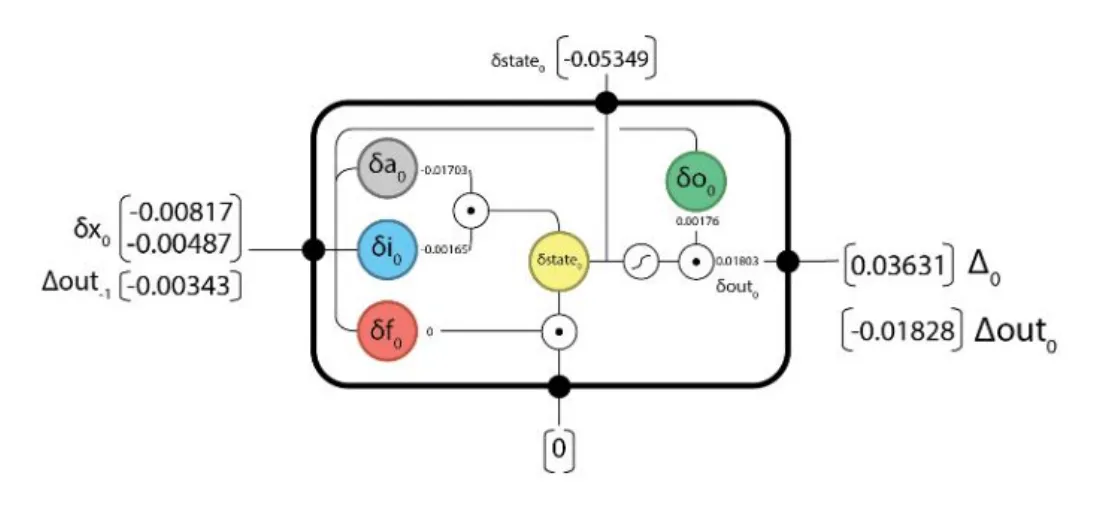
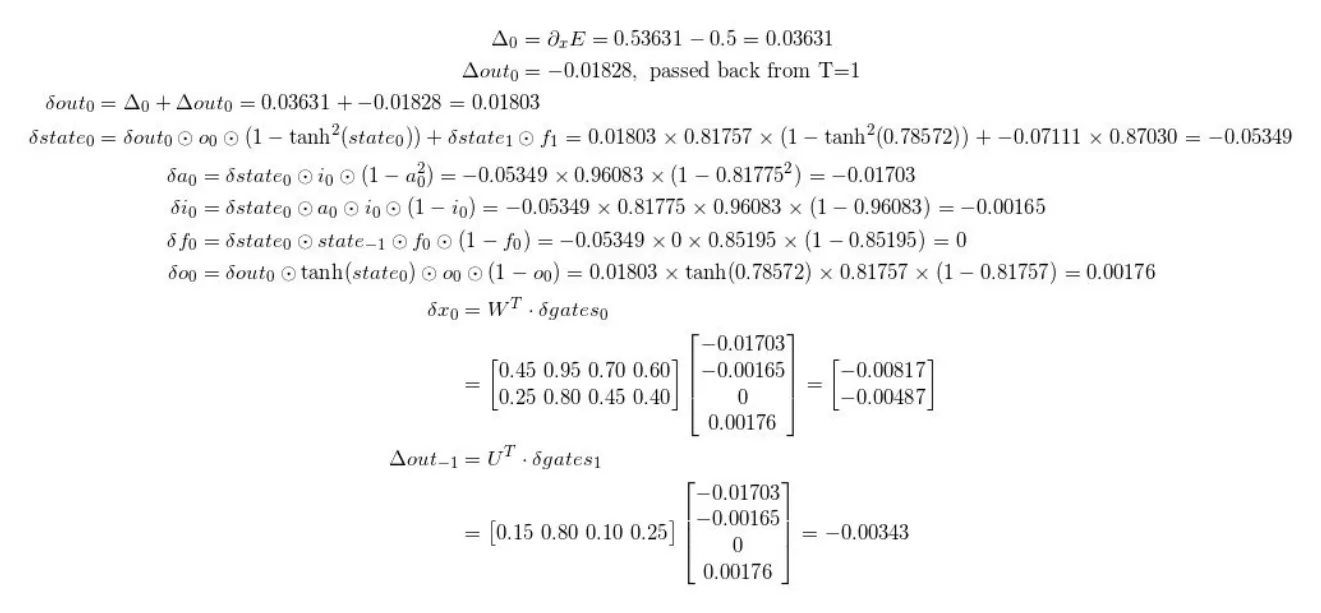
Update bobot:
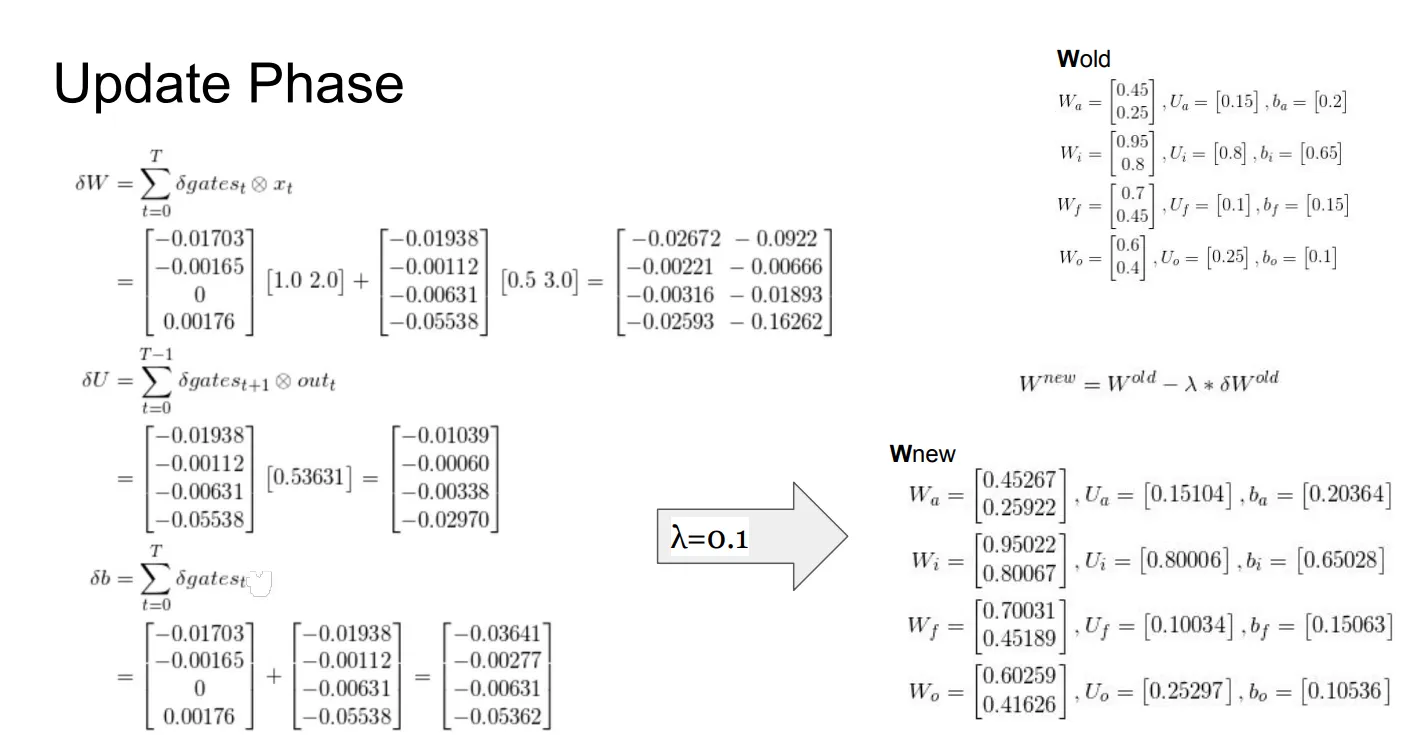
#Link to this headingTruncated BPTT
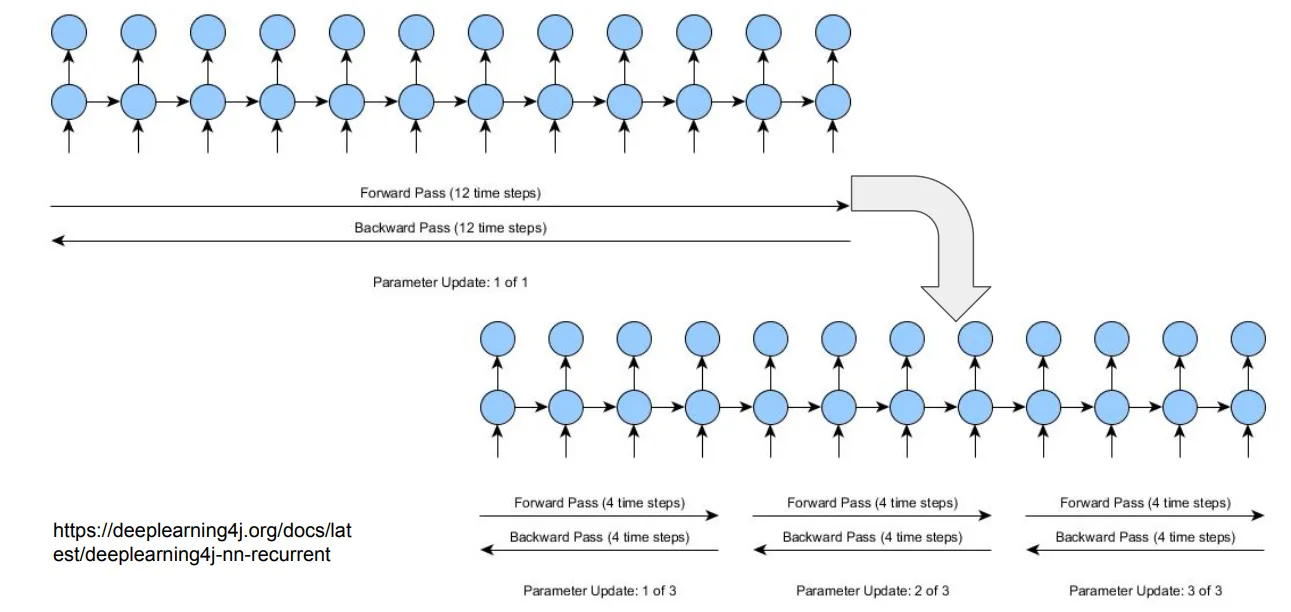
Truncated BPTT dikembangkan untuk mengurangi kompleksitas komputasi pembaruan parameter pada RNN. Algoritma ini membagi forward dan backward pass menjadi sekumpulan operasi lebih pendek dengan panjang yang ditentukan pengguna. Konsekuensinya, gradien dari timestep jauh tidak dapat mengalir kembali sejauh yang diperlukan. Sebagai contoh, dengan panjang segmen 4 dan sekuens panjang 10, informasi dari timestep 0 tidak dapat memengaruhi pembaruan weight dari timestep 10 melalui backpropagation. Dalam praktiknya, truncated BPTT bekerja dengan baik selama panjang segmen dipilih dengan tepat.
#Link to this headingVanishing Gradient
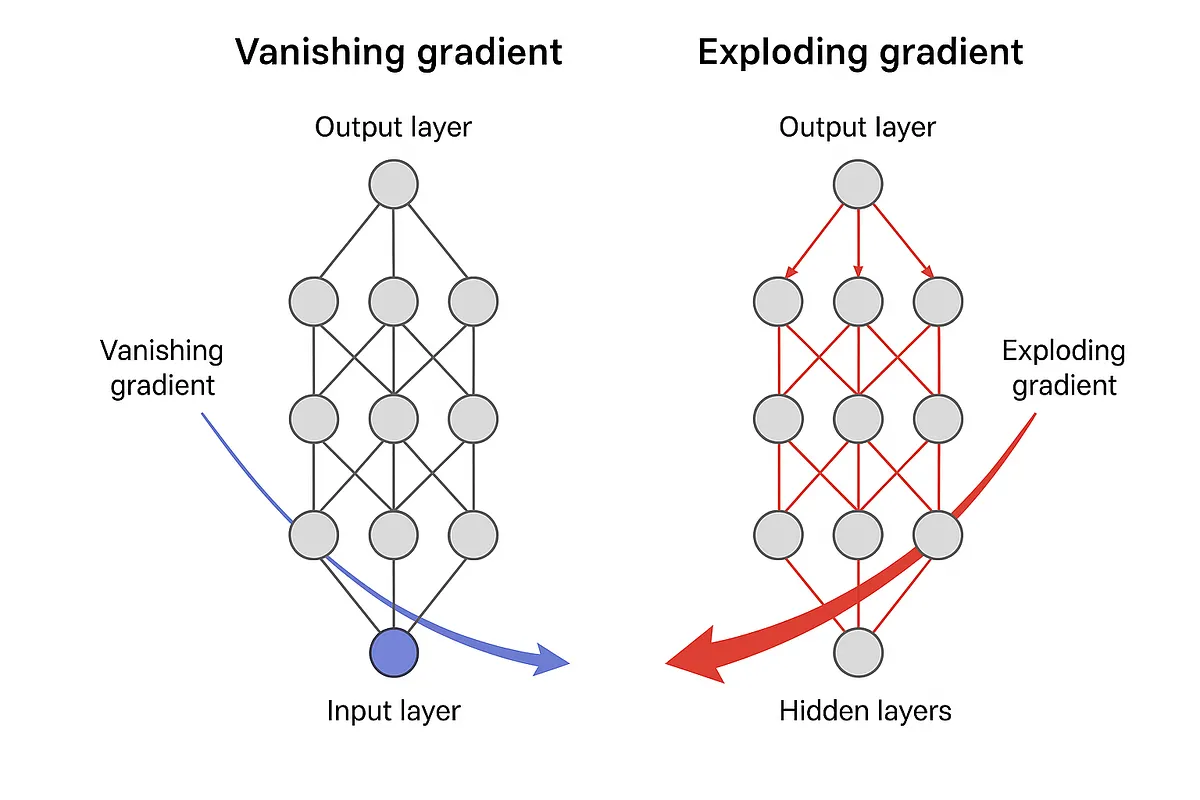
Backpropagation menghitung gradien menggunakan chain rule. Pada RNN yang panjang, gradien yang melalui banyak timestep melibatkan perkalian berulang turunan fungsi aktivasi. Fungsi sigmoid memiliki turunan maksimum sebesar sehingga gradien mengecil secara eksponensial seiring dengan bertambahnya jarak waktu. Weight pada timestep awal tidak mengalami pembaruan yang berarti sehingga pelatihan terhenti secara efektif.
LSTM mengatasi masalah ini melalui cell state yang bergerak lurus (constant error carousel), di mana gradien dapat mengalir tanpa dikalikan berulang kali oleh turunan aktivasi.
#Link to this headingEncoder-Decoder
Model encoder-decoder (atau sequence-to-sequence) bertujuan memetakan sekuens input ke sekuens output di mana panjang keduanya dapat berbeda. Contoh penerapannya meliputi mesin penerjemah (machine translation), question answering, dan video captioning.
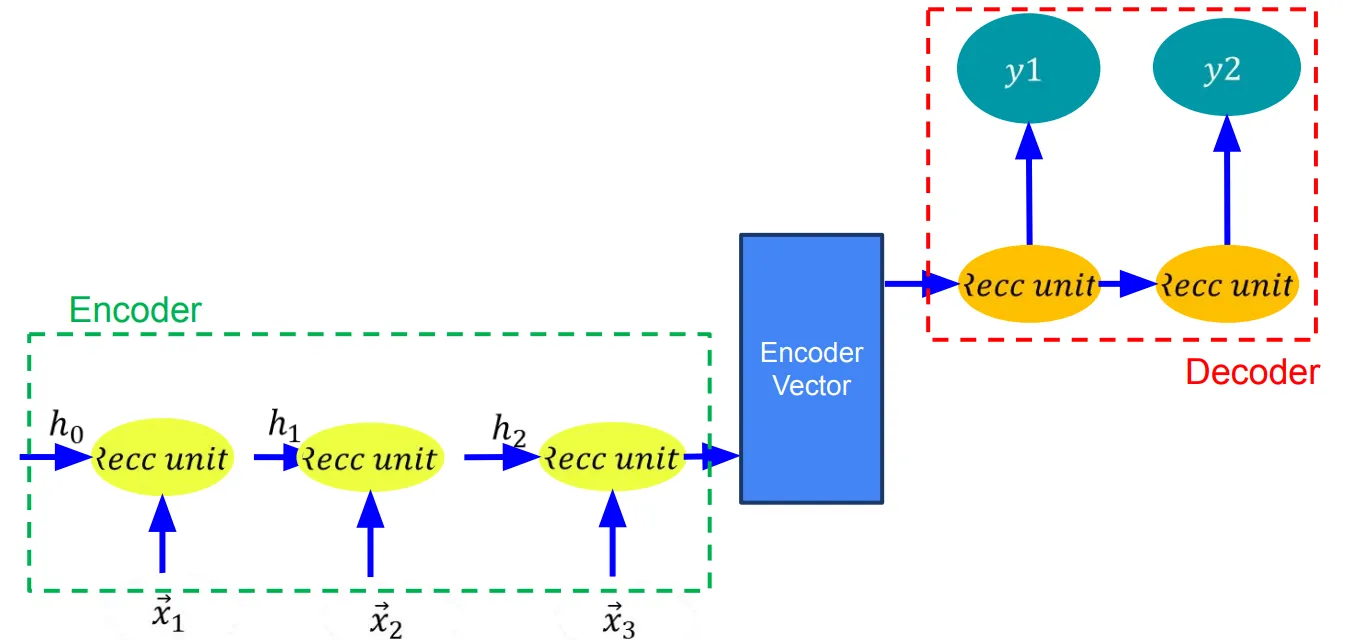
Encoder merupakan tumpukan beberapa unit rekuren di mana setiap unit menerima satu elemen input, mengumpulkan informasinya, dan menyebarkannya ke depan. Encoder vector adalah hidden state akhir yang dihasilkan encoder, merangkum informasi seluruh sekuens input sebagai representasi konteks. Decoder merupakan tumpukan unit rekuren yang masing-masing memprediksi output pada timestep , dengan encoder vector sebagai hidden state awal.