Reinforcement Learning
Reinforcement Learning atau RL adalah paradigma pembelajaran mesin untuk masalah pengambilan keputusan. Agen belajar dari interaksi dengan lingkungan, menerima reward, dan berusaha memilih aksi yang memaksimalkan akumulasi reward jangka panjang.
#Link to this headingPosisi RL dalam Machine Learning
Pembelajaran terawasi memakai pasangan data , sedangkan pembelajaran tak terawasi mencari struktur dari data tanpa label. RL berbeda karena data pelatihannya muncul dari interaksi. Agen memilih aksi, lingkungan merespons, lalu agen menerima observasi baru dan reward.
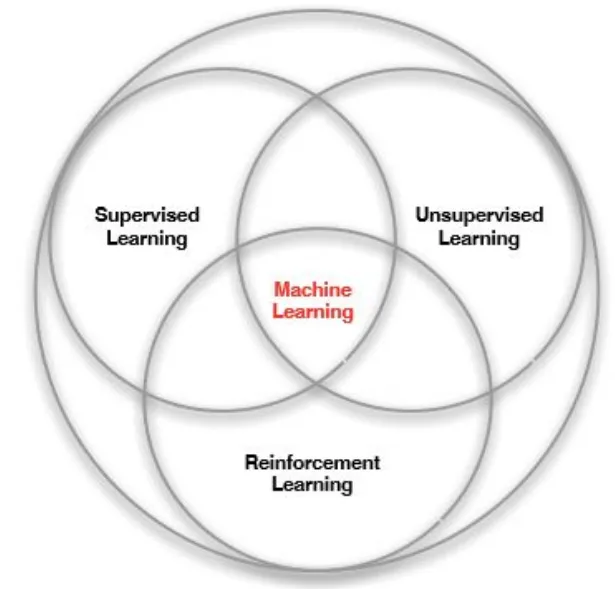
RL cocok ketika jawaban benar tidak tersedia secara langsung. Dalam banyak persoalan, tidak ada label optimal untuk setiap keadaan. Yang tersedia hanya sinyal keberhasilan setelah aksi dilakukan, bahkan kadang reward baru muncul jauh setelah keputusan awal.
Contohnya adalah robot berjalan, permainan strategi, pengendalian kendaraan, alokasi sumber daya, dan agen yang belajar melalui simulasi.
#Link to this headingKarakteristik RL
RL memiliki beberapa karakteristik yang membedakannya dari pembelajaran terawasi.
- Tidak ada supervisi langsung dalam bentuk label benar untuk setiap aksi.
- Umpan balik diberikan sebagai reward signal.
- Umpan balik dapat tertunda.
- Waktu penting karena aksi sekarang dapat memengaruhi keadaan dan reward di masa depan.
- Agen harus menyeimbangkan eksplorasi dan eksploitasi.
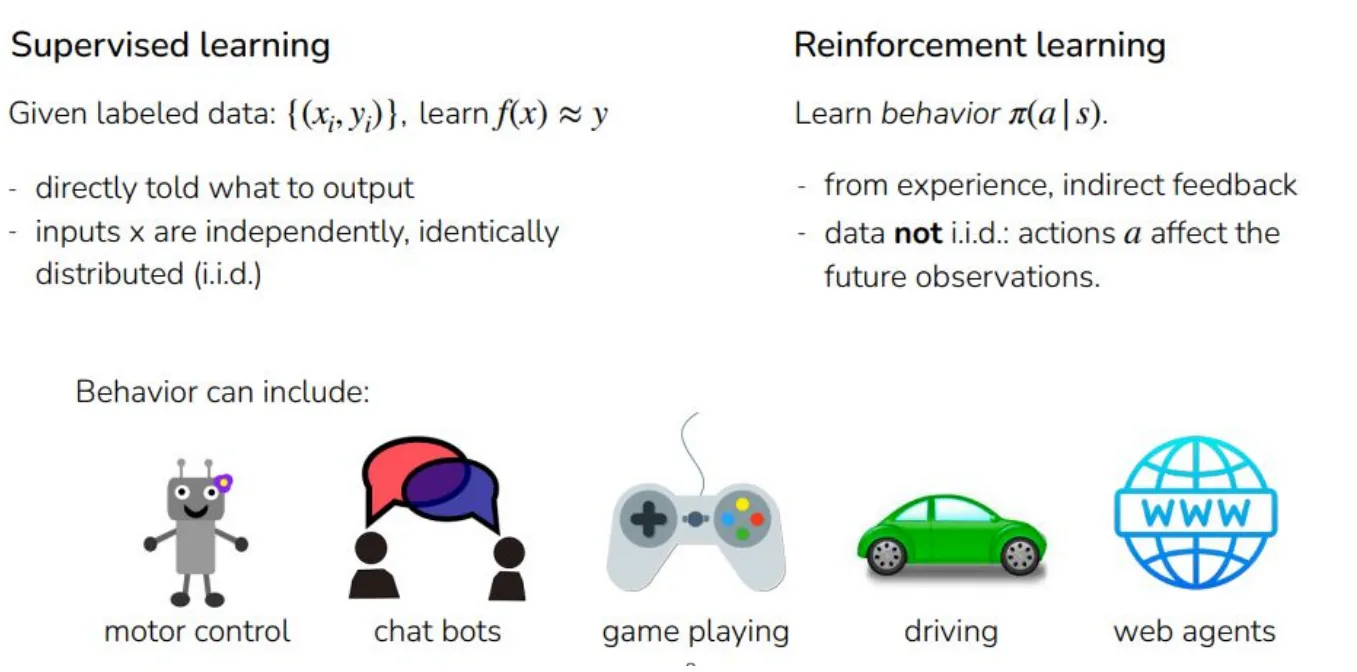
Inti RL bukan hanya memilih aksi yang memberi reward terbesar saat ini, tetapi memilih aksi yang memberi nilai terbaik dalam jangka panjang.
#Link to this headingAgen dan Lingkungan
RL dimodelkan sebagai interaksi antara agen dan lingkungan.
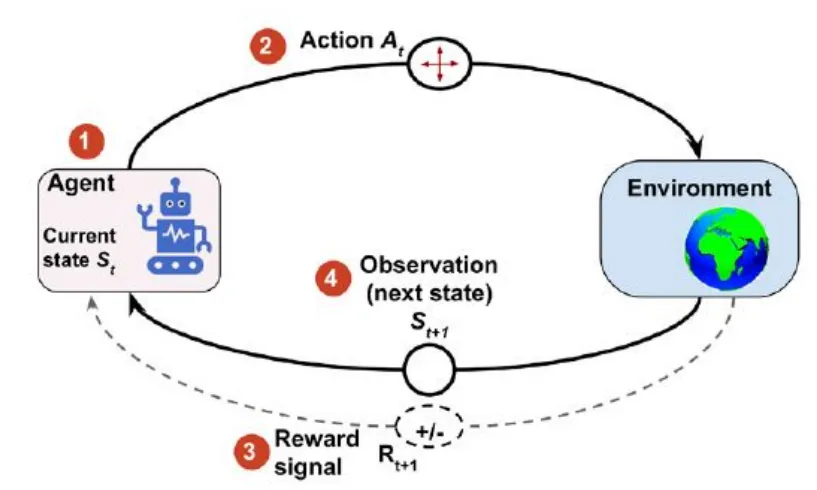
Pada setiap langkah waktu , agen menerima observasi dan reward . Berdasarkan informasi tersebut, agen memilih aksi . Lingkungan menerima aksi itu, lalu menghasilkan observasi berikutnya dan reward berikutnya .
Komponen utama agen meliputi state, policy, value function, dan kadang model dari lingkungan.
| Komponen | Makna |
|---|---|
| State | Representasi kondisi yang dipakai agen untuk mengambil keputusan |
| Action | Pilihan tindakan yang dapat dilakukan agen |
| Reward | Sinyal evaluasi dari lingkungan setelah aksi dilakukan |
| Policy | Aturan pemilihan aksi berdasarkan state |
| Value function | Estimasi nilai jangka panjang dari state atau pasangan state-action |
| Model | Perkiraan dinamika lingkungan, jika agen memilikinya |
#Link to this headingReward dan Value
Reward adalah sinyal langsung dari lingkungan. Value adalah estimasi manfaat jangka panjang. Keduanya tidak sama. Reward dapat kecil atau negatif saat ini, tetapi aksi tersebut tetap bisa baik jika membuka peluang reward besar di masa depan.
Contoh klasiknya adalah investasi. Keputusan yang mengurangi uang hari ini dapat memberi nilai tinggi jika keuntungan masa depan besar. Dalam permainan, mengorbankan satu langkah dapat membuka peluang menang beberapa langkah kemudian.
#Link to this headingPolicy
Policy adalah pemetaan dari state ke aksi. Policy sering dilambangkan dengan .
Policy deterministik memilih satu aksi untuk setiap state.
Policy stokastik memberi distribusi peluang atas aksi.
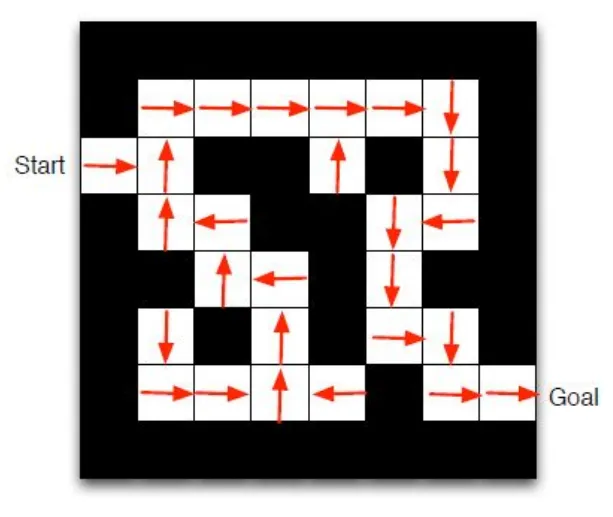
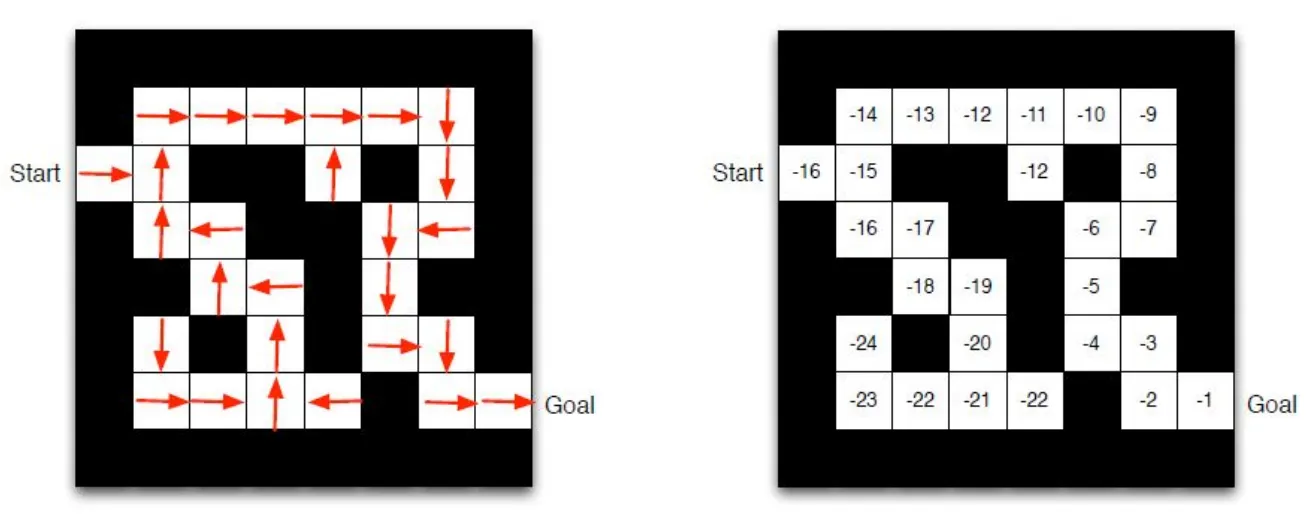
Pada contoh maze, panah di setiap sel dapat dibaca sebagai policy. Ketika agen berada di sel tersebut, panah menunjukkan aksi yang dipilih.
#Link to this headingValue Function
Value function mengukur seberapa baik suatu state dalam jangka panjang. Untuk policy , state value ditulis sebagai berikut.
Di sini adalah return, yaitu total reward terdiskonto dari waktu .
atau dalam bentuk penjumlahan berikut.
Nilai adalah discount factor dengan rentang . Jika kecil, agen lebih mementingkan reward dekat. Jika besar, agen lebih memperhitungkan reward jauh.
#Link to this headingAction-Value Function
Selain nilai state, RL juga memakai nilai pasangan state dan aksi. Nilai ini disebut action-value function atau Q-function.
Jika diketahui, agen dapat membandingkan aksi yang mungkin dilakukan pada state yang sama. Aksi dengan nilai lebih tinggi lebih menjanjikan secara jangka panjang.
Hubungan antara state value dan action value adalah sebagai berikut.
Untuk policy optimal, nilai state optimal dapat diperoleh dari action value optimal.
Policy optimal dapat ditemukan dengan memilih aksi yang memaksimalkan .
#Link to this headingModel
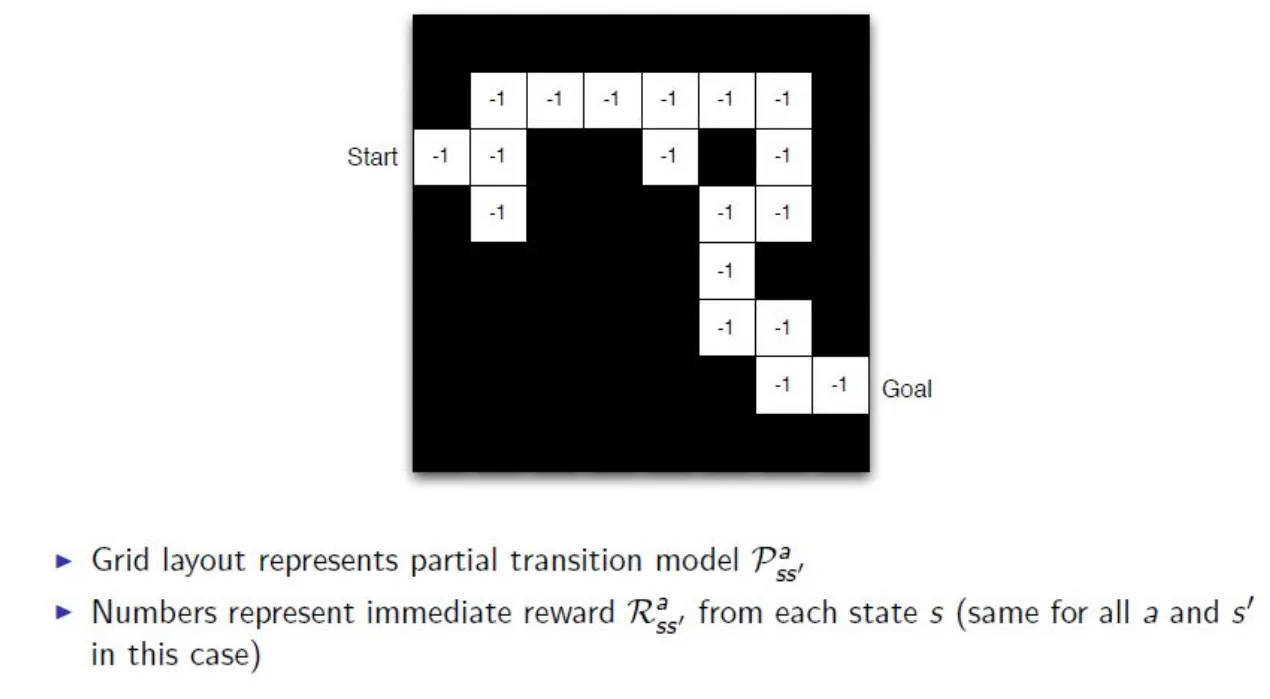
Model dalam RL adalah representasi dinamika lingkungan. Model dapat memberi tahu state berikutnya dan reward yang mungkin terjadi ketika agen melakukan aksi tertentu.
Secara probabilistik, model sering ditulis sebagai berikut.
Artinya, dari state dan aksi , lingkungan dapat berpindah ke state dan menghasilkan reward dengan peluang tertentu.
Jika model diketahui, agen dapat melakukan perencanaan. Jika model tidak diketahui, agen belajar langsung dari sampel interaksi.
#Link to this headingEksplorasi dan Eksploitasi
Eksploitasi berarti memilih aksi yang saat ini dipercaya paling baik. Eksplorasi berarti mencoba aksi lain untuk memperoleh informasi baru.
Keduanya perlu seimbang. Jika agen hanya mengeksploitasi, agen dapat terjebak pada pilihan yang tampak baik tetapi bukan yang terbaik. Jika agen terlalu banyak mengeksplorasi, agen membuang banyak kesempatan untuk memperoleh reward tinggi.
Contoh sederhana adalah memilih restoran. Eksploitasi berarti pergi ke restoran favorit. Eksplorasi berarti mencoba restoran baru yang mungkin lebih baik.
Salah satu strategi umum adalah -greedy. Dengan peluang , agen memilih aksi terbaik saat ini. Dengan peluang , agen memilih aksi acak.
#Link to this headingKategori Agen RL
Agen RL dapat dikategorikan berdasarkan komponen yang dipelajari.
| Kategori | Komponen utama | Penjelasan |
|---|---|---|
| Value based | Value function | Policy bersifat implisit melalui aksi bernilai tertinggi |
| Policy based | Policy | Agen langsung belajar fungsi pemilihan aksi |
| Actor critic | Policy dan value function | Actor memilih aksi, critic menilai aksi |
| Model free | Policy atau value function tanpa model lingkungan | Belajar langsung dari interaksi |
| Model based | Model lingkungan, kadang bersama policy atau value | Memakai model untuk merencanakan aksi |
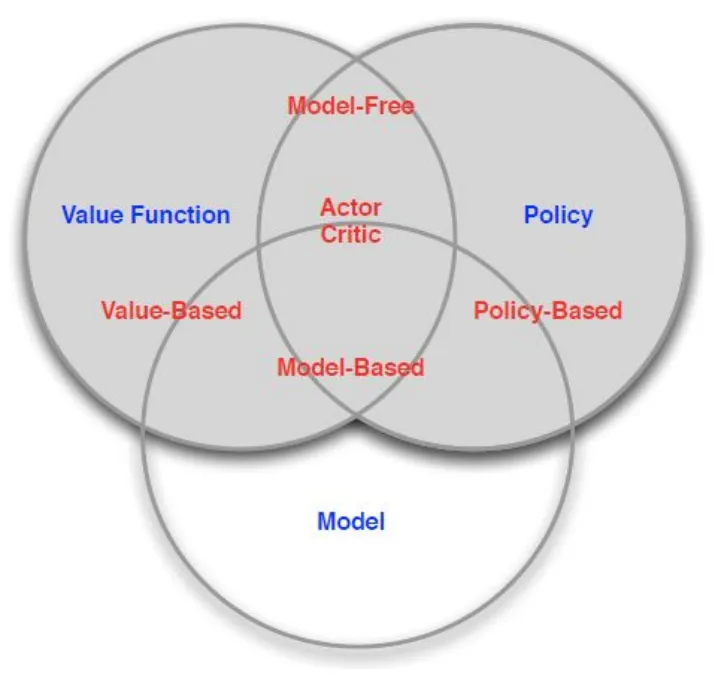
Materi kuliah ini berfokus pada model-free RL, khususnya Temporal Difference Learning melalui SARSA dan Q-learning.
#Link to this headingMarkov Decision Process
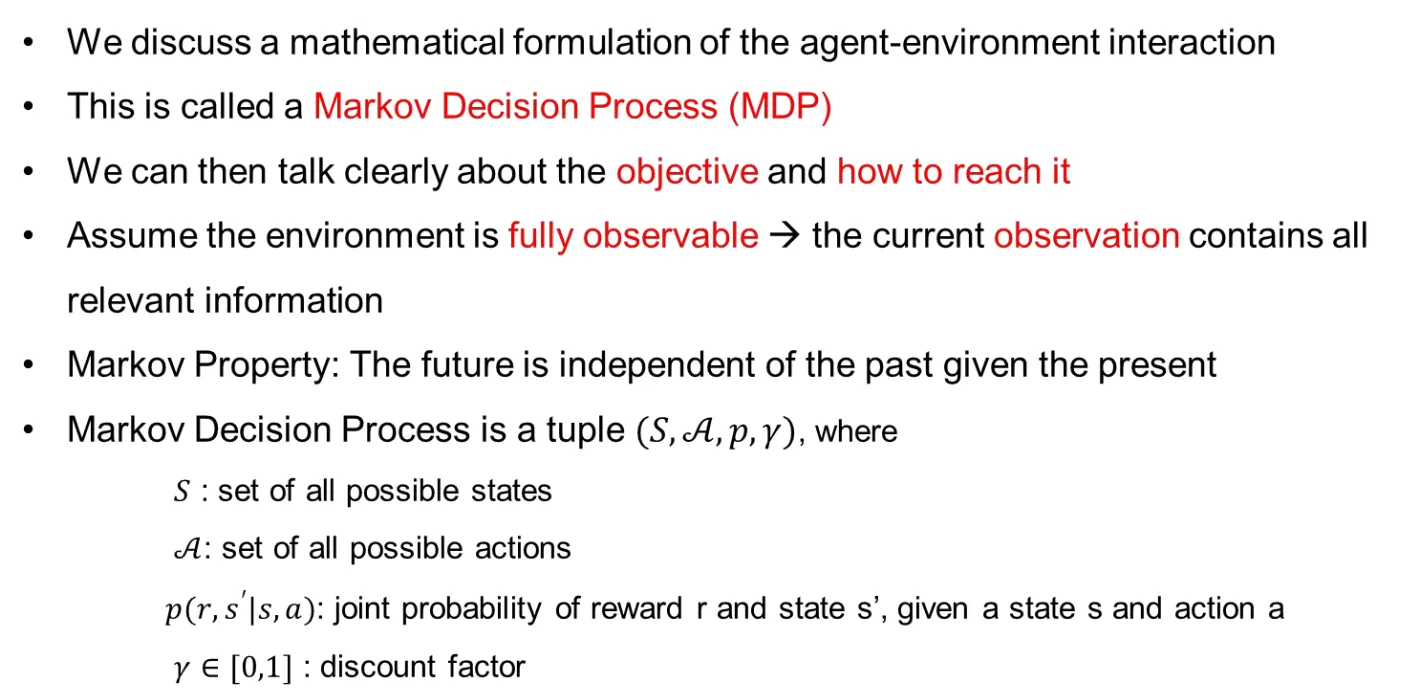
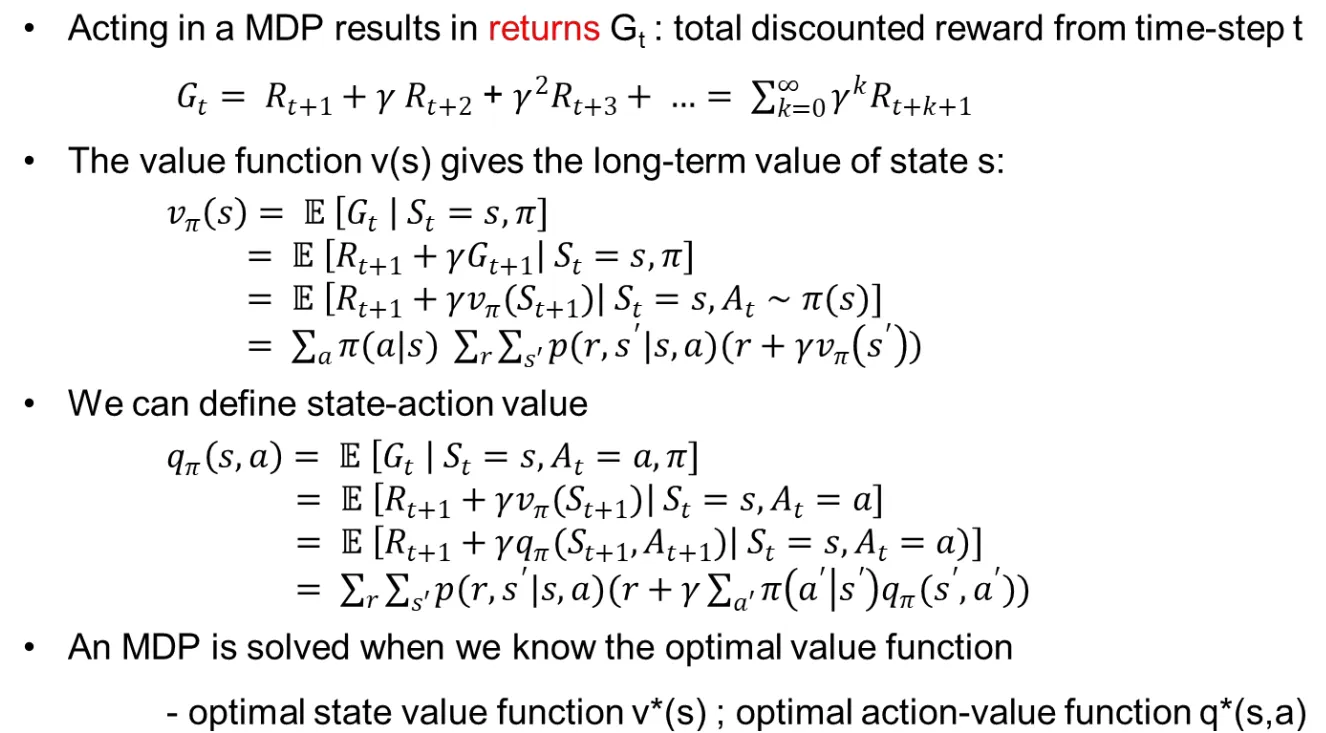
Reinforcement Learning sering diformalkan sebagai Markov Decision Process atau MDP. Sebuah MDP terdiri atas state, aksi, probabilitas transisi, reward, dan discount factor.
Properti Markov menyatakan bahwa masa depan hanya bergantung pada state saat ini dan aksi saat ini, bukan seluruh sejarah sebelumnya.
Dengan MDP, persoalan RL menjadi persoalan mencari policy yang memaksimalkan expected return.
#Link to this headingReturn dan Bellman Equation
Return dari waktu adalah total reward terdiskonto.
Persamaan ini menunjukkan struktur rekursif. Nilai sekarang bergantung pada reward berikutnya dan nilai masa depan.
Untuk state value, bentuknya adalah sebagai berikut.
Untuk action value, bentuknya adalah sebagai berikut.
#Link to this headingTemporal Difference Learning
Temporal Difference Learning atau TD Learning belajar dari sampel parsial. Berbeda dengan Monte Carlo, TD tidak perlu menunggu episode selesai untuk melakukan pembaruan.
Ide dasarnya adalah bootstrapping. Estimasi saat ini diperbarui menggunakan reward yang baru diamati dan estimasi nilai state berikutnya.
Untuk value function, bentuk update-nya adalah sebagai berikut.
Bagian dalam kurung disebut TD error.
Pada TD control, pembelajaran diterapkan pada . Dua algoritma yang dibahas adalah SARSA dan Q-learning.
#Link to this headingSARSA
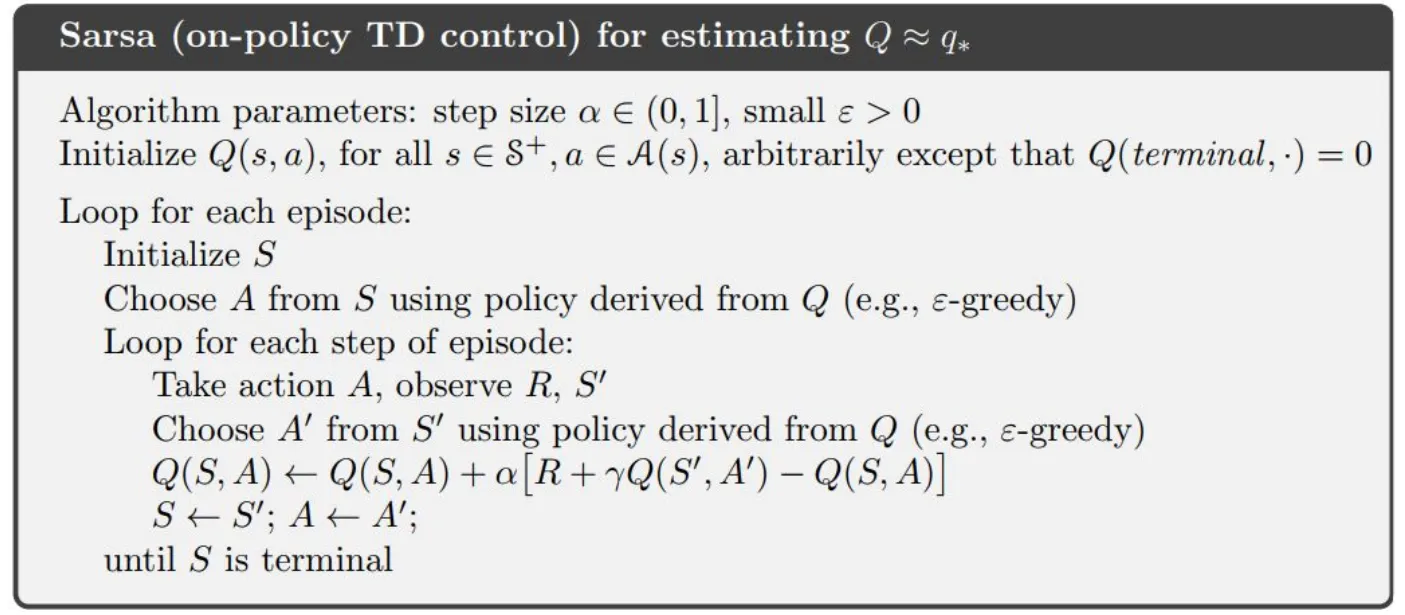
SARSA adalah algoritma TD control on-policy. Nama SARSA berasal dari lima kejadian yang dipakai dalam update.
Karena memakai yang benar-benar dipilih oleh policy saat ini, SARSA belajar tentang policy yang sedang dijalankan.
Formula update SARSA adalah sebagai berikut.
#Link to this headingContoh SARSA
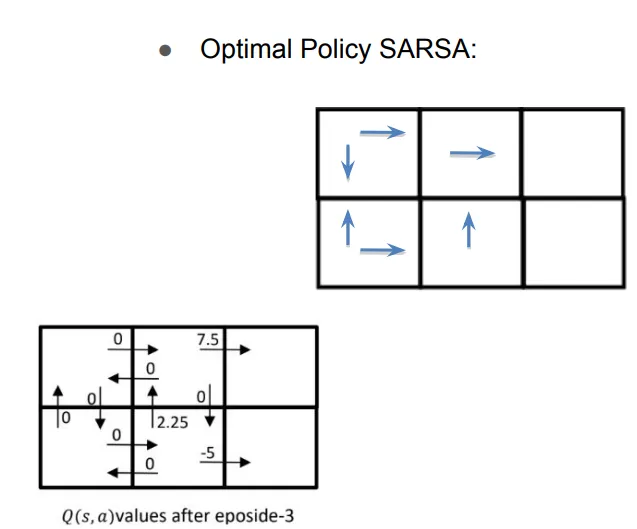
Misalkan dan . Semua nilai awal adalah 0. Terdapat tiga episode pada GridWorld.
| Episode | Urutan state |
|---|---|
| 1 | , lalu , lalu , lalu |
| 2 | , lalu , lalu |
| 3 | , lalu , lalu , lalu |
Pada episode 1, dua perpindahan pertama memiliki reward 0 dan nilai berikutnya masih 0, sehingga nilai Q tetap 0. Pada perpindahan dari ke terminal , reward adalah 10.
Pada episode 2, perpindahan dari ke terminal buruk memiliki reward .
Pada episode 3, nilai yang sudah bernilai 5 ikut memengaruhi update sebelumnya.
Kemudian nilai menuju terminal baik diperbarui lagi.
#Link to this headingQ-Learning
Q-learning adalah algoritma TD control off-policy. Agen dapat mengikuti policy eksploratif saat mengumpulkan pengalaman, tetapi update-nya belajar menuju policy greedy optimal.
Perbedaan utama dari SARSA terletak pada target update. SARSA memakai aksi berikutnya yang benar-benar dipilih. Q-learning memakai aksi terbaik yang mungkin pada state berikutnya.
Formula update Q-learning adalah sebagai berikut.
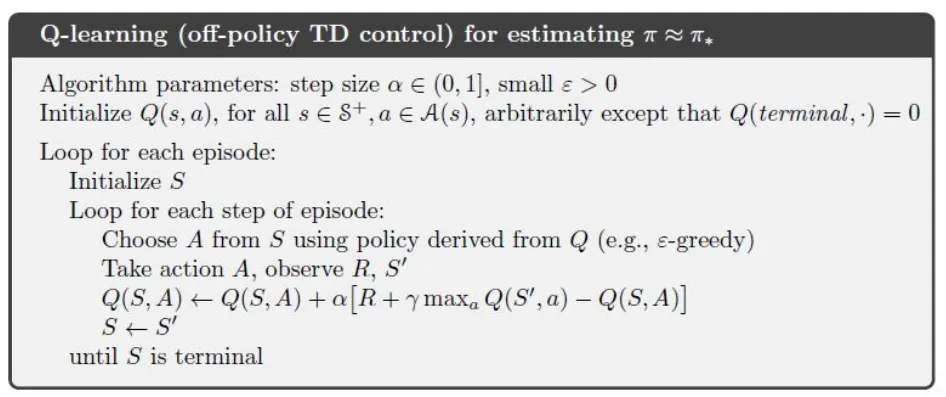
Karena memakai , Q-learning cenderung lebih optimistis dibanding SARSA. SARSA memperhitungkan aksi yang benar-benar akan diambil oleh policy eksploratif, sedangkan Q-learning memperkirakan seolah agen akan memilih aksi terbaik pada langkah berikutnya.
#Link to this headingSARSA dan Q-Learning
| Aspek | SARSA | Q-learning |
|---|---|---|
| Jenis | On-policy | Off-policy |
| Target update | ||
| Aksi berikutnya | Aksi yang benar-benar dipilih | Aksi bernilai maksimum |
| Efek eksplorasi | Masuk ke proses belajar | Tidak langsung masuk ke target optimal |
| Kecenderungan | Lebih hati-hati | Lebih greedy terhadap nilai optimal |
#Link to this headingDeep Q-Network
Tabular Q-learning menyimpan nilai dalam tabel. Cara ini tidak cukup ketika state sangat banyak atau kontinu, misalnya citra permainan. Deep Q-Network atau DQN mengganti tabel Q dengan neural network.
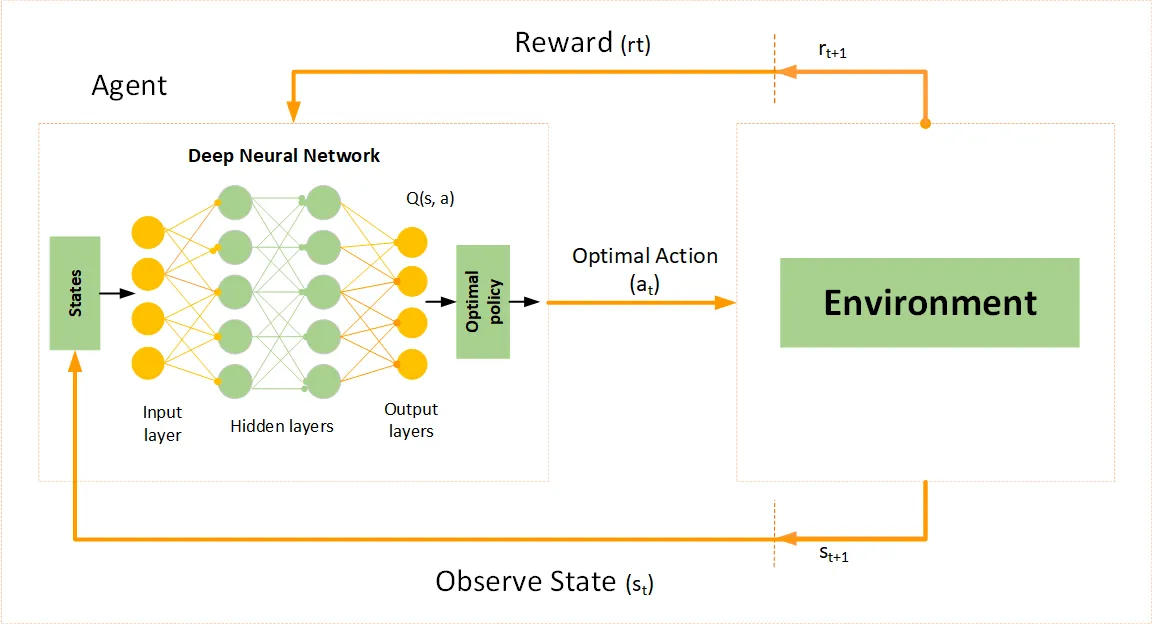
DQN menerima fitur state sebagai input dan menghasilkan vektor Q-value untuk semua aksi.
Pemilihan aksi dapat dilakukan dengan memilih nilai terbesar.
#Link to this headingReplay Memory
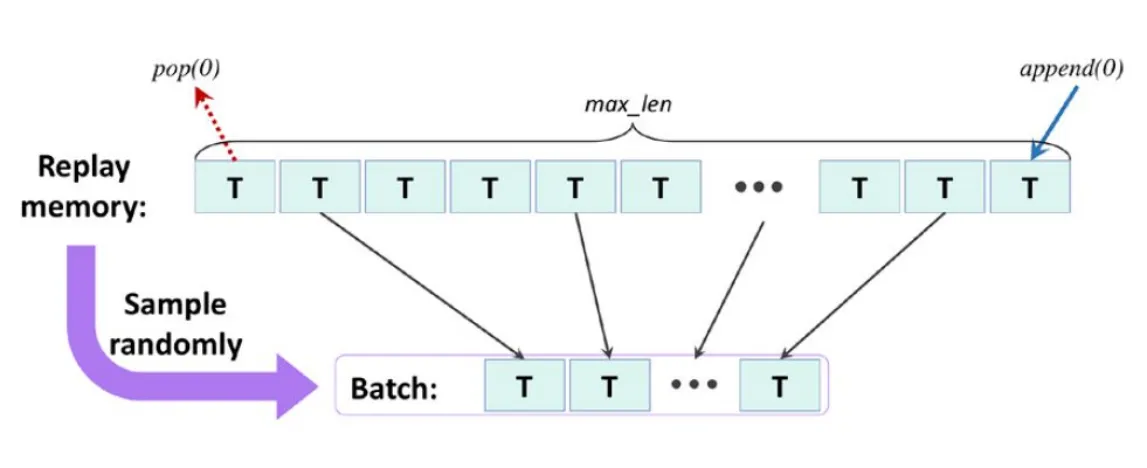
DQN memakai replay memory karena sampel dari episode berurutan tidak bersifat IID. Jika model dilatih langsung dari urutan terbaru, pembaruan bobot dapat terlalu berkorelasi dan tidak stabil.
Replay memory menyimpan transisi dalam bentuk berikut.
Kemudian mini-batch diambil secara acak dari buffer memori untuk menghitung loss dan memperbarui parameter jaringan. Dengan cara ini, distribusi data pelatihan lebih stabil dan pengalaman lama tetap dapat dipakai kembali.
#Link to this headingTarget Value untuk DQN
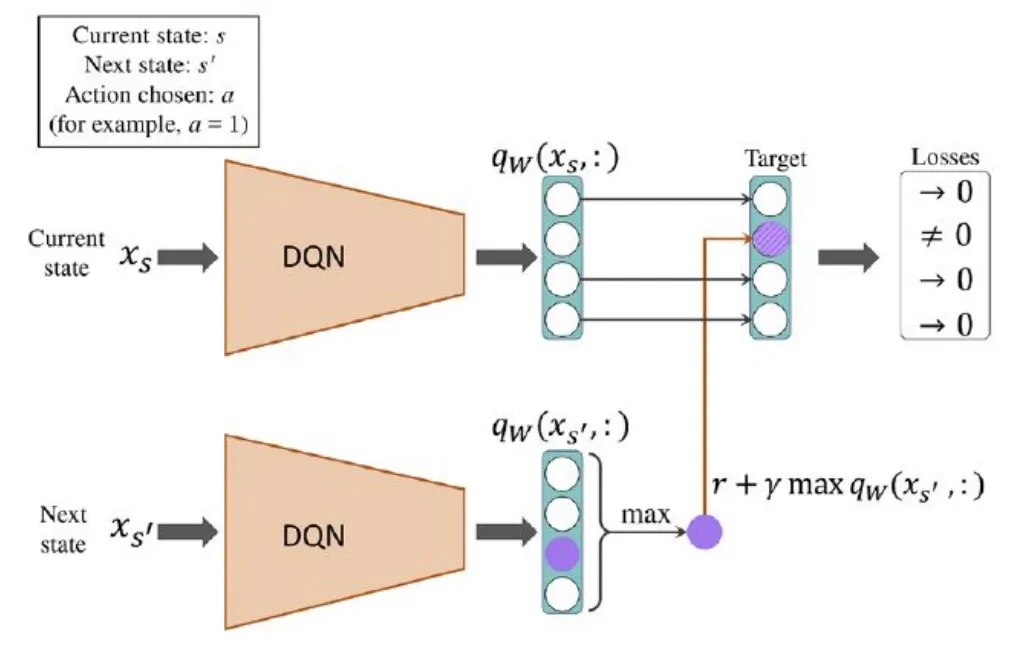
DQN memperlakukan pembelajaran Q-value sebagai persoalan regresi. Untuk setiap transisi, model melakukan dua forward pass.
- Forward pass pada state saat ini untuk memperoleh .
- Forward pass pada state berikutnya untuk memperoleh .
Target untuk aksi yang dipilih adalah sebagai berikut.
Jika transisi sudah terminal, bagian nilai masa depan dihilangkan.
Loss dihitung hanya pada komponen aksi yang dipilih. Komponen aksi lain tetap mengikuti prediksi lama agar pembaruan tidak mengubah target seluruh aksi sekaligus.
#Link to this headingRingkasan
Reinforcement Learning mempelajari keputusan dari interaksi. Agen tidak diberi jawaban benar untuk setiap state, tetapi belajar dari reward dan konsekuensi jangka panjang. Policy menentukan aksi, value function menilai masa depan, dan tradeoff eksplorasi serta eksploitasi menentukan kualitas pengalaman yang dikumpulkan.
TD Learning memungkinkan pembelajaran tanpa menunggu episode selesai. SARSA belajar secara on-policy dari aksi yang benar-benar diambil, sedangkan Q-learning belajar secara off-policy menggunakan aksi terbaik pada state berikutnya. DQN memperluas Q-learning dengan neural network, replay memory, dan target value berbasis bootstrapping.