Ensemble Methods
Ensemble methods adalah teknik yang menggabungkan beberapa model machine learning untuk membentuk satu predictor yang lebih kuat dan akurat.
#Link to this headingWhy Ensemble Methods?
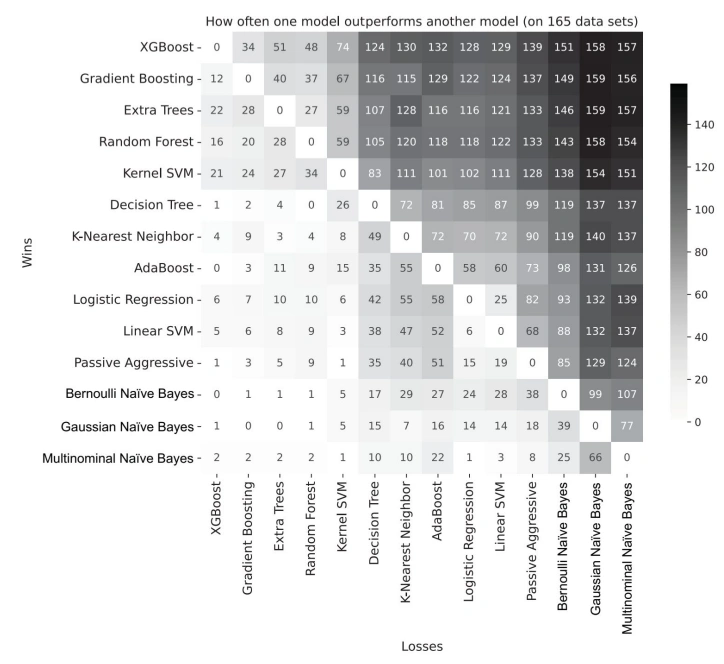
Ensemble methods sangat berhasil pada structured data:
- Anthony Goldbloom (CEO Kaggle, 2015): tiga algoritma paling sukses untuk structured problems adalah XGBoost, Random Forest, dan Gradient Boosting, semuanya ensemble methods.
- Olson et al. (2018) membandingkan 13 algoritma ML dari scikit-learn pada PMLB (Penn Machine Learning Benchmarks). Ensemble methods (khususnya tree-based ensembles) mengungguli semua metode lainnya dan dianggap sebagai state of the art untuk structured datasets.
#Link to this headingThe Wisdom of Crowds
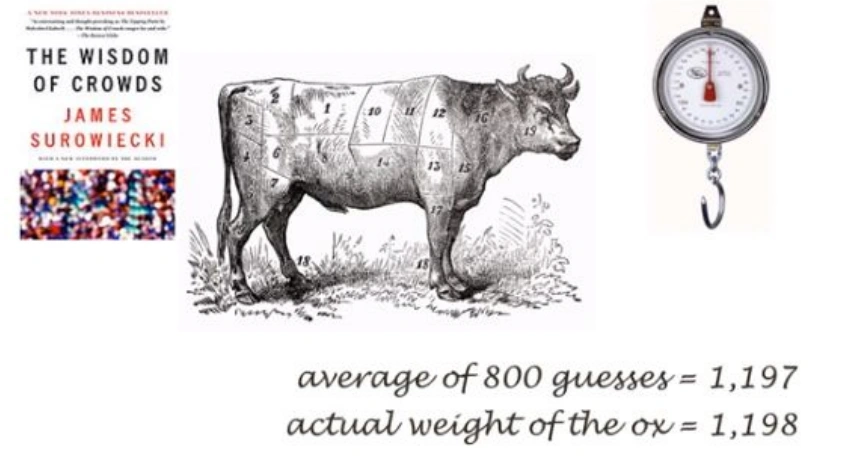
Wisdom of the crowd adalah proses mempertimbangkan pendapat kolektif dari sekelompok individu, alih-alih hanya mengandalkan satu expert, untuk menjawab sebuah pertanyaan.
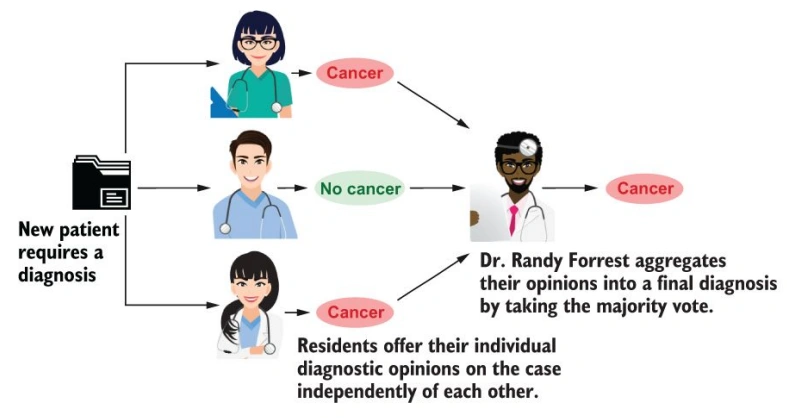
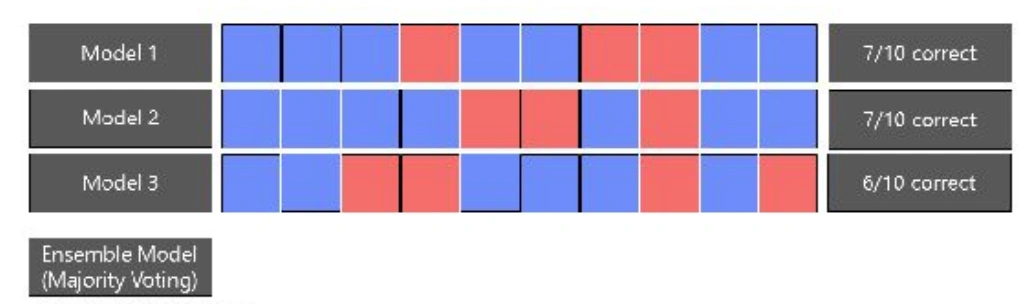
Dr. Randy Forrest bekerja di teaching hospital dengan tim berkeahlian beragam. Setiap kali mendapat kasus baru, ia meminta pendapat semua resident-nya, lalu memilih final diagnosis secara demokratis, yaitu diagnosis yang paling umum dari semua yang diajukan.
Prinsip Ensemble Methods: Ensemble method bergantung pada konsep wisdom of the crowd: jawaban gabungan dari banyak model sering kali lebih baik daripada jawaban dari satu model individu.
Dua kunci keberhasilan ensemble:
- Ensemble diversity: variasi pendapat yang dapat dipilih (training)
- Model aggregation: penggabungan menjadi satu final decision (inference)
Diversity dan independence penting karena keputusan kolektif terbaik merupakan hasil dari perbedaan pendapat dan adu gagasan, bukan dari konsensus atau kompromi.
#Link to this headingTerminologi
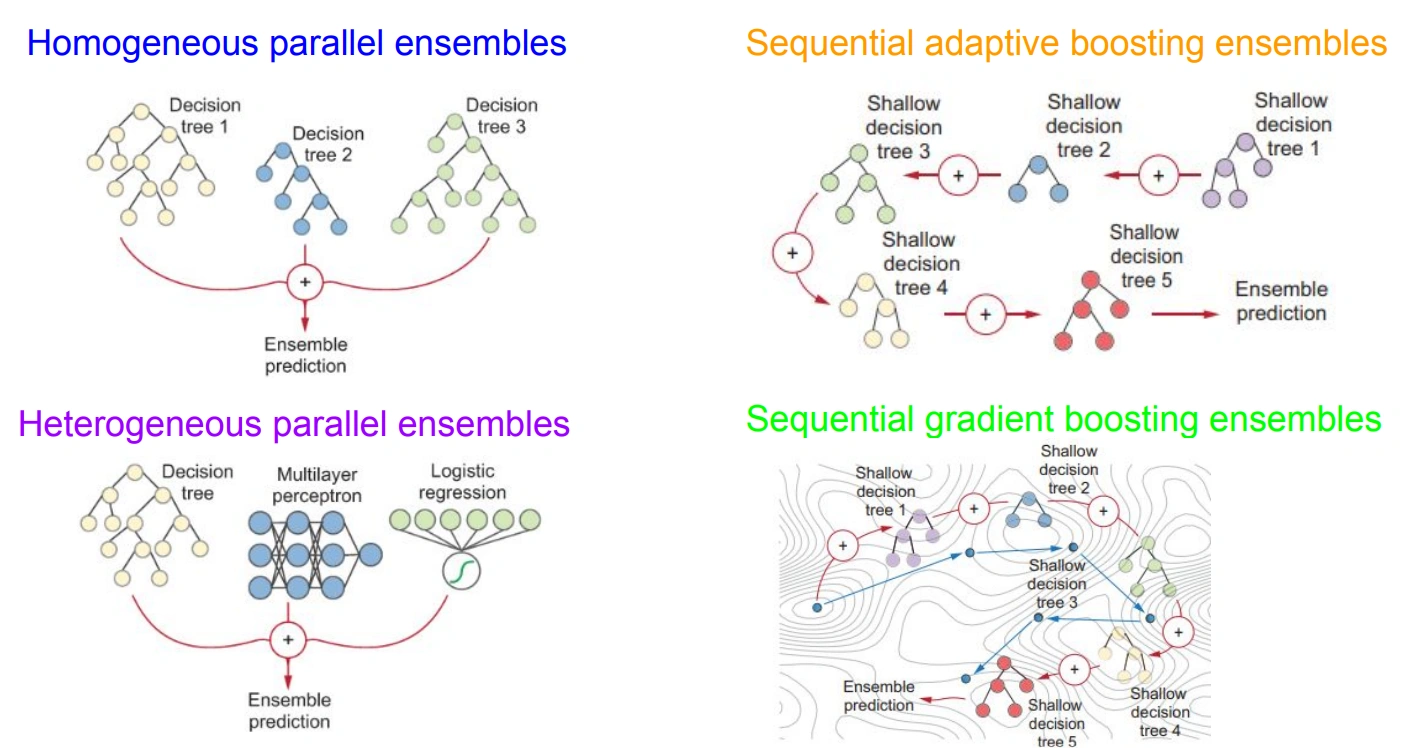
| Istilah | Definisi |
|---|---|
| Base models/learners/estimators | Individual machine-learning models |
| Parallel ensemble | Setiap base model dilatih secara independen (paralel) |
| Sequential ensemble | Base model dilatih secara bertahap, tiap model memperbaiki model sebelumnya |
| Homogeneous ensemble | Semua base learners menggunakan algoritma ML yang sama |
| Heterogeneous ensemble | Base learners menggunakan algoritma ML yang berbeda |
#Link to this headingParallel Ensembles
Parallel ensembles memanfaatkan independensi dari setiap base estimator.
#Link to this headingHomogeneous Parallel Ensembles
Masalah: Dengan hanya satu dataset, bagaimana mendapatkan model-model yang berbeda dengan algoritma yang sama?
Jawaban: Buat variasi data training menggunakan bootstrap sampling.
#Link to this headingBagging (Bootstrap Aggregating)
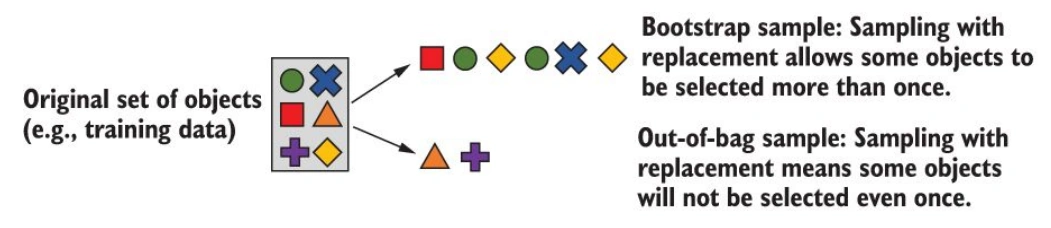
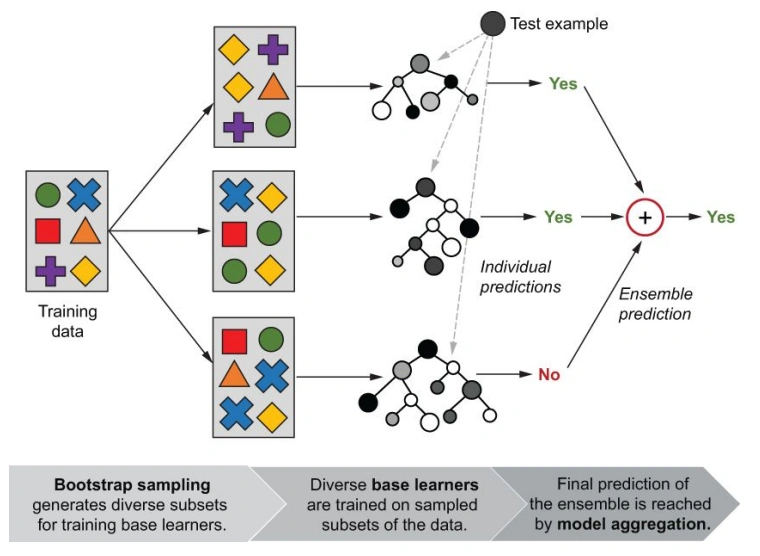
Training: Bootstrap sampling (sampling with replacement) menghasilkan replika dataset yang berbeda satu sama lain namun diambil dari dataset asli, menjamin ensemble diversity.
Prediction: Model aggregation menggabungkan prediksi dari semua base learners:
- Klasifikasi: majority voting
- Regresi: simple averaging
Contoh Bootstrap Sampling:
import numpy as np

# Sampling 50 indices with replacement dari range 0-49
bag = np.random.choice(range(0, 50), size=50, replace=True)
# Out-of-Bag (OOB) samples: yang tidak terpilih
oob = np.setdiff1d(range(0, 50), bag)
OOB (Out-of-Bag) Score: Rata-rata sekitar 37% data tidak masuk ke setiap bootstrap sample. Data OOB ini dapat digunakan sebagai validation set built-in tanpa perlu dedicated test set.
from sklearn.datasets import load_breast_cancer
from sklearn.ensemble import BaggingClassifier
from sklearn.tree import DecisionTreeClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

dataset = load_breast_cancer()
X, y = dataset.data, dataset.target
Xtrn, Xtst, ytrn, ytst = train_test_split(X, y, test_size=0.1, random_state=42)

clf = BaggingClassifier(
    estimator=DecisionTreeClassifier(max_depth=3),
    max_features=1,
    oob_score=True,
    random_state=42
)
clf.fit(Xtrn, ytrn)
print(accuracy_score(ytst, clf.predict(Xtst))) # 0.9825#Link to this headingRandom Forest
Random Forest adalah ensemble dari randomized decision trees dengan ekstensi khusus dari bagging.
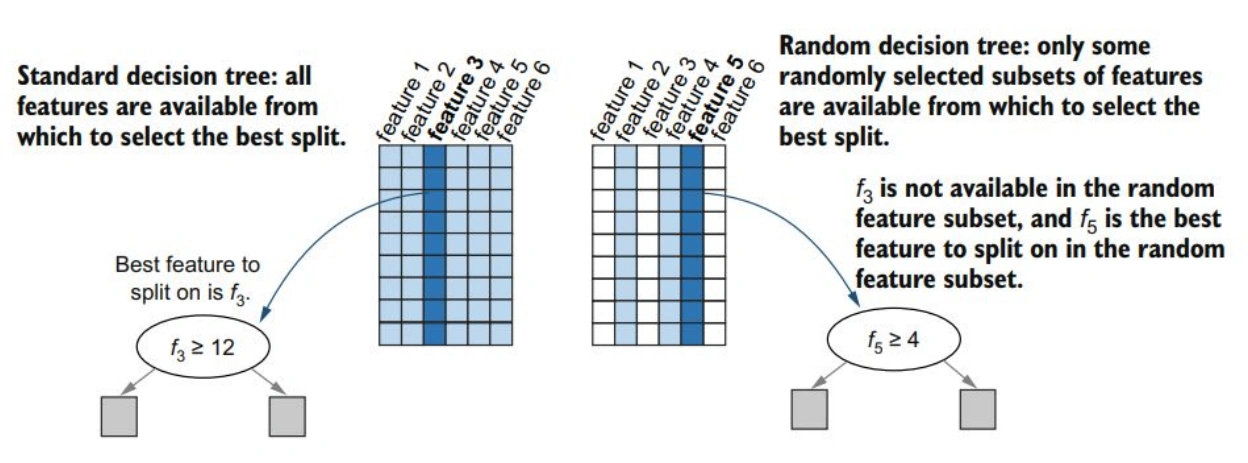
Masalah Bagging: Fitur-fitur dominan yang sama berulang kali digunakan di tree yang berbeda, sehingga ensemble kurang diverse.
Solusi Random Forest: Secara acak melakukan sampling fitur sebelum membuat setiap decision node.
from sklearn.ensemble import RandomForestClassifier

clf = RandomForestClassifier(
    max_features=10,
    max_depth=5,
    oob_score=True,
    random_state=42
)
clf.fit(Xtrn, ytrn)
print(accuracy_score(ytst, clf.predict(Xtst)))  # 0.9649
Keunggulan Random Forest:
- Salah satu metode paling akurat dan cepat, tidak tergantung sifat dataset.
- Cocok untuk dataset berukuran medium hingga besar.
- Bekerja saat atau ketika jumlah fitur () lebih besar dari jumlah observasi (), karena tidak semua fitur digunakan sekaligus.
#Link to this headingHeterogeneous Parallel Ensembles
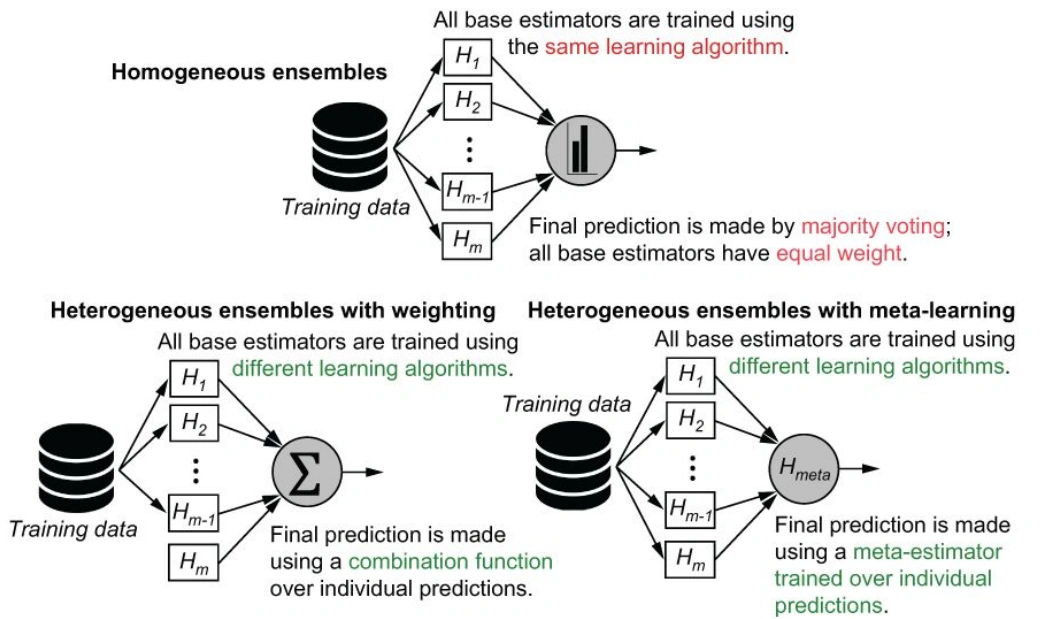
Heterogeneous: base learners menggunakan algoritma ML yang berbeda-beda.
#Link to this headingHeterogeneous Ensembles with Weighting
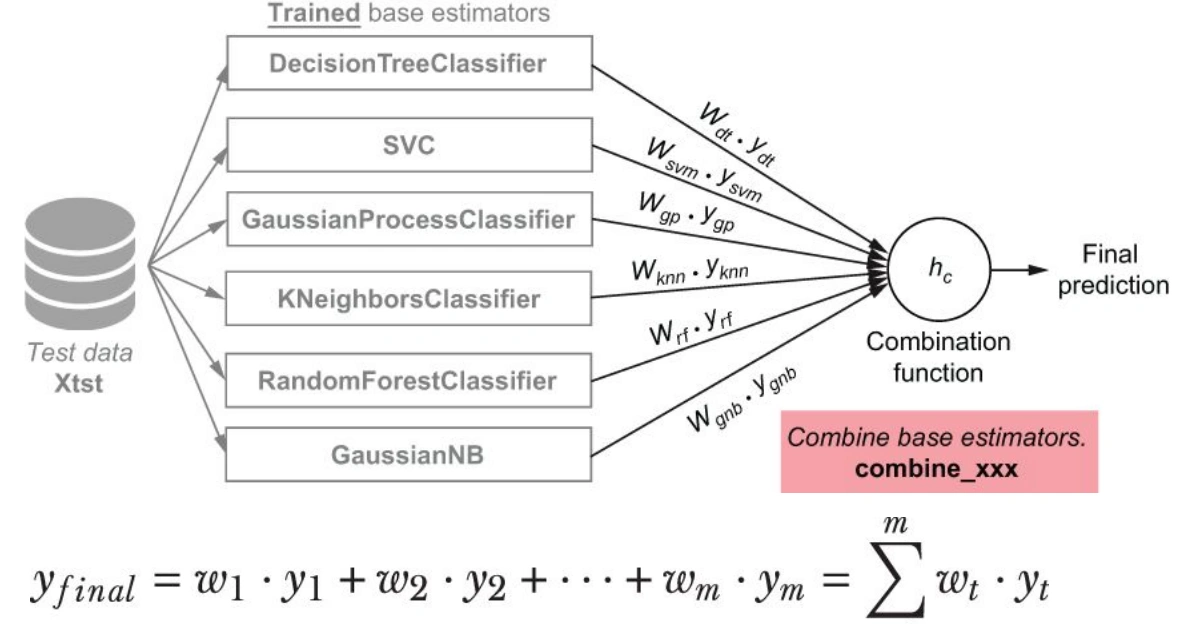
Setiap base classifier diberi bobot berdasarkan performanya (e.g., validation accuracy).
Hard Voting:
Soft Voting:
Contoh Accuracy Weighting:
| Base Classifier | Validation Accuracy | Bobot |
|---|---|---|
| 3NN Classifier | ||
| NB Classifier |
Prediksi untuk instance :
clf1.predict(x) = 1danclf2.predict(x) = 0- Hard:
clf1.predict_proba(x) = [0.4, 0.6]danclf2.predict_proba(x) = [0.6, 0.4]- Soft:
#Link to this headingHeterogeneous Ensembles with Meta-Learning (Stacking)
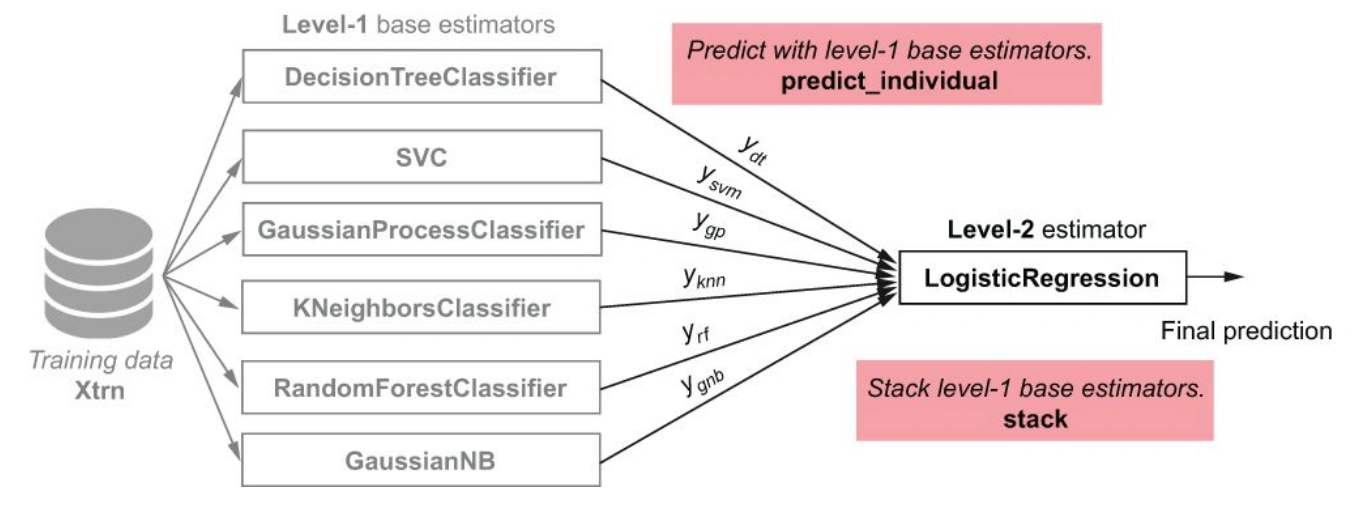
Stacking menggunakan arsitektur berlapis:
- Level 1: Beberapa base estimators dilatih secara independen dan menghasilkan prediksi.
- Level 2 (Meta-learner): Model baru dilatih menggunakan output prediksi Level 1 sebagai input features, belajar menggabungkan prediksi secara optimal.
Stacking dapat diperluas menjadi multi-layer stacking dengan lebih dari 2 level.
#Link to this headingSequential Ensembles
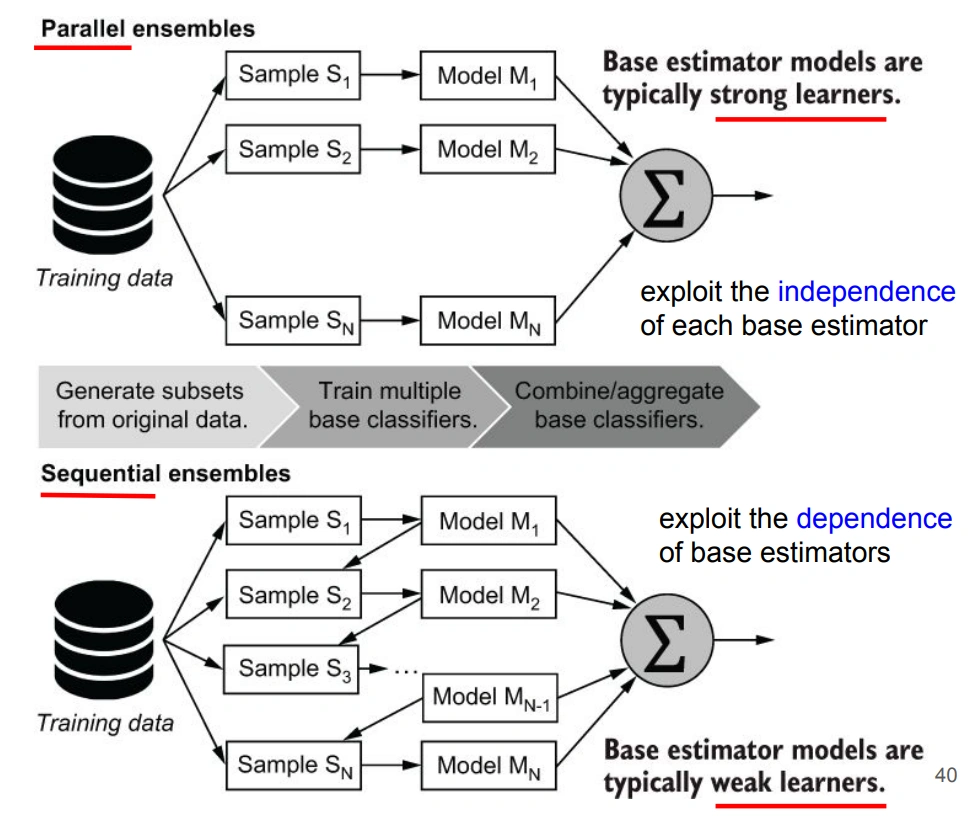
Sequential ensembles memanfaatkan dependensi antar base estimators, setiap model dilatih untuk memperbaiki kesalahan model sebelumnya.
#Link to this headingBoosting
Sequential ensemble bertujuan menggabungkan beberapa weak learners menjadi satu strong learner.
- Weak learner = model sederhana dengan performa sedikit lebih baik dari random chance.
- Decision stumps (decision tree depth 1) sering digunakan sebagai base estimator.
- Metode utama: AdaBoost dan Gradient Boosting.
#Link to this headingAdaBoost (Adaptive Boosting)
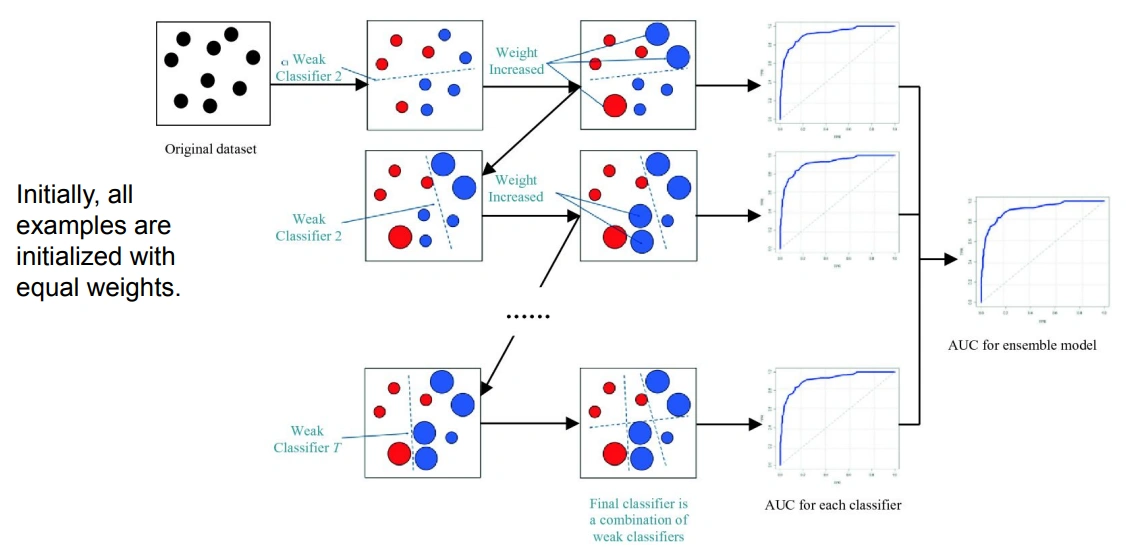
AdaBoost adalah algoritma adaptif: setiap iterasi melatih base estimator baru yang memperbaiki kesalahan dengan cara memprioritaskan misclassified training examples.
Training (Kunapuli, 2023):
- Inisialisasi semua instance dengan bobot yang sama:
- Untuk setiap iterasi :
- Latih weak learner menggunakan weighted dataset
- Hitung training error:
- Hitung model weight:
- Update instance weights:
- Correctly classified:
- Misclassified:
Contoh Weak Learner Weights:
| Iterasi | Training Accuracy | Error | Model Weight |
|---|---|---|---|
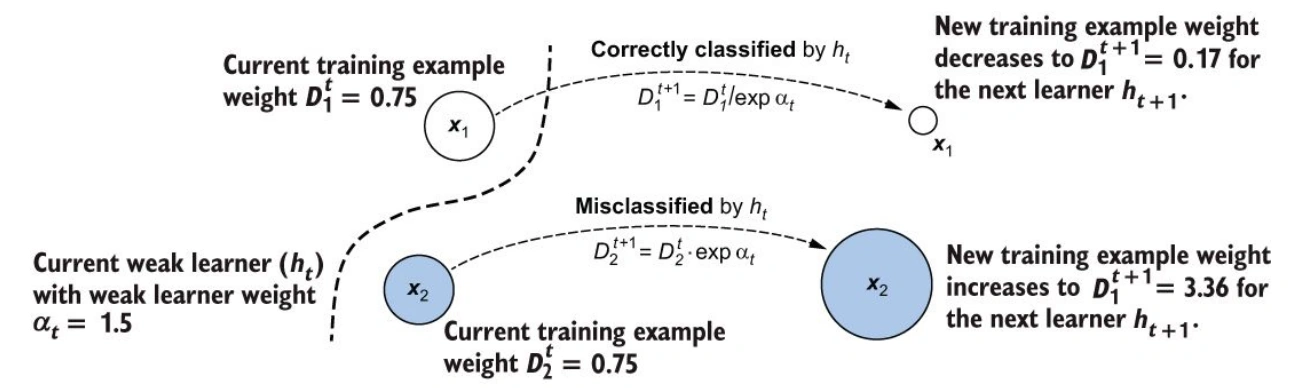
Contoh Update Instance Weights:
Misalkan , :
- (benar):
- (salah):
Inference:
Di mana mengembalikan atau .
#Link to this headingGradient Boosting
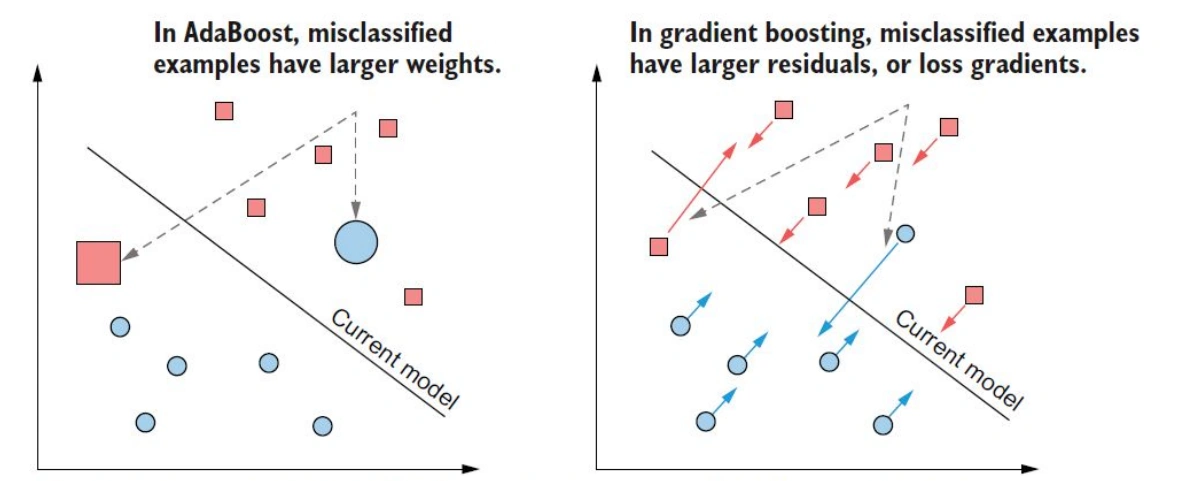
Gradient Boosting = Gradient Descent + Boosting. Setiap iterasi secara aditif meng-update model dengan gradient information.
Konsep Kunci: Residual adalah Negative Gradient:
Untuk squared loss function :
Residual adalah negative gradient dari loss function → melatih weak learner pada residual setara dengan gradient descent pada model space.
Training:
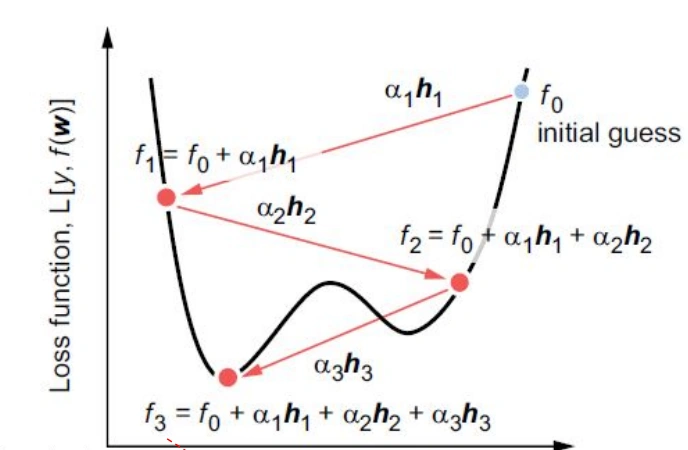
- Inisialisasi model dengan prediksi konstan (e.g., rata-rata ).
- Untuk setiap iterasi :
- Hitung residual (negative gradient):
- Latih weak learner untuk memprediksi residual tersebut.
- Update model:
Inference:
from sklearn.ensemble import GradientBoostingClassifier

gb = GradientBoostingClassifier(
    n_estimators=100,
    learning_rate=0.1,
    max_depth=3,
    random_state=42
)
gb.fit(X_train, y_train)
Contoh XGBoost pada Prediksi Usia:
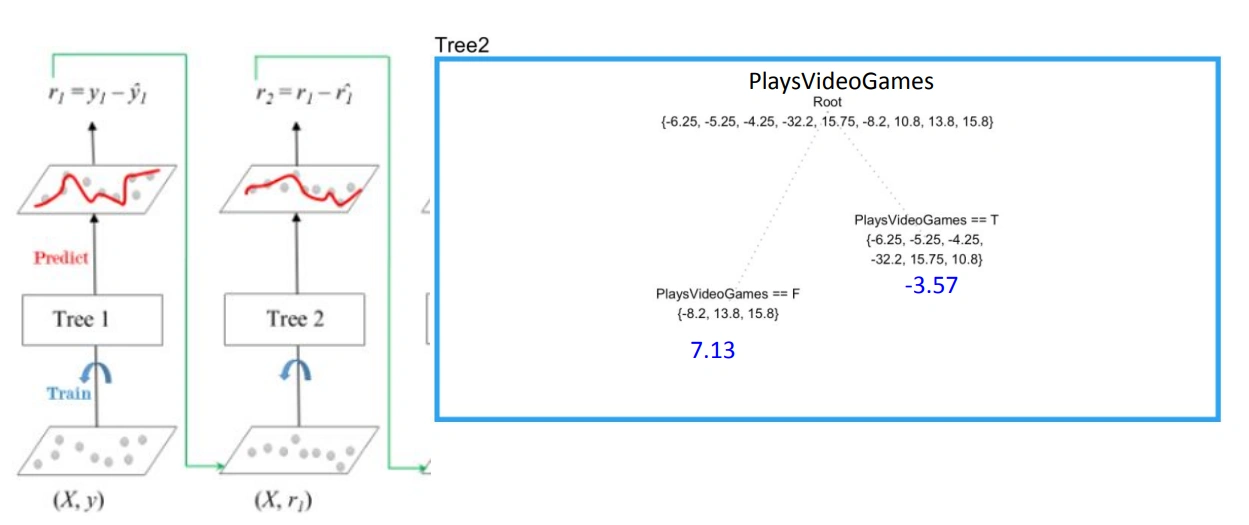
XGBoost adalah implementasi Gradient Boosting yang sangat dioptimalkan. Setiap iterasi membangun tree baru yang memprediksi residual dari tree sebelumnya, sehingga prediksi gabungan semakin mendekati nilai target.
#Link to this headingRingkasan
| Metode | Tipe | Diversity | Aggregation | Catatan |
|---|---|---|---|---|
| Bagging | Homogeneous, Parallel | Bootstrap sampling | Majority voting / Averaging | OOB score built-in |
| Random Forest | Homogeneous, Parallel | Bootstrap + Random subspace | Majority voting / Averaging | bekerja |
| Weighting | Heterogeneous, Parallel | Algoritma berbeda | Weighted voting (hard/soft) | |
| Stacking | Heterogeneous, Parallel | Algoritma berbeda | Meta-learner | Multi-layer dimungkinkan |
| AdaBoost | Homogeneous, Sequential | Re-weighting instances | Weighted | Weak → Strong learner |
| Gradient Boosting | Homogeneous, Sequential | Fitting residuals | Additive model | Residual = Negative Gradient |