Convolutional Neural Network
Convolutional Neural Network (CNN) adalah jenis artificial neural network yang menggunakan operasi konvolusi (bukan perkalian matriks umum) pada setidaknya satu layer-nya. CNN dirancang khusus untuk data dengan topologi seperti grid (grid-like topology), seperti gambar.
#Link to this headingWhy CNN?
#Link to this headingAI, Machine Learning, dan Deep Learning
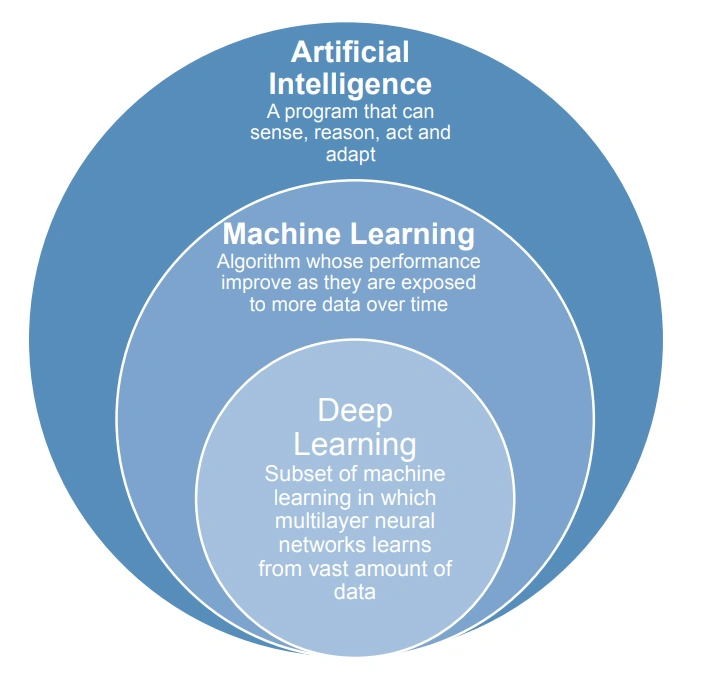
- Artificial Intelligence: program yang dapat merasakan, bernalar, bertindak, dan beradaptasi.
- Machine Learning: algoritma yang performanya meningkat seiring lebih banyak data.
- Deep Learning: subset ML di mana jaringan saraf berlapis banyak belajar dari data dalam jumlah besar.
Deep Learning sekarang berkembang pesat karena tiga faktor: dataset yang lebih besar, hardware yang lebih baik (biaya per GB turun dari $1000 (1995) ke $0.02 (2017)), dan algoritma yang lebih cerdas.
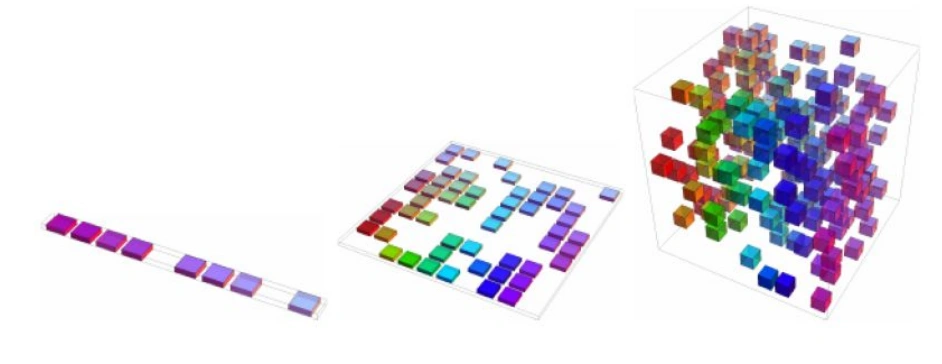
#Link to this headingCurse of Dimensionality
Jumlah konfigurasi yang mungkin terjadi meningkat secara eksponensial seiring bertambahnya jumlah variabel/fitur. Ini menjadi masalah besar saat memproses gambar beresolusi tinggi dengan ANN biasa.
#Link to this headingUniversal Approximator Theorem
Satu hidden layer sudah cukup untuk merepresentasikan fungsi apapun, tetapi tidak efisien untuk mempelajarinya:
- Shallow network mungkin membutuhkan lebar yang eksponensial
- Shallow network lebih mudah overfit
Model yang lebih dalam (deeper) memberikan generalisasi lebih baik dibanding model yang lebih lebar (shallower) dengan jumlah parameter yang sama.
#Link to this headingJenis-Jenis Model Deep Learning
| Model | Kegunaan Utama |
|---|---|
| Convolutional NN (CNN) | Visi komputer, klasifikasi gambar |
| Recurrent NN (RNN) | Data sekuensial, teks, time-series |
| Transformers | NLP, terjemahan, generasi teks |
| Generative Adversarial Network (GAN) | Generasi gambar sintetis |
| Autoencoder | Kompresi, denoising, deteksi anomali |
#Link to this headingSejarah CNN
CNN memiliki lima era perkembangan:
- Asal-usul: terinspirasi dari korteks visual biologis
- Stagnansi: kesulitan training (vanishing gradient, kurangnya data)
- Kebangkitan: AlexNet (2012) menang ImageNet Challenge
- Kebangkitan CNN: inovasi arsitektur pesat (VGG, GoogLeNet, ResNet)
- Akselerasi pesat: CNN menjadi algoritma deep learning paling luas digunakan
#Link to this headingCNN adalah ANN
CNN tetap merupakan ANN dengan:
- Layer: input, hidden, output
- Forward propagation: menghitung output
- Neuron dengan learnable weights dan bias
- Learning algorithm: backpropagation
Perbedaannya: CNN menggunakan operasi konvolusi (bukan perkalian matriks umum) di beberapa layer-nya, dengan local connectivity dan parameter sharing.
#Link to this headingTantangan ANN untuk Klasifikasi Gambar
ANN tradisional menghadapi dua masalah utama saat digunakan untuk klasifikasi gambar:
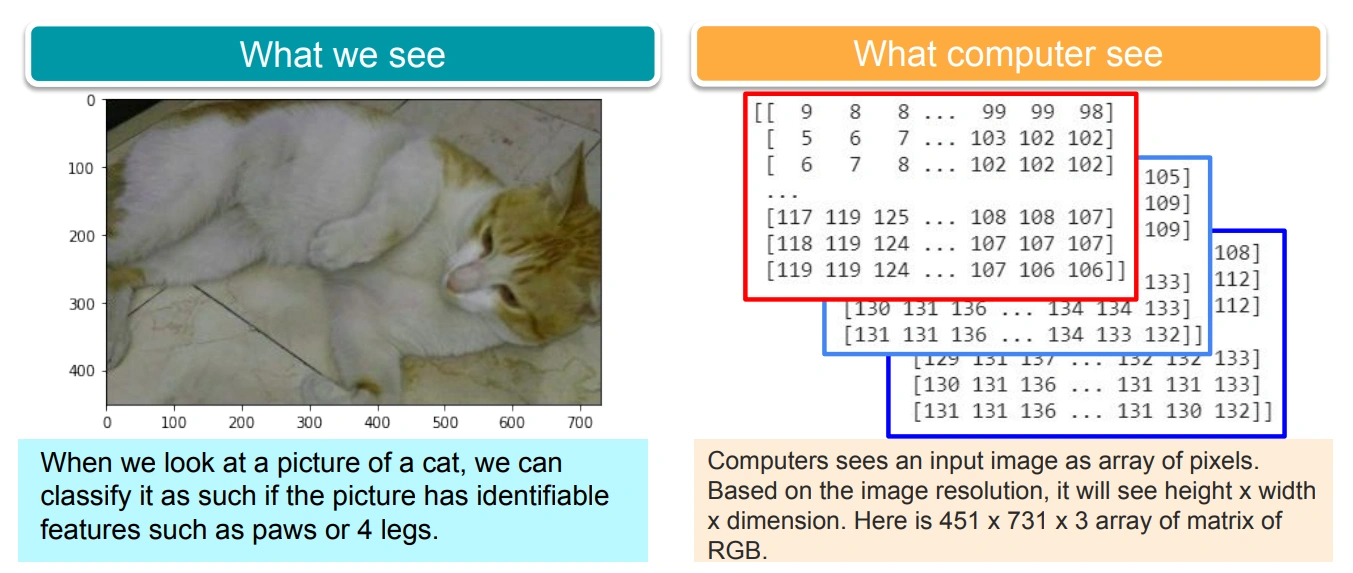
- Jumlah parameter sangat besar: Setiap piksel menjadi input terpisah. Gambar 224×224×3 menghasilkan ~150.000 input, jumlah parameter explodes.
- Kehilangan fitur spasial: Proses flattening n-dimensi ke 1-dimensi menghilangkan informasi tata letak spasial yang penting.
#Link to this headingMengapa CNN Unggul?
| Aspek | ANN | CNN |
|---|---|---|
| Ekstraksi fitur spasial | Tidak bisa (flattening) | Ya, otomatis melalui kernel |
| Skalabilitas untuk gambar | Tidak (param explosion) | Ya (local connectivity + param sharing) |
| Generalisasi | Lebih mudah overfit | Lebih baik |
| Feature extraction | Manual (perlu feature engineering) | Otomatis (kernel dipelajari selama training) |
#Link to this heading02: Local Connectivity & Parameter Sharing
#Link to this headingDampak terhadap Akurasi (LeCun, 1989)
Eksperimen LeCun (1989) pada data tulisan tangan menunjukkan dampak signifikan dari kedua teknik ini:
| Arsitektur | Akurasi | Jumlah Bobot |
|---|---|---|
| FFNN biasa | 87,0% | 3.240 |
| Locally connected (tanpa sharing) | 88,5% | 1.226 |
| Local + weight sharing | 98,4% | 1.060 |
Local connectivity + parameter sharing memberikan akurasi jauh lebih tinggi sekaligus jumlah parameter lebih sedikit.
#Link to this headingLocal/Sparse Connectivity
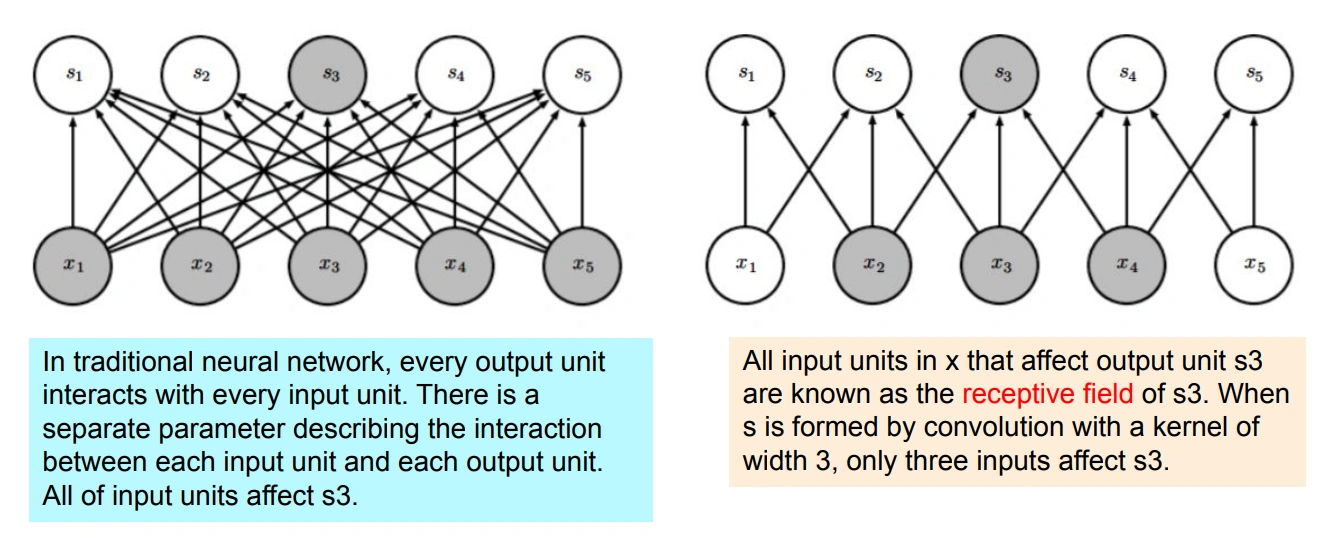
Pada ANN: setiap output unit berinteraksi dengan semua input unit, setiap pasangan input-output memiliki parameter tersendiri.
Pada CNN: setiap output unit hanya berinteraksi dengan sebagian kecil input unit melalui receptive field. Contoh: dengan kernel lebar 3 hanya bergantung pada .
#Link to this headingInspirasi Biologis: Receptive Field
Hubel & Wiesel (1959) menemukan bahwa sel-sel pada korteks visual hanya sensitif terhadap area visual tertentu (receptive field), dan semua neuron ini terorganisasi dalam arsitektur kolumnar yang bersama-sama menghasilkan persepsi visual.

Untuk data berbentuk grid (gambar), setiap neuron pada CNN merespons kernel 3×3 piksel di sekitar posisinya, mengikuti prinsip receptive field ini.
#Link to this headingOperasi Konvolusi: Tanpa Parameter Sharing
Tanpa parameter sharing, setiap posisi dalam feature map memiliki kernel tersendiri. Contoh: input , kernel :
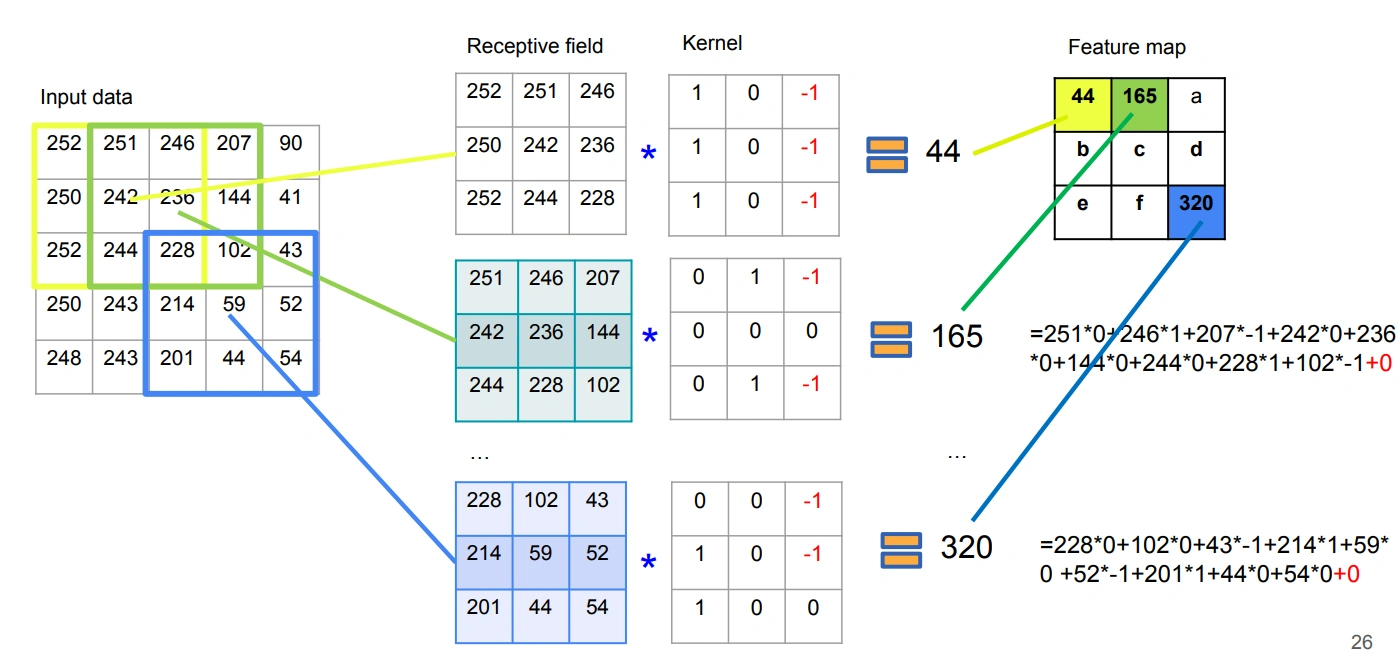
Contoh perhitungan (kernel di posisi tertentu):
Jumlah bobot (tanpa sharing):
Untuk 9 neuron output, filter : bobot.
#Link to this headingOperasi Konvolusi: Dengan Parameter Sharing
Dengan parameter sharing, satu kernel yang sama digeser ke seluruh posisi spasial input:
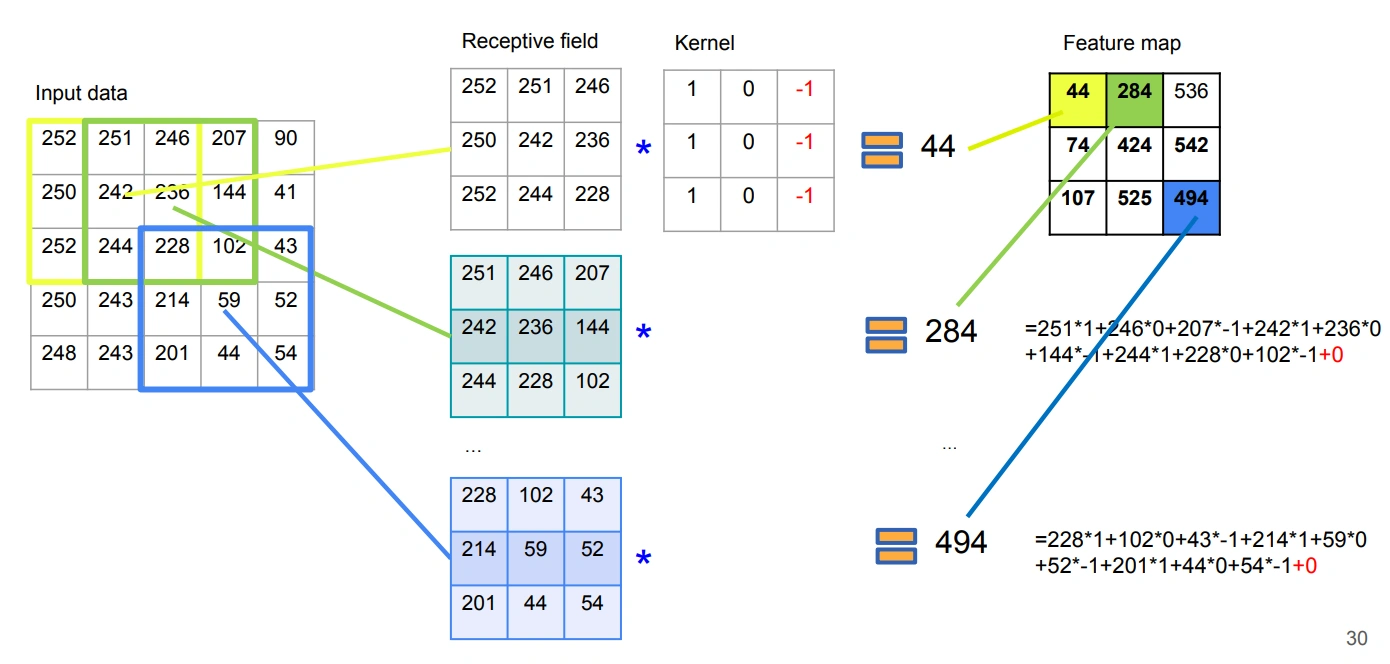
Contoh perhitungan (kernel ):
Jumlah bobot (dengan sharing):
Untuk 1 feature map, filter : bobot.
#Link to this headingParameter Sharing: Formula Lengkap
| Kondisi | Formula | Contoh (Net3, filter 3×3 ke 8×8 output, filter 5×5 ke 4×4 output) |
|---|---|---|
| Tanpa sharing | ||
| Dengan sharing |
Di mana = ukuran filter, = kedalaman input, = jumlah filter/kernel.
#Link to this headingEfisiensi Komputasi
Perbandingan deteksi tepi pada gambar dengan kernel :
| Metode | Jumlah Operasi |
|---|---|
| FFNN (matrix multiplication) | |
| Konvolusi kernel |
Konvolusi sekitar 60.000× lebih efisien dibanding FFNN untuk task yang sama.
#Link to this headingConvolutional Layer
#Link to this headingTerminologi
Satu convolutional layer (terminologi kompleks) terdiri dari tiga tahap yang bekerja berurutan:
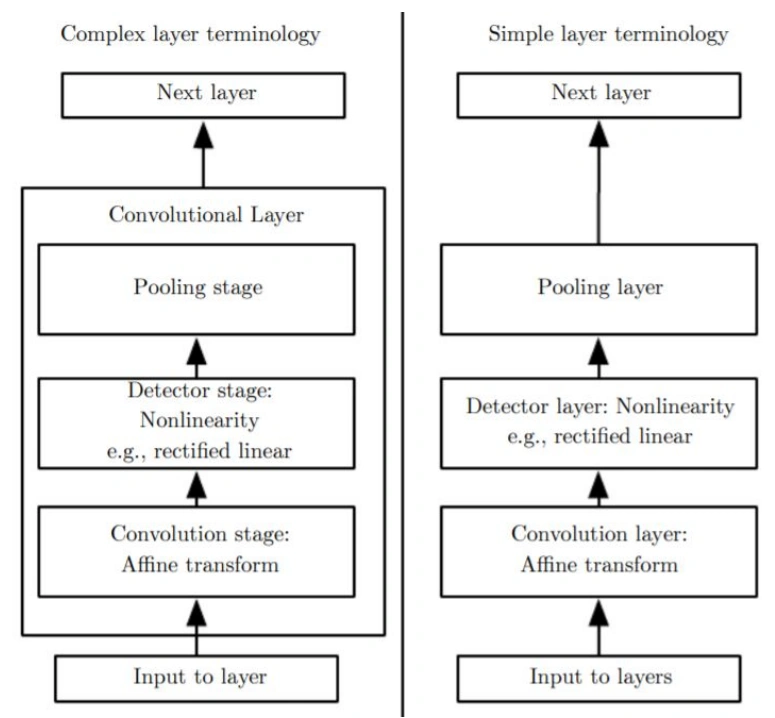
| Terminologi | Struktur |
|---|---|
| Complex layer | Conv + Detector + Pooling = 1 layer |
| Simple layer | Conv, Detector, Pooling = 3 layer terpisah |
#Link to this headingTahap Konvolusi (Convolution Stage)
Kernel bergerak melintasi input sehingga semua area tercakup. Kernel mengekstrak fitur spasial dari input (tepi, tekstur, pola) dan hasilnya disebut feature map.
Stride dan Padding:
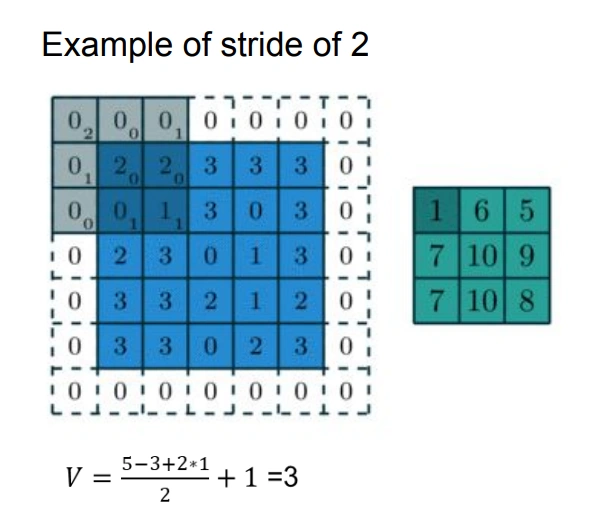
- Stride (): jumlah piksel yang dilompati kernel setiap langkah. Stride lebih besar menghasilkan output lebih kecil.
- Padding (): lapisan nol yang ditambahkan di tepi input. Padding = 1 dengan stride = 1 mempertahankan ukuran spatial output sama dengan input.
Rumus dimensi output:
Di mana: = lebar/tinggi input, = ukuran kernel, = padding, = stride.
Contoh 1: Input , filter , , :
Contoh 2: Input , filter , , :
Contoh 3: Input , filter , , :
Konvolusi multi-channel: Setiap kernel memiliki kedalaman sama dengan kedalaman input. Hasil konvolusi tiap channel dijumlahkan (bukan dipisah), lalu ditambah bias sehingga menghasilkan satu feature map per kernel.
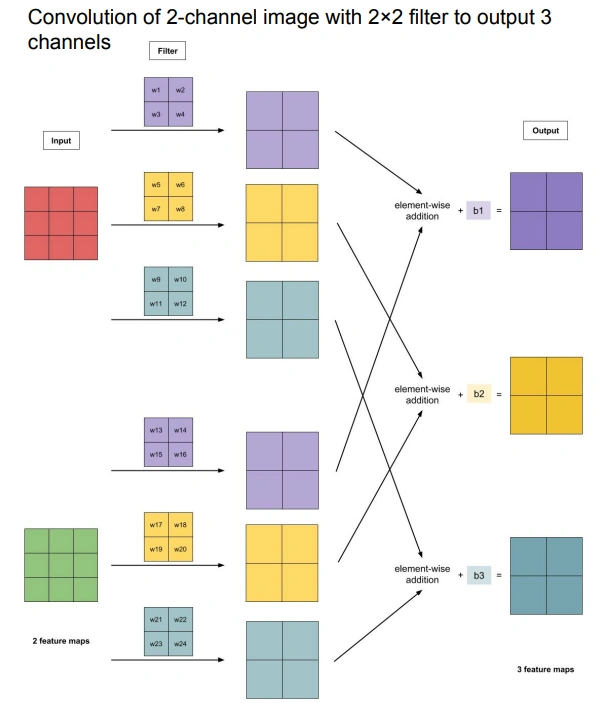
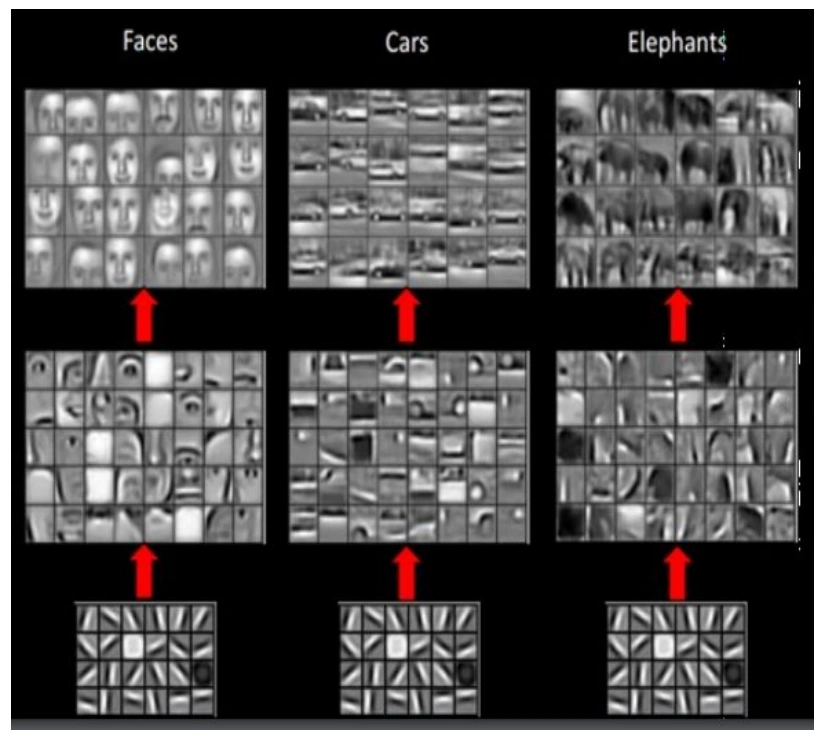
Multi-filter: Semakin banyak convolutional layer, semakin kompleks fitur yang diekstrak, layer awal menangkap tepi/warna, sedangkan layer dalam menangkap pola/objek abstrak.
#Link to this headingTahap Detector (Detector Stage)
Menerapkan fungsi aktivasi non-linear (biasanya ReLU) pada hasil konvolusi. Tujuan: memperkenalkan non-linearitas karena konvolusi hanyalah operasi linear.
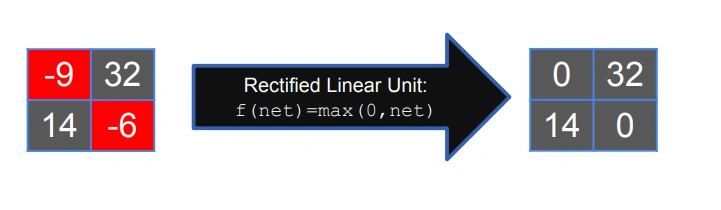
| Nilai Konvolusi | Setelah ReLU |
|---|---|
Di masa lalu digunakan tanh dan sigmoid, tetapi ReLU terbukti bekerja jauh lebih baik pada CNN modern.
#Link to this headingTahap Pooling (Pooling Stage)
Downsampling: mereduksi ukuran spasial feature map. Tujuan:
- Mengurangi jumlah parameter dan koneksi
- Mencegah overfitting
- Membuat representasi lebih robust terhadap pergeseran kecil
Jenis pooling: max pooling (paling umum), average pooling, L2-norm pooling.
Rumus dimensi output:
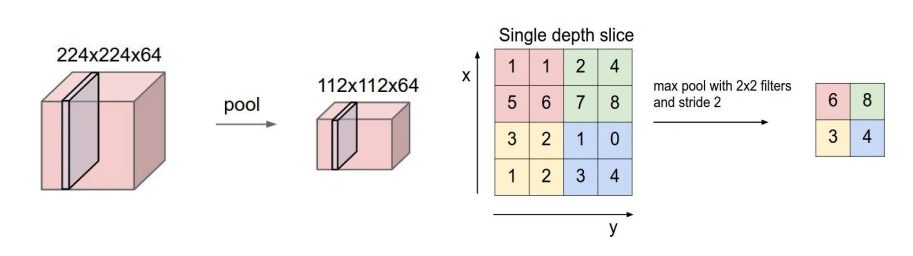
Contoh: Max pooling , stride=2 pada feature map menghasilkan output (setiap region non-overlap diambil nilai maksimumnya).
#Link to this headingCNN Architecture
#Link to this headingStruktur Umum
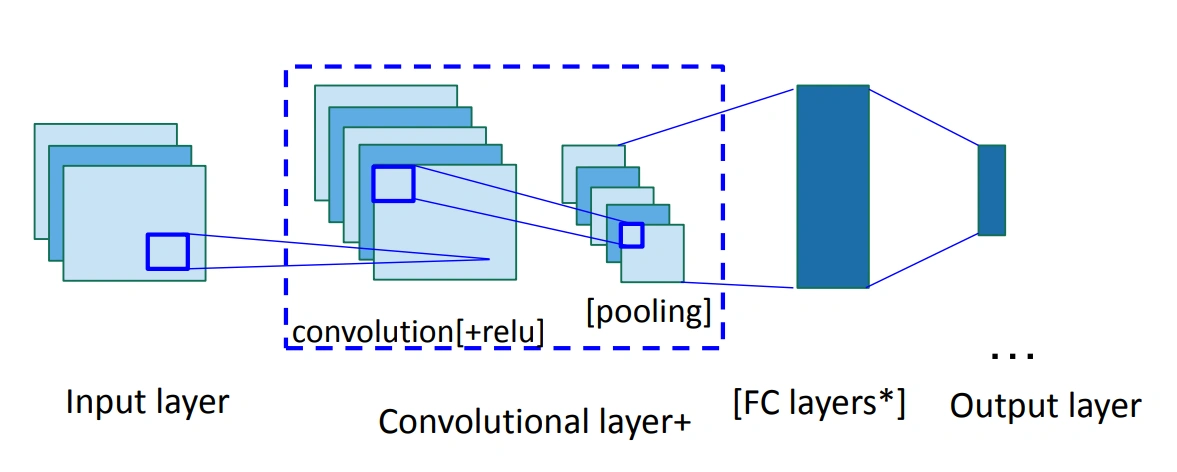
Input → [Conv + ReLU + Pooling]× → Flatten → [FC]× → OutputSetelah serangkaian convolutional layer, feature map di-flatten menjadi vektor 1D, kemudian diproses oleh fully connected (FC) layers untuk klasifikasi.
#Link to this headingFlattening
Flattening mengubah feature map multidimensi menjadi vektor 1D agar dapat diproses oleh FC layer.
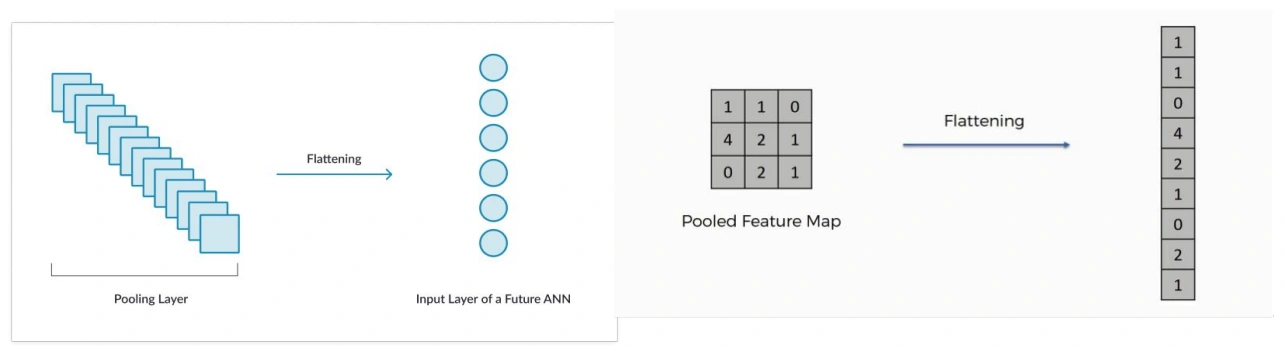
Contoh: Feature map diubah menjadi vektor panjang .
#Link to this headingContoh: LeNet-5 (LeCun, 1998)
LeNet-5 adalah arsitektur CNN awal untuk pengenalan digit tulisan tangan (MNIST).
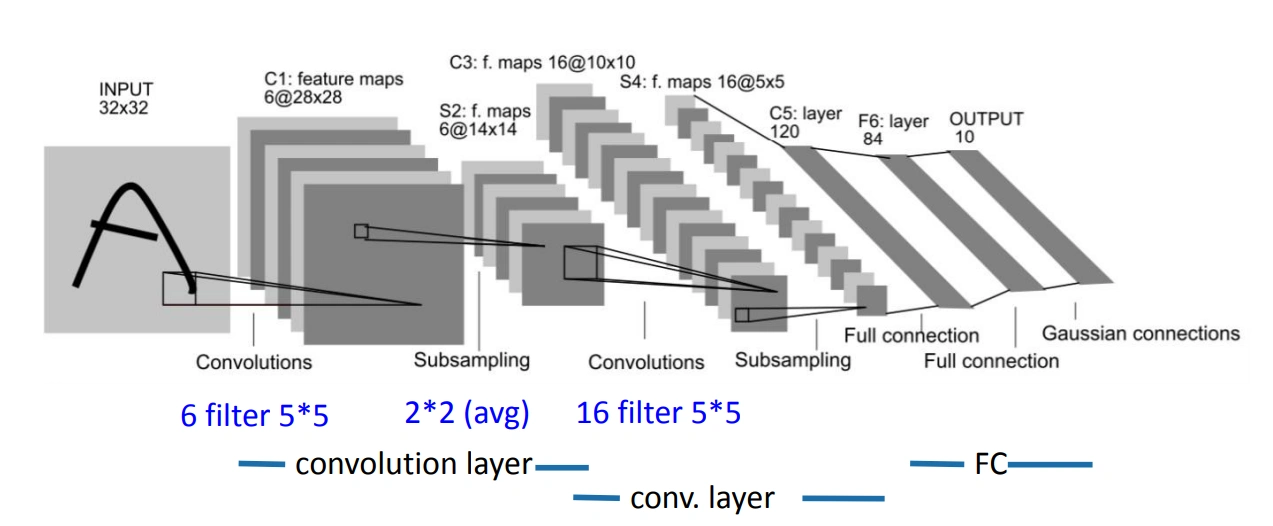
Layer C1: Convolution Stage:
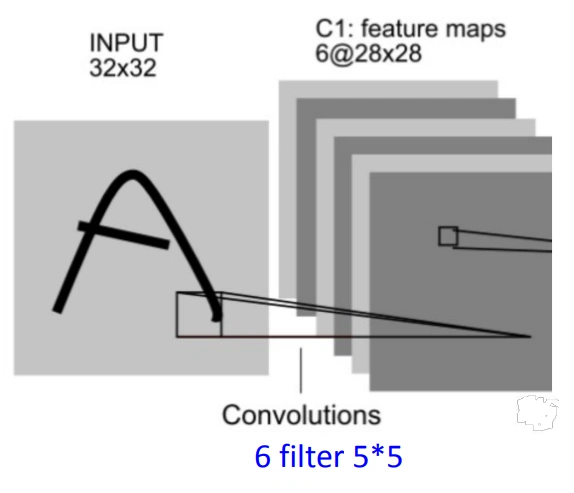
- filter , ,
- feature map
- Parameter:
- Koneksi:
Layer S2: Pooling Stage:
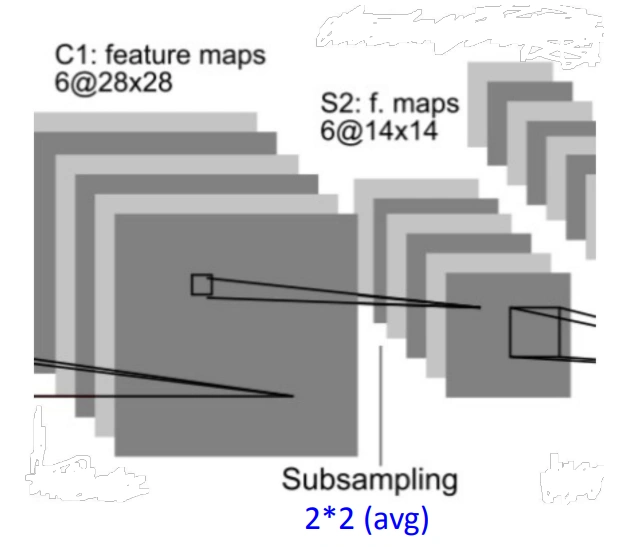
- Avg pool , , (non-overlapping)
- feature map
- Parameter: (Keras) / (metode LeCun, ada learnable scale+bias per channel)
- Koneksi:
Layer C3: Convolution Stage:
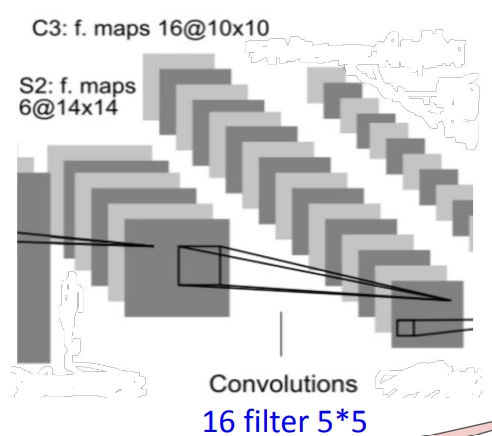
- filter , ,
- feature map
- Parameter (semua feature map):
- Parameter (subset LeCun, setiap filter menerima subset 3–4 dari 6 channel):
Ringkasan LeNet-5:
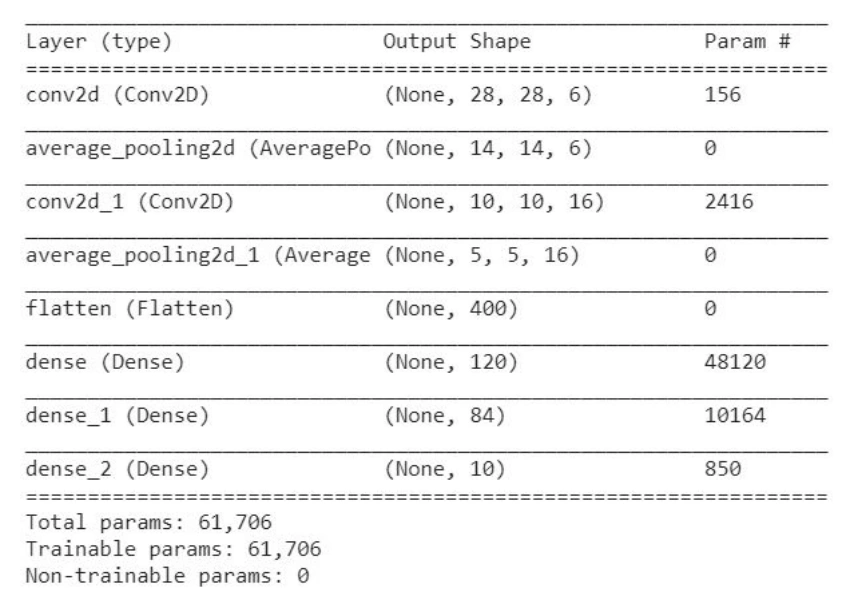
| Layer | Detail | Feature Map | #Param (Keras) |
|---|---|---|---|
| C1 (Conv) | 6 filter , , | ||
| S2 (Pool) | Avg pool , | ||
| C3 (Conv) | 16 filter , , | ||
| S4 (Pool) | Avg pool , | ||
| Flatten | |||
| FC (120) | |||
| FC (84) | |||
| Output (10) |
Implementasi (Keras):
from keras.models import Sequential
from keras import layers

model = Sequential()
model.add(layers.Conv2D(filters=6, kernel_size=(5,5), activation='relu', input_shape=(32,32,1)))
model.add(layers.AveragePooling2D(pool_size=(2,2)))
model.add(layers.Conv2D(filters=16, kernel_size=(5,5), activation='relu'))
model.add(layers.AveragePooling2D(pool_size=(2,2)))
model.add(layers.Flatten())
model.add(layers.Dense(units=120, activation='relu'))
model.add(layers.Dense(units=84, activation='relu'))
model.add(layers.Dense(units=10, activation='softmax'))#Link to this headingArsitektur Umum Lainnya
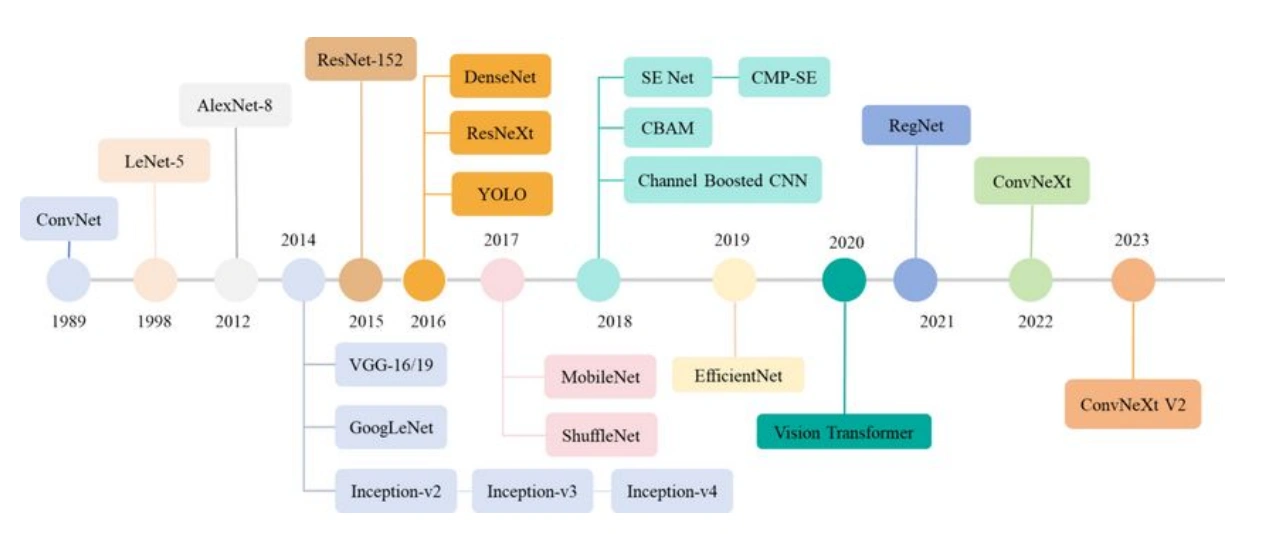
Perkembangan arsitektur CNN dari 1989 hingga sekarang: LeNet, AlexNet, VGG, GoogLeNet/Inception, ResNet, dan seterusnya.
#Link to this headingVGG16 (Simonyan & Zisserman, 2015)
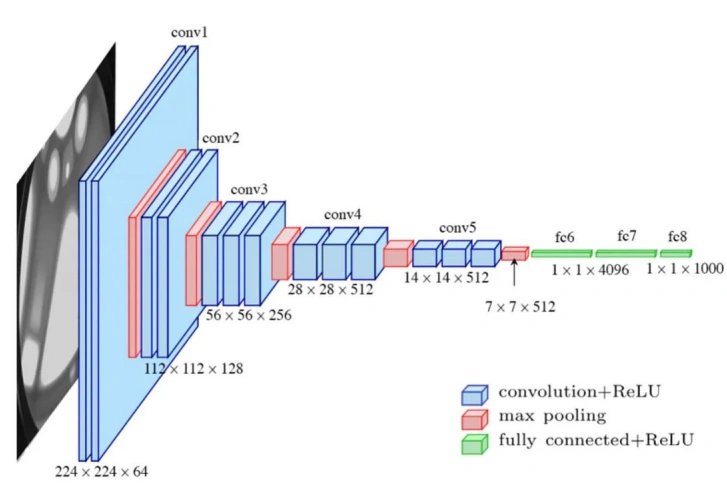
VGG16 menggunakan 13 conv layer berukuran (dengan padding=same untuk mempertahankan dimensi) dan 3 FC layer. Total: 138 juta parameter.
model = Sequential()
model.add(Conv2D(input_shape=(224,224,3), filters=64, kernel_size=(3,3),
                 padding="same", activation="relu"))
model.add(Conv2D(filters=64, kernel_size=(3,3), padding="same", activation="relu"))
model.add(MaxPool2D(pool_size=(2,2), strides=(2,2)))
model.add(Conv2D(filters=128, kernel_size=(3,3), padding="same", activation="relu"))
model.add(Conv2D(filters=128, kernel_size=(3,3), padding="same", activation="relu"))
model.add(MaxPool2D(pool_size=(2,2), strides=(2,2)))
# ... (dst: 256x3, 512x3, 512x3 conv blocks + 3 FC)#Link to this headingBackpropagation for CNN
Backpropagation CNN mengikuti prinsip yang sama dengan FFNN, tetapi menyesuaikan untuk operasi konvolusi, ReLU, dan max-pooling.
#Link to this headingGambaran Umum
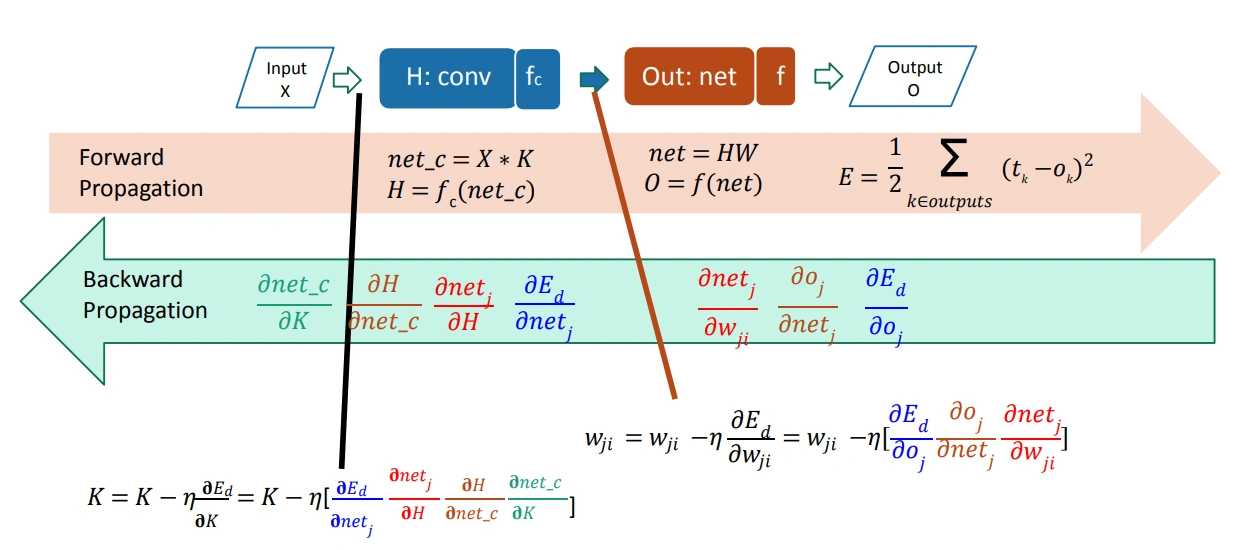
Forward propagation:
Update bobot kernel dan bobot FC :
#Link to this headingBackpropagation untuk ReLU
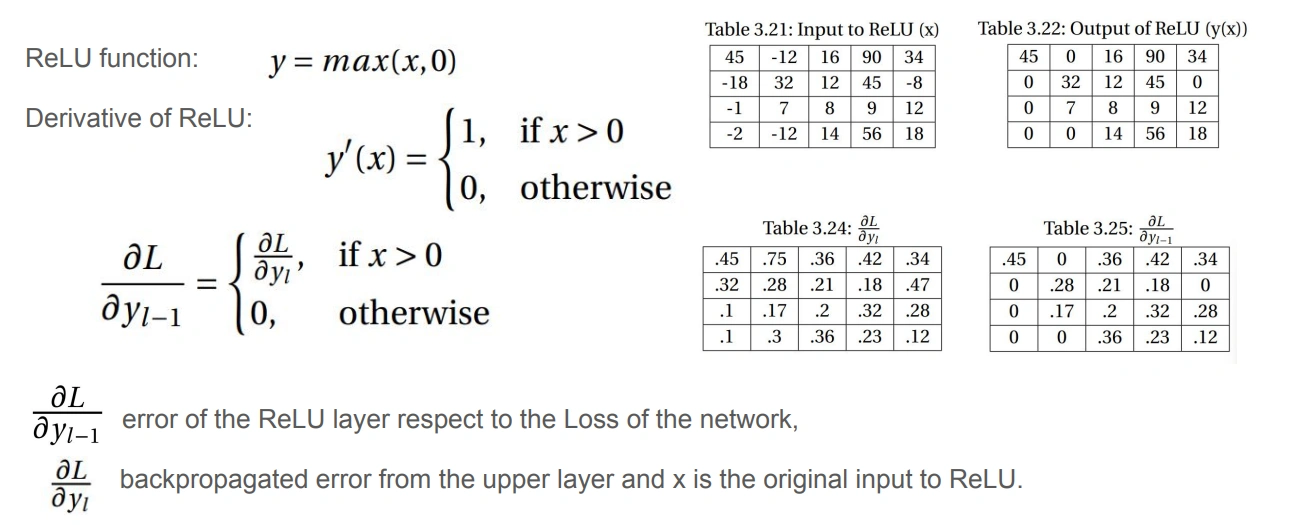
Turunan ReLU:
Error yang di-backprop melalui ReLU: diteruskan jika input aslinya > 0, dinolkan jika input aslinya ≤ 0.
#Link to this headingBackpropagation untuk Max-Pooling
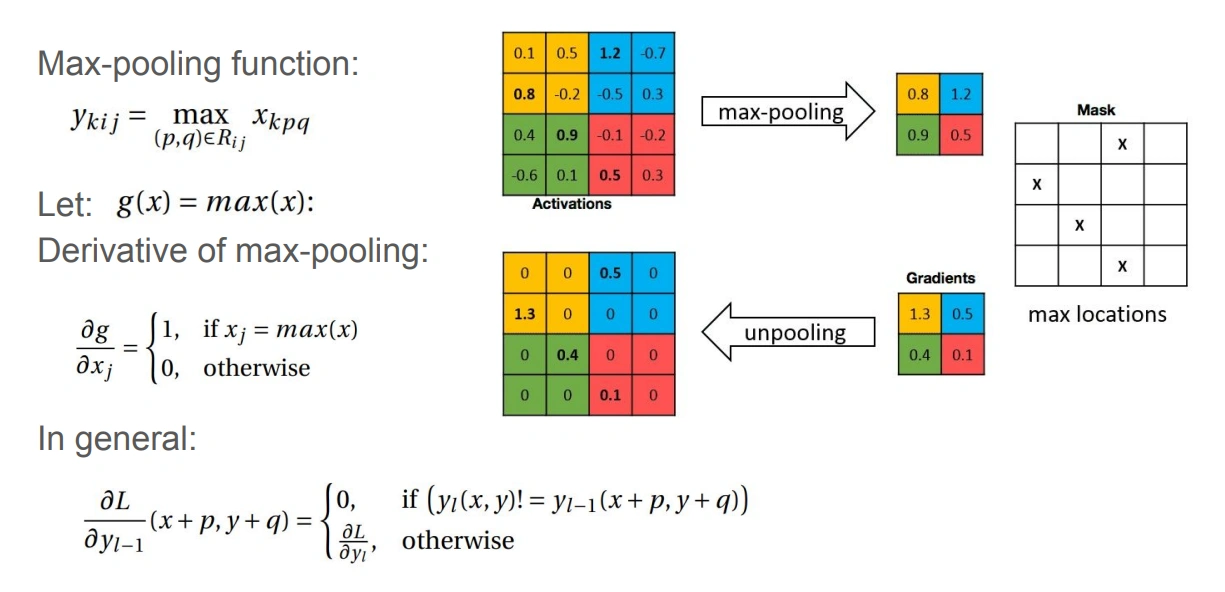
Max-pooling meneruskan gradient hanya ke posisi yang nilai-nya diambil (nilai maksimum dalam window). Posisi lain mendapat gradient = 0.
Ini diimplementasikan dengan argmax mask yang dicatat saat forward pass dan digunakan saat backward pass.
#Link to this headingContoh: Arsitektur CNN Lengkap
Untuk arsitektur: Input ReLU Flatten ReLU Softmax ke Output
Forward propagation:
Backward propagation dengan softmax + cross-entropy loss :
Di mana adalah probabilitas output softmax untuk kelas . Gradient ini kemudian di-backprop:
- Melalui FC layer :
- Melalui ReLU: masker berdasarkan tanda
- Melalui FC layer :
- Melalui flatten: reshape gradient
- Melalui max-pooling: masker argmax
- Melalui ReLU konvolusi: masker berdasarkan tanda
- Ke kernel :